在 Redis 3.0 之前,List 对象的底层数据结构是双向链表或者压缩列表,然后在 Redis 3.2 的时候,List 对象的底层改由 quicklist 数据结构实现。
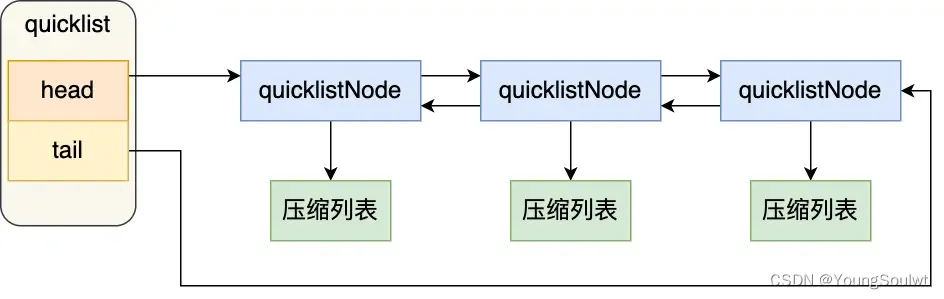
其实 quicklist 就是【双向链表 + 压缩列表】组合,因为一个 quicklist 就是一个链表,而链表中的每个元素又是一个压缩列表。
在前面讲压缩列表的时候,提到过压缩列表的不足,虽然压缩列表是通过紧凑型的内存布局节省了内存开销,但是因为它的结构设计,如果保存的元素数量增加,或者元素变大了,压缩列表会有【连锁更新】的风险,一旦发生,会造成性能下降。
quicklist 解决办法,通过控制每个链表节点中的压缩列表的大小或者元素个数,来规避连锁更新的问题,因为压缩列表元素越少或越小,连锁更新带来的影响就越小,从而提供了更好的访问性能。
1. quicklist 结构设计
quicklist 的结构体跟链表的结构体类似,都包含了表头和表尾,区别在于 quicklist 的节点是 quicklistNode。
typedef struct quicklist {
    // quicklist 的链表头
    quicklistNode *head;
    // quicklist 的链表尾
    quicklistNode *tail;
    // 所有压缩列表中的总元素个数
    unsigned long count;
    // quicklistNode 的个数
    unsigned long len;
    ...
} quicklist;
接下来,是quicklistNode 的结构定义:
typedef struct quicklistNode {
    // 前一个 quicklistNode
    struct quicklistNode *prev;
    // 下一个 quicklistNode
    struct quicklistNode *next;
    // quicklistNode 指向的压缩列表
    unsigned char *zl;
    // 压缩列表的字节大小
    unsigned int sz;
    // 压缩列表的元素个数
    unsigned int count : 16;
    ...
} quicklistNode;
可以看到,quicklistNode 结构体里包含了前一个节点和下一个节点指针,这样每个 quicklistNode 形成了一个 双向链表,但是链表节点的元素不再是单纯保存元素值,而是保存了一个压缩列表,所以 quicklistNode 结构体里有个指向压缩列表的指针 *zl。
如下:
在向 quicklist 添加一个元素的时候,不会像普通的链表那样,直接新建一个链表节点,而是会检查插入位置的压缩列表是否能容纳该元素,如果能容纳就直接保存到 quicklistNode 结构里的压缩列表,如果不能容纳,才会新建一个新的 quicklistNode 结构。
quicklist 会控制 quicklistNode 结构里的压缩列表的大小或者元素个数,来规避潜在的连锁更新的风险,但是这并没有完全解决连锁更新的问题。