使用Scala爬取安居客房产信息并存入CSV文件
本篇博客中,我们将介绍如何使用Scala语言编写一个简单的程序,来爬取安居客(Anjuke)网站上的房产信息,并将这些信息存储到CSV文件中。这个示例将涵盖HTTP请求、HTML解析、数据提取和文件写入等基本操作。
1. 简介
安居客是中国知名的房产信息平台,提供各地区房产的详细信息,包括房屋类型、面积、装修情况和价格等。本文示例以武汉江汉区为例,爬取前3页的房产信息。
2. 技术栈
Scala: 一种多范式编程语言,基于JVM运行,适合处理并发和数据操作。
Jsoup: 用于解析HTML和XML文档的Java库,方便从网页中提取数据。
scalaj-http: Scala中简单易用的HTTP客户端库,用于发送HTTP请求和接收响应。
3. 示例代码解析
1. 导入依赖和包声明
scala
package org.example.mysql2kafka2hdfs

import org.jsoup.Jsoup
import scalaj.http.Http
import scala.collection.JavaConverters._
import java.io.{BufferedWriter, FileWriter}
2. 主对象和主函数定义
scala
object AnjukeHouse {
  def main(args: Array[String]): Unit = {
    // 程序的主入口,从这里开始执行
  }
}
3. HTTP请求和HTML解析
scala
// 构建HTTP请求的headers
val headers: Map[String, String] = Map(
  // 这里包含了HTTP请求的headers,用于模拟浏览器行为 填写自己浏览器的请求头信息
)

// 构造url
val crawUrl = "https://wuhan.anjuke.com/sale/{region}/p{page}/"
val region = "jianghana"

// 创建一个空列表,用于存储数据
var houseList = List[Map[String, String]]()

for (page <- 1 to 3) {
  println(s"开始爬取第 $page 页")
  val url = crawUrl.replace("{region}", region).replace("{page}", page.toString)
  val response = Http(url).headers(headers).asString
  val html = response.body
  val soup = Jsoup.parse(html)

  // 解析HTML中的房屋信息
  val houses = soup.select("div.property-content").asScala

  for (house <- houses) {
    // 提取房屋信息的具体字段
    val title = house.select("h3.property-content-title-name").text().trim
    // 更多字段的提取,如户型、面积、装修、价格等
    // 将提取到的信息存储为Map,并添加到houseList列表中
  }
}
4. 数据处理和存储
scala
// 将解析后的数据写入CSV文件
val file = new BufferedWriter(new FileWriter("house.csv"))
file.write("title,house_type,area,decoration,price\n")
for (house <- houseList) {
  file.write(s"${house("title")},${house("house_type")},${house("area")},${house("decoration")},${house("price")}\n")
}
file.close()

println("数据已写入 house.csv 文件")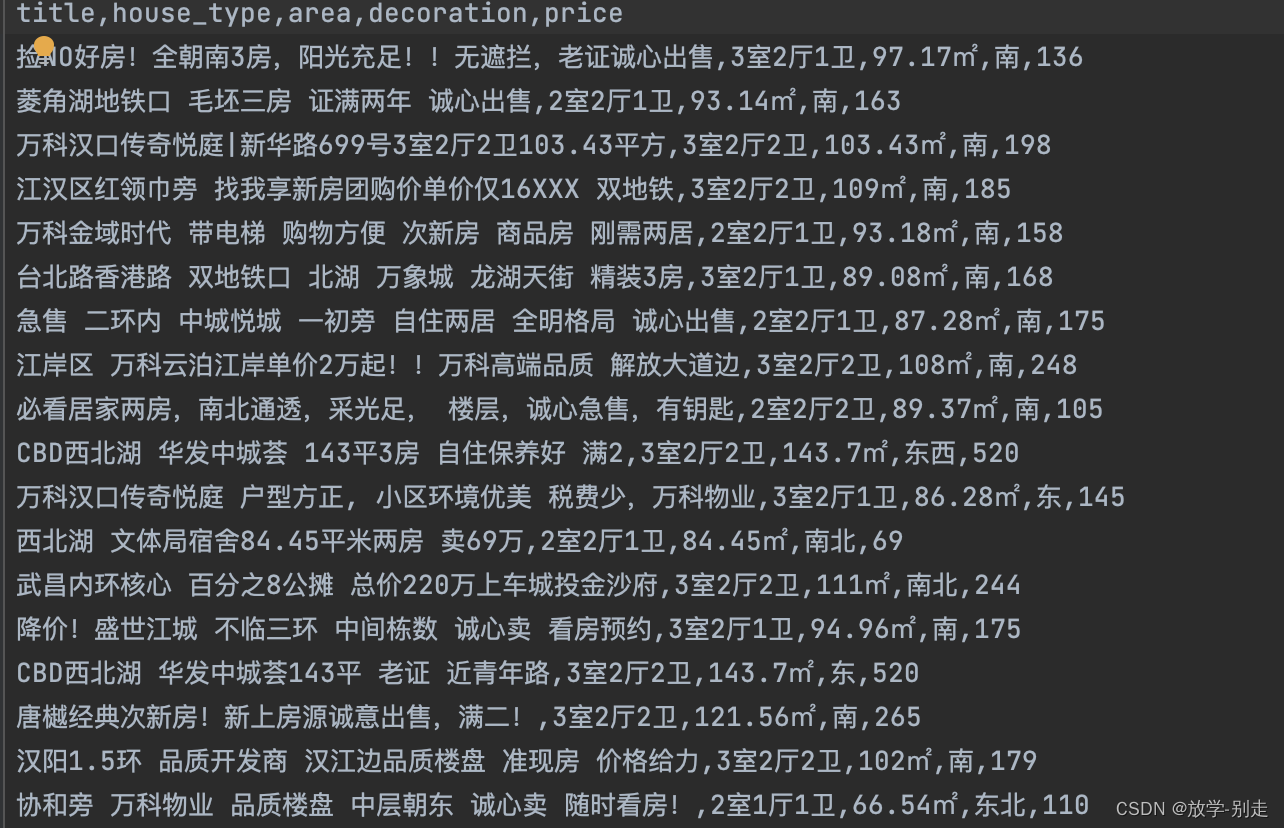
总结
这个Scala程序演示了如何使用HTTP请求和HTML解析库来构建一个简单的网络爬虫,用于从安居客网站上获取房产信息,并将这些信息存储到CSV文件中。
如有遇到问题可以找小编沟通交流哦。另外小编帮忙辅导大课作业,学生毕设等。不限于MapReduce, MySQL, python,java,大数据,模型训练等。 hadoop hdfs yarn spark Django flask flink kafka flume datax sqoop seatunnel echart可视化 机器学习等