一、概念说明
"ETL,是英文Extract-Transform-Load的缩写,用来描述将数据从来源端经过抽取(Extract)、转换(Transform)、加载(Load)至目的端的过程。ETL一词较常用在数据仓库,但其对象并不限于数据仓库
在运行核心业务MapReduce程序之前,往往要先对数据进行清洗,清理掉不符合用户要求的数据。
清理的过程往往只需要运行Mapper程序,不需要运行Reduce程序。
Java做过3年以上的,应该都知道,这就是过滤数据。
过滤数据,一般要用到正则表达式
二、需求说明
日志文件
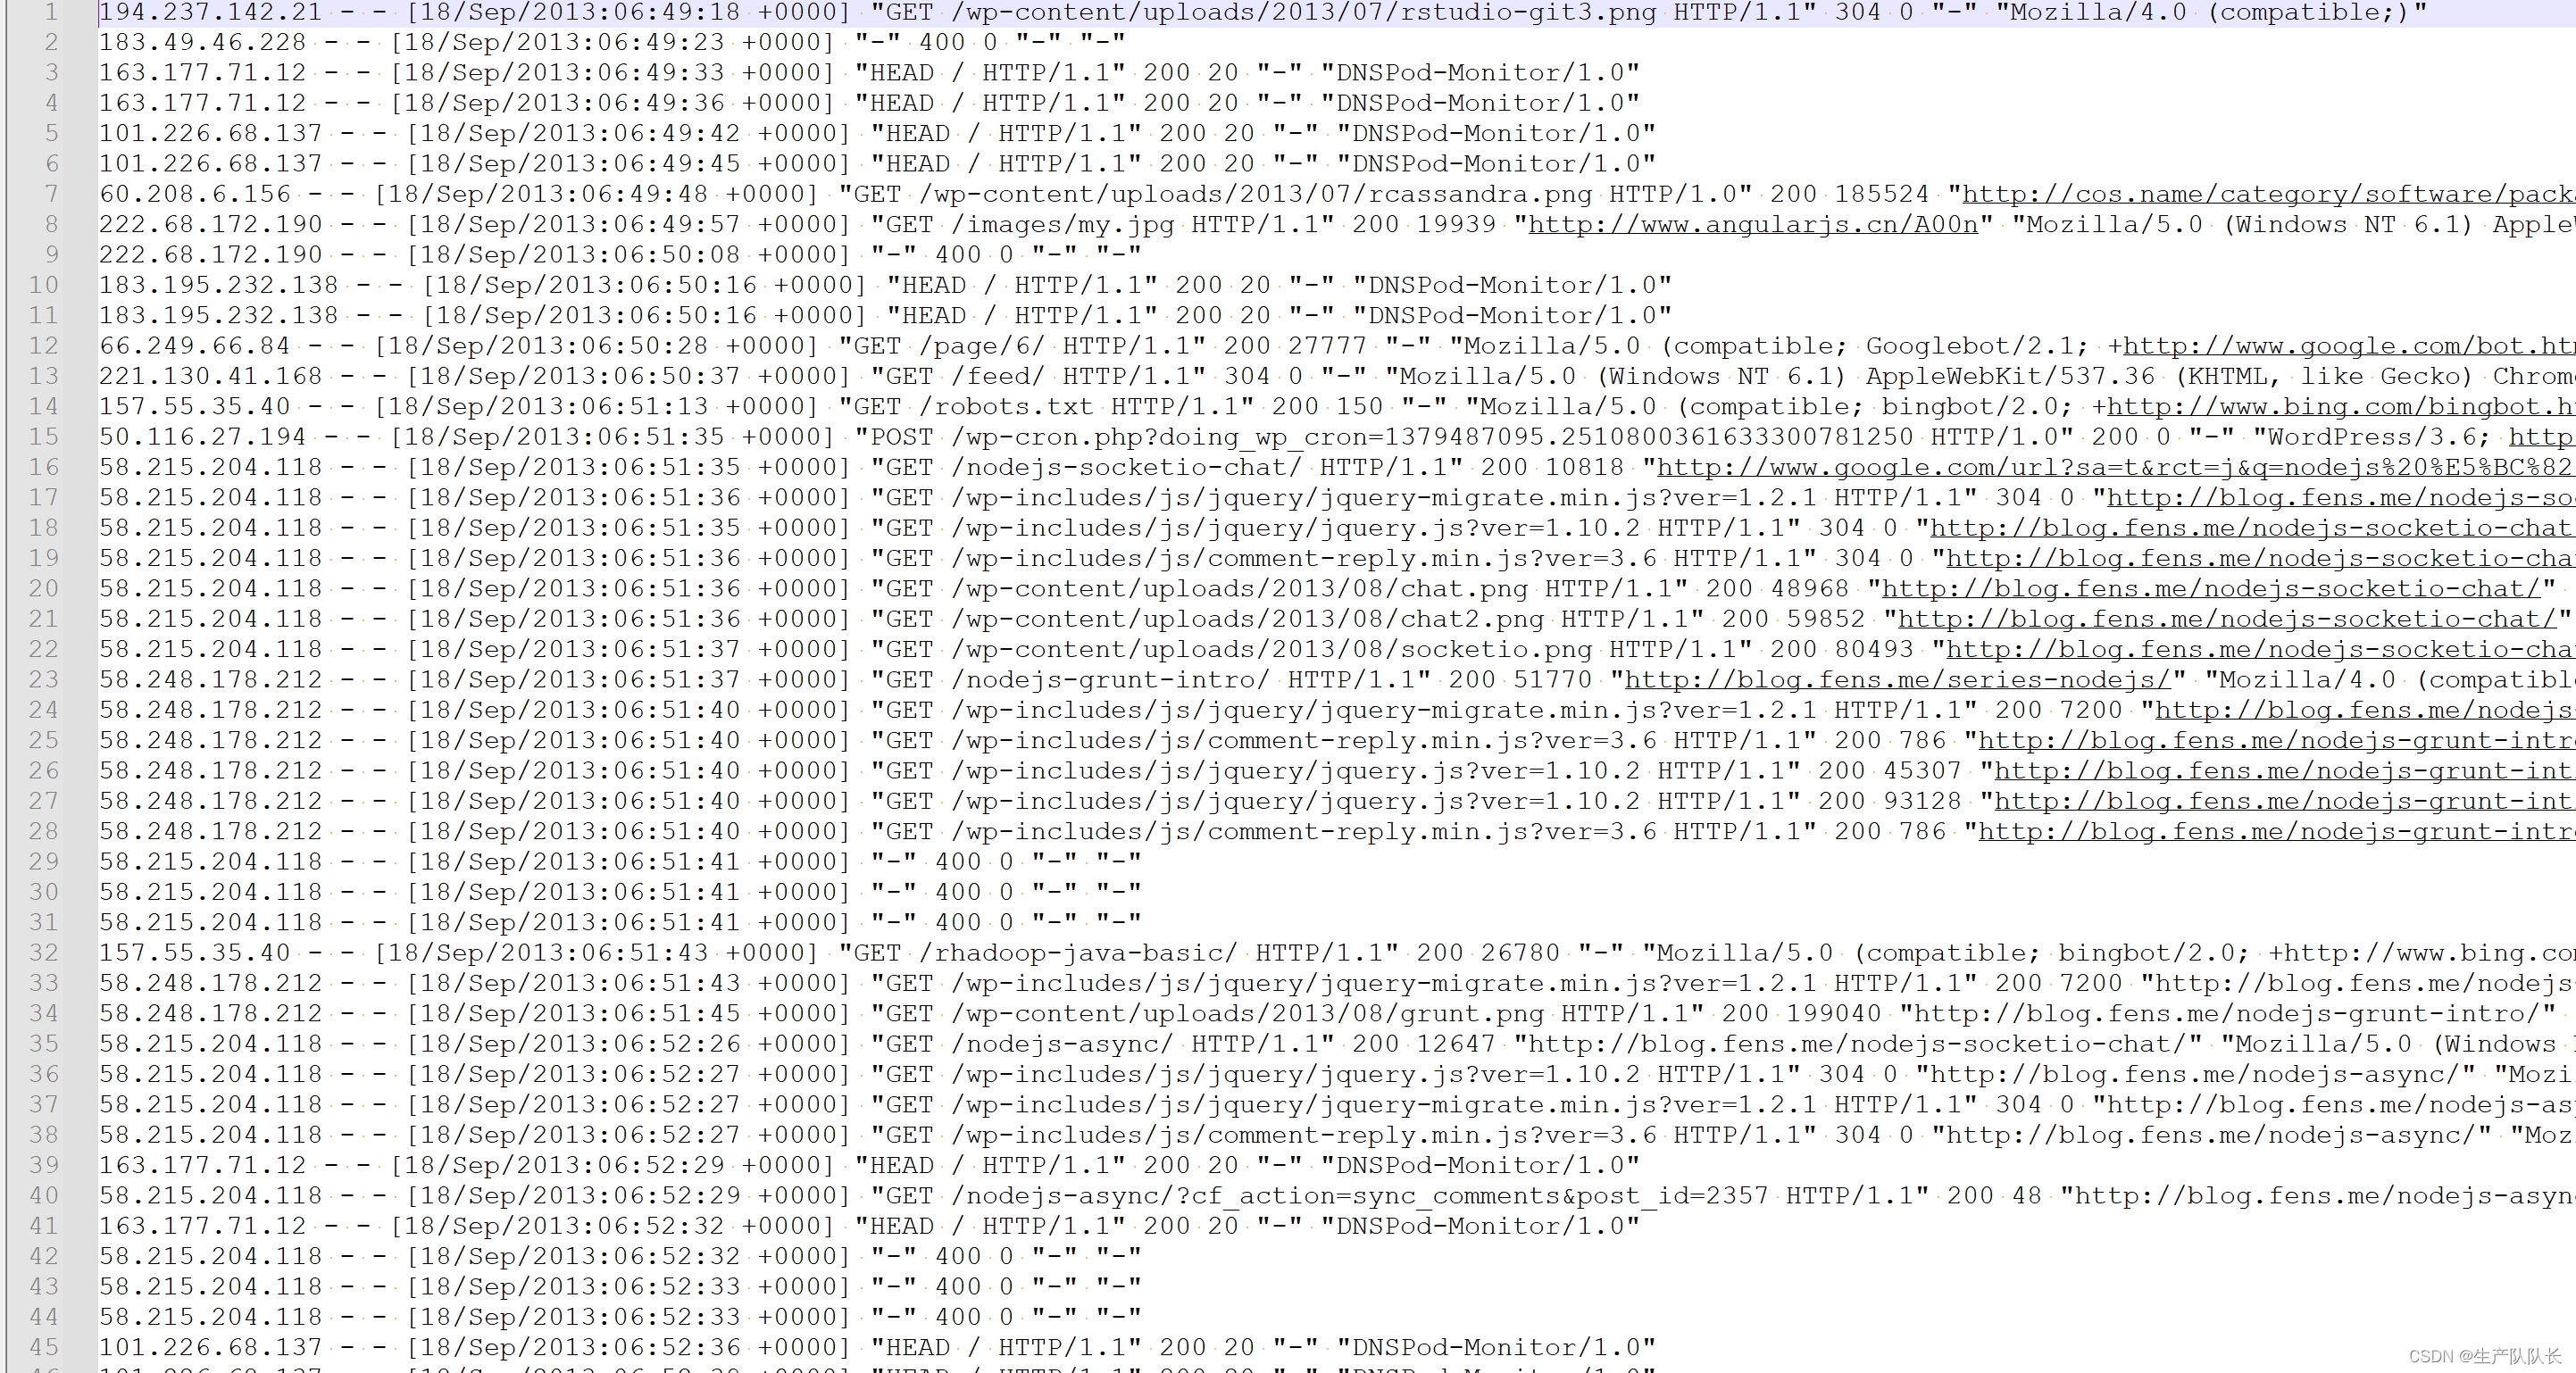
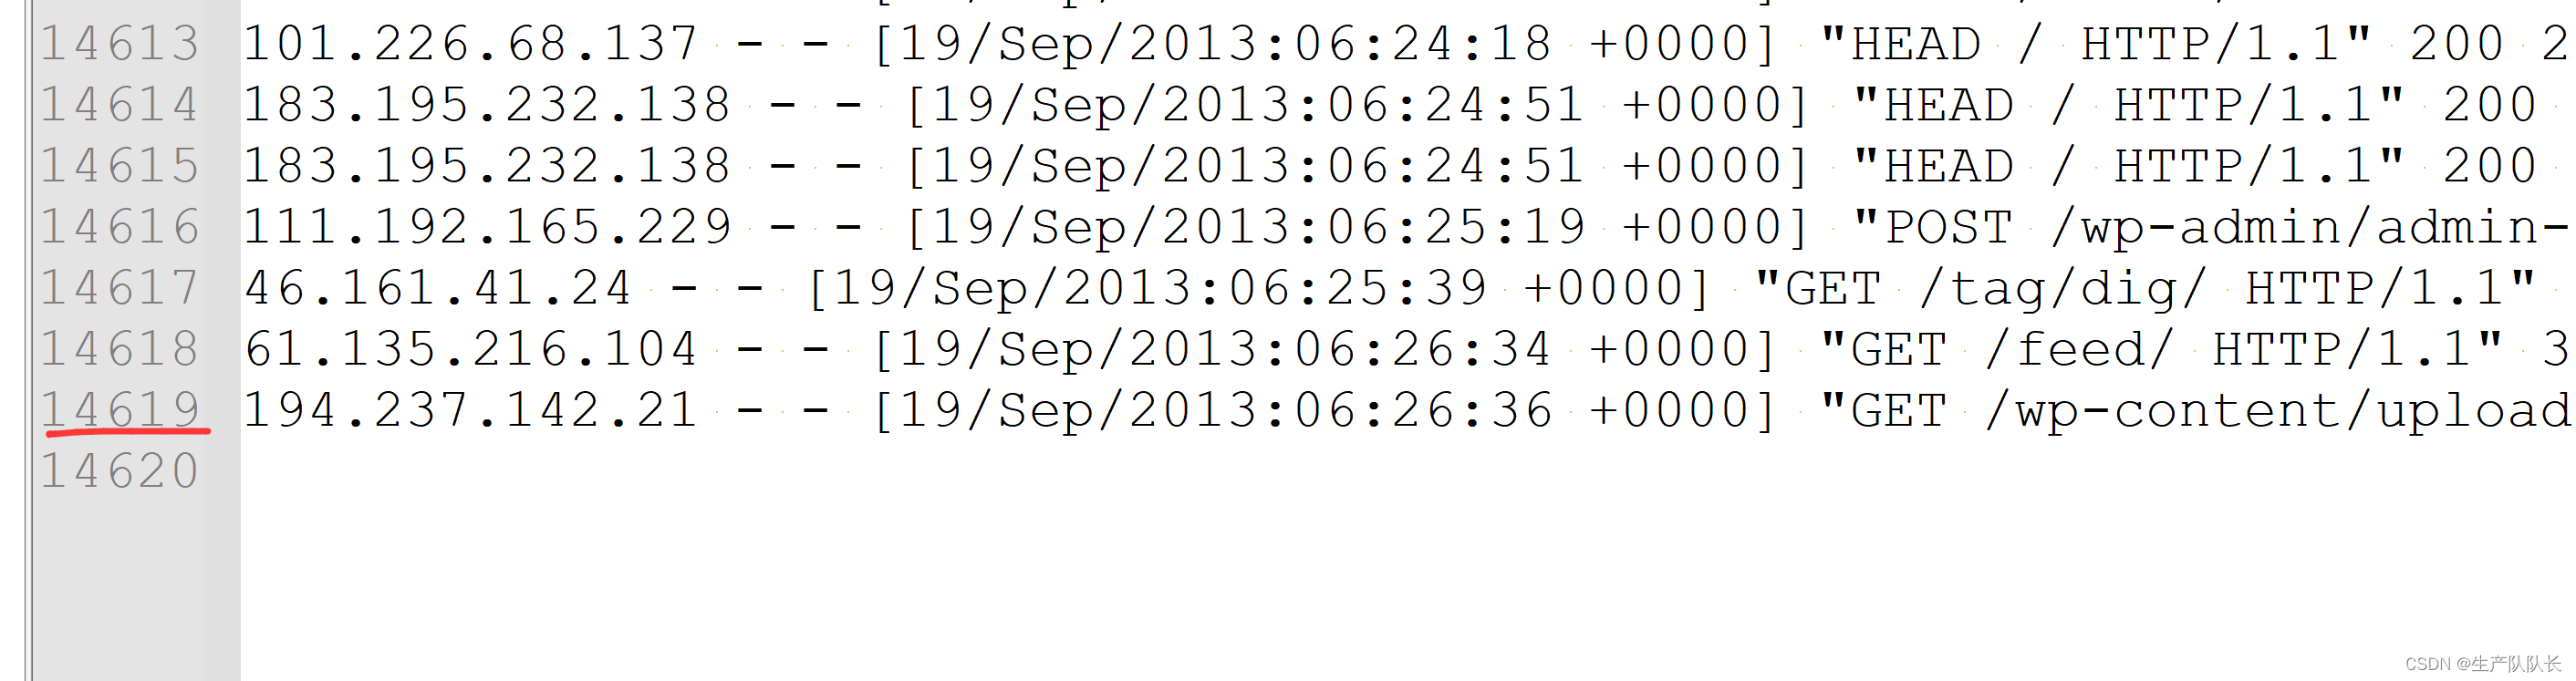
去除日志中字段个数小于等于11的日志。
三、代码实现
WebLogDriver
java
package com.atguigu.mapreduce.etl;

import com.atguigu.mapreduce.outputformat.LogDriver;
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class WebLogDriver {

    public static void main(String[] args) throws Exception {

        // 输入输出路径需要根据自己电脑上实际的输入输出路径设置
        args = new String[]{"D:/input/inputlog", "D:/hadoop/output11111"};

        // 1 获取job信息
        Configuration conf = new Configuration();
        Job job = Job.getInstance(conf);

        // 2 加载jar包
        job.setJarByClass(LogDriver.class);

        // 3 关联map
        job.setMapperClass(WebLogMapper.class);

        // 4 设置最终输出类型
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(NullWritable.class);

        // 设置reducetask个数为0
        job.setNumReduceTasks(0);

        // 5 设置输入和输出路径
        FileInputFormat.setInputPaths(job, new Path(args[0]));
        FileOutputFormat.setOutputPath(job, new Path(args[1]));

        // 6 提交
        boolean b = job.waitForCompletion(true);
        System.exit(b ? 0 : 1);
    }

}
WebLogMapper
java
package com.atguigu.mapreduce.etl;

import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.NullWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

public class WebLogMapper extends Mapper<LongWritable, Text, Text, NullWritable> {

    @Override
    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

        // 1 获取一行
        String line = value.toString();

        // 2 ETL
        boolean result = parseLog(line, context);

        if (!result){
            return;
        }

        // 3 写出
        context.write(value, NullWritable.get());
    }

    private boolean parseLog(String line, Context context) {
        // 切割
        // 1.206.126.5 - - [19/Sep/2013:05:41:41 +0000] "-" 400 0 "-" "-"
        String[] fields = line.split(" ");

        // 2 判断一下日志的长度是否大于11
        if (fields.length > 11){
            return true;
        }else {
            return false;
        }
    }
}
四、测试