pandas数据分析(5)

pandas使用Numpy的np.nan代表缺失数据,显示为NaN。NaN是浮点数标准中地Not-a-Number。对于时间戳,则使用pd.NaT,而文本使用的是None。

首先构造一组数据:
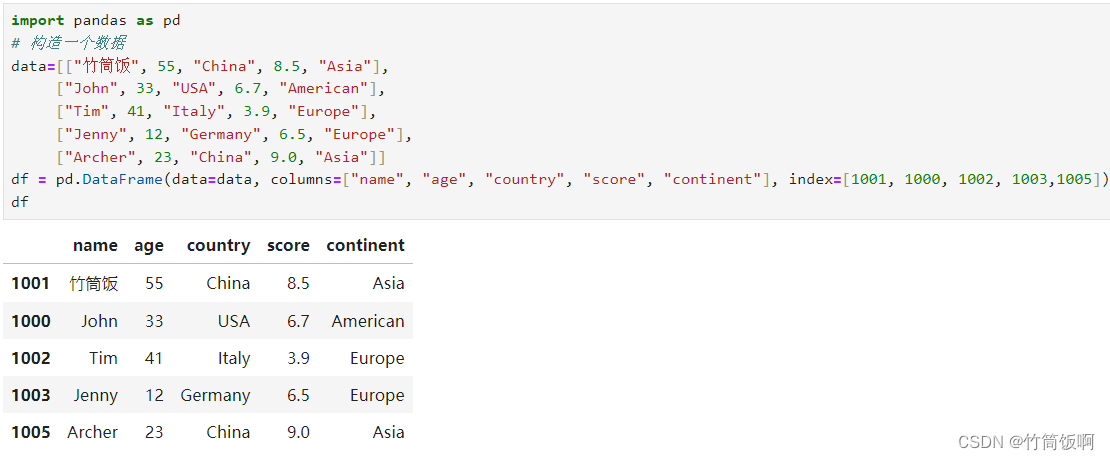
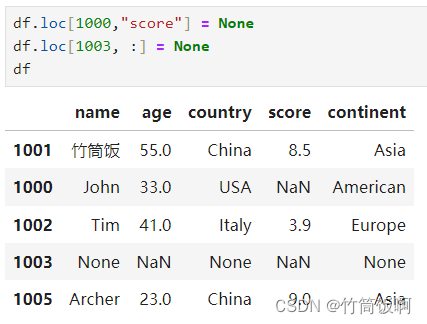
使用None或者np.nan来表示缺失的值:
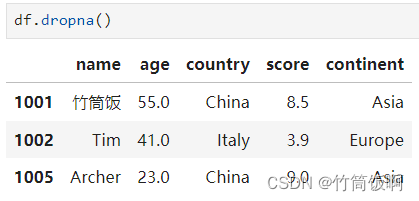
清理DataFrame时,如果要移除所有包含缺失数据的行:
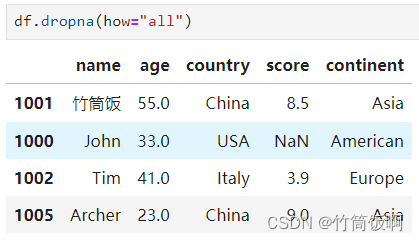
如果只想移除所有的值都缺失的行,可以使用how参数:
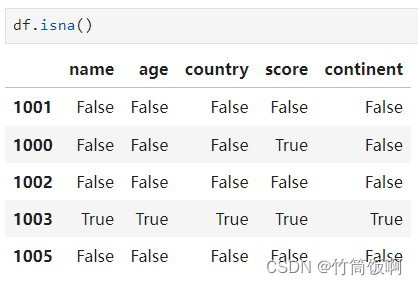
要想获得一个反映对应位置上是否是NaN的布尔DataFrame或Series,可以使用isna方法:
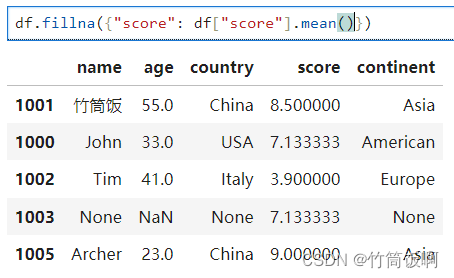
还可以使用fillna来填补缺失的值,例如将score列中的NaN替换为平均值:
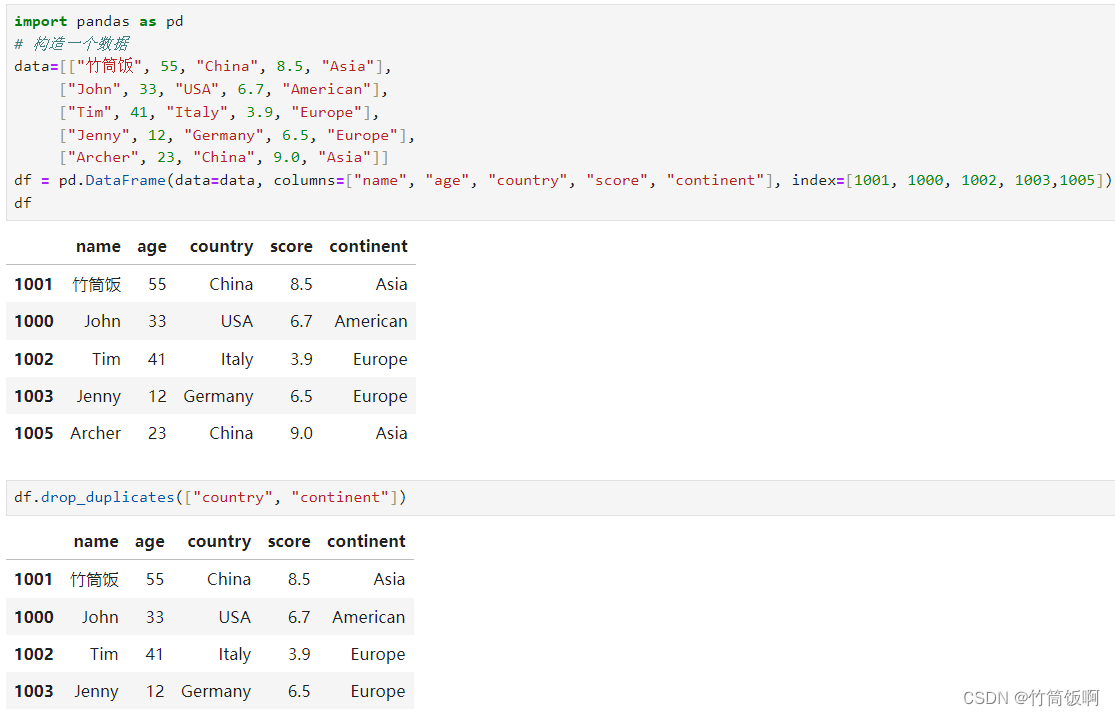
和缺失数据一样,重复数据也会对数据分析的可靠性造成负面影响。可以使用drop_duplicates方法清理重复的行。也可以提供列的子集作为参数:

执行drop_duplicates("country", "continent"),如果某些行的country和continent都一样,则保留第一行,删除后续和它一样的行。
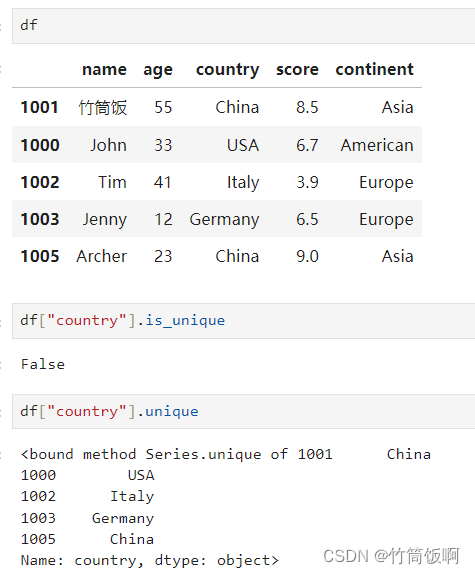
is_unique用于确认某一列是否包含重复的数据,unique则可以获得去重后的值。
duplicated方法可以知道哪些行是重复的,它的返回值是一个布尔Series。keep参数默认值是first,意思是会保留第一次出现的数据,只将重复数据标记为True。将keep参数设置为False时,所有重复数据(包含第一次出现的数据)都会被标记为True。

相关推荐
计算机编程指导师7 小时前
【计算机毕设推荐】基于Hadoop+Spark的公共交通运营数据分析与可视化系统源码 毕业设计 选题推荐 毕设选题 数据分析 机器学习
大数据·hadoop·python·计算机·数据分析·spark·交通
计算机编程指导师11 小时前
【计算机毕设选题推荐】基于Hadoop的宫颈癌变进程光谱数据分析系统源码 毕业设计 选题推荐 毕设选题 数据分析 机器学习
大数据·hadoop·python·数据分析·spark·毕业设计·宫颈癌变
benchmark_cc12 小时前
前复权数据每天可能变化,历史数据库应该覆盖还是保留原始价格?
大数据·python·pandas·量化交易·股票数据·quantdash
可乐ea12 小时前
小模型也能做数据分析智能体:把 harness 收窄做小
数据挖掘·数据分析·ai智能体·上下文工程·数据分析智能体·agentharness·工具调用设计
SL_staff14 小时前
BI不该只服务高管:JVS如何让仓库管理员自主配置库存预警
spring boot·数据分析·数据可视化
计算机编程指导师14 小时前
大数据毕业设计推荐:Hadoop+Django全球碳排放减排策略分析与可视化系统源码 毕业设计 选题推荐 毕设选题 数据分析 机器学习
大数据·hadoop·python·数据分析·spark·毕业设计·碳排放
总要学点什么14 小时前
第51篇:数据分析-热力图——笔刷画的是圆,落到地上却成了椭圆
3d·数据挖掘·数据分析·前端框架·gis·webgl·cesium
Patrick在香港15 小时前
pandas 读 CSV 不报错 ≠ 读对了:四个默认参数翻车实测
pandas·数据清洗·数据类型·实测·read_csv
计算机编程指导师15 小时前
【计算机毕设】基于Hadoop+Spark的美国互联网银行贷款数据可视化分析系统源码 毕业设计 选题推荐 毕设选题 数据分析 机器学习
大数据·hadoop·python·数据分析·spark·毕业设计·贷款
data analyse 45616 小时前
服务端访问日志聚合 PV 与 UV 怎么实现?日志采集与口径设计
大数据·前端·数据分析