为了提升模型的泛化性能,我们可以通过调参来实现。
在尝试调参之前,重要的是理解参数的含义,找到一个模型的重要参数(提供最佳泛化性能的参数)的取值是一项棘手的任务,但对于几乎所有模型和数据集来说都是必要的。由于这项任务如此常见,所以scikit-learn中有一些标准方法可以实现,其中最常用的方法就是网格搜索,它只要是指尝试我们关心的参数的所有可能组合。
考虑一个具有RBF(径向基函数)核的核SVM的例子,它在SVC类中实现。它有两个重要参数,:核宽度gamma和正则化参数C。假设我们希望尝试C和gamma都有6个不同的取值,所以总共有36中参数组合,设置表如下所示:
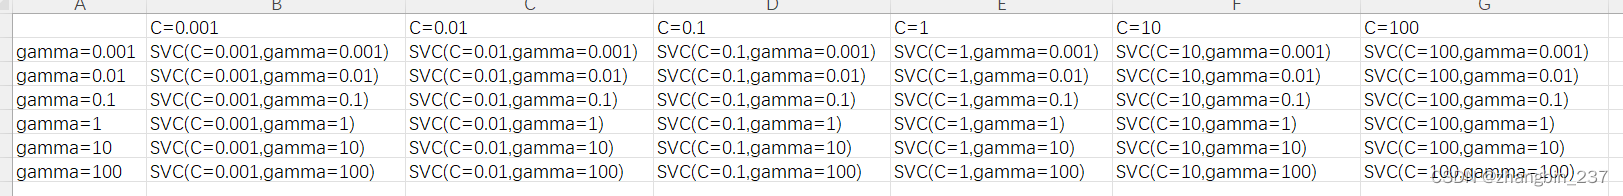
我们可以实现一个简单的网格搜索,在2个参数上使用for循环,对每种参数组合分别训练并评估一个分类器:
python
from sklearn.svm import SVC
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

iris=load_iris()

X_train,X_test,y_train,y_test=train_test_split(iris.data,iris.target,random_state=0)
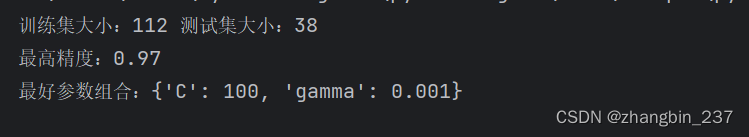
print('训练集大小:{} 测试集大小:{}'.format(X_train.shape[0],X_test.shape[0]))

best_score=0

for gamma in [0.001,0.01,0.1,1,10,100]:
    for C in [0.001,0.01,0.1,1,10,100]:
        #对每种参数组合都训练一个SVC
        svm=SVC(gamma=gamma,C=C)
        svm.fit(X_train,y_train)
        score=svm.score(X_test,y_test)
        if score>best_score:
            best_score=score
            best_parameters={'C':C,'gamma':gamma}

print('最高精度:{:.2f}'.format(best_score))
print('最好参数组合:{}'.format(best_parameters))