今天给大家分享一个开源的项目, 使用视觉大语言模型(如 GPT-4o)将 PDF 解析为 markdown。
方法非常简单(只有293行代码),但几乎可以完美地解析排版、数学公式、表格、图片、图表等。
使用 GeneralAgent lib 与 OpenAI API 交互。 每页平均价格:0.013 美元
pdfgpt-ui 是一个基于 gptpdf 的可视化工具。
处理流程
- 使用 PyMuPDF 库,对 PDF 进行解析出所有非文本区域,并做好标记,比如:
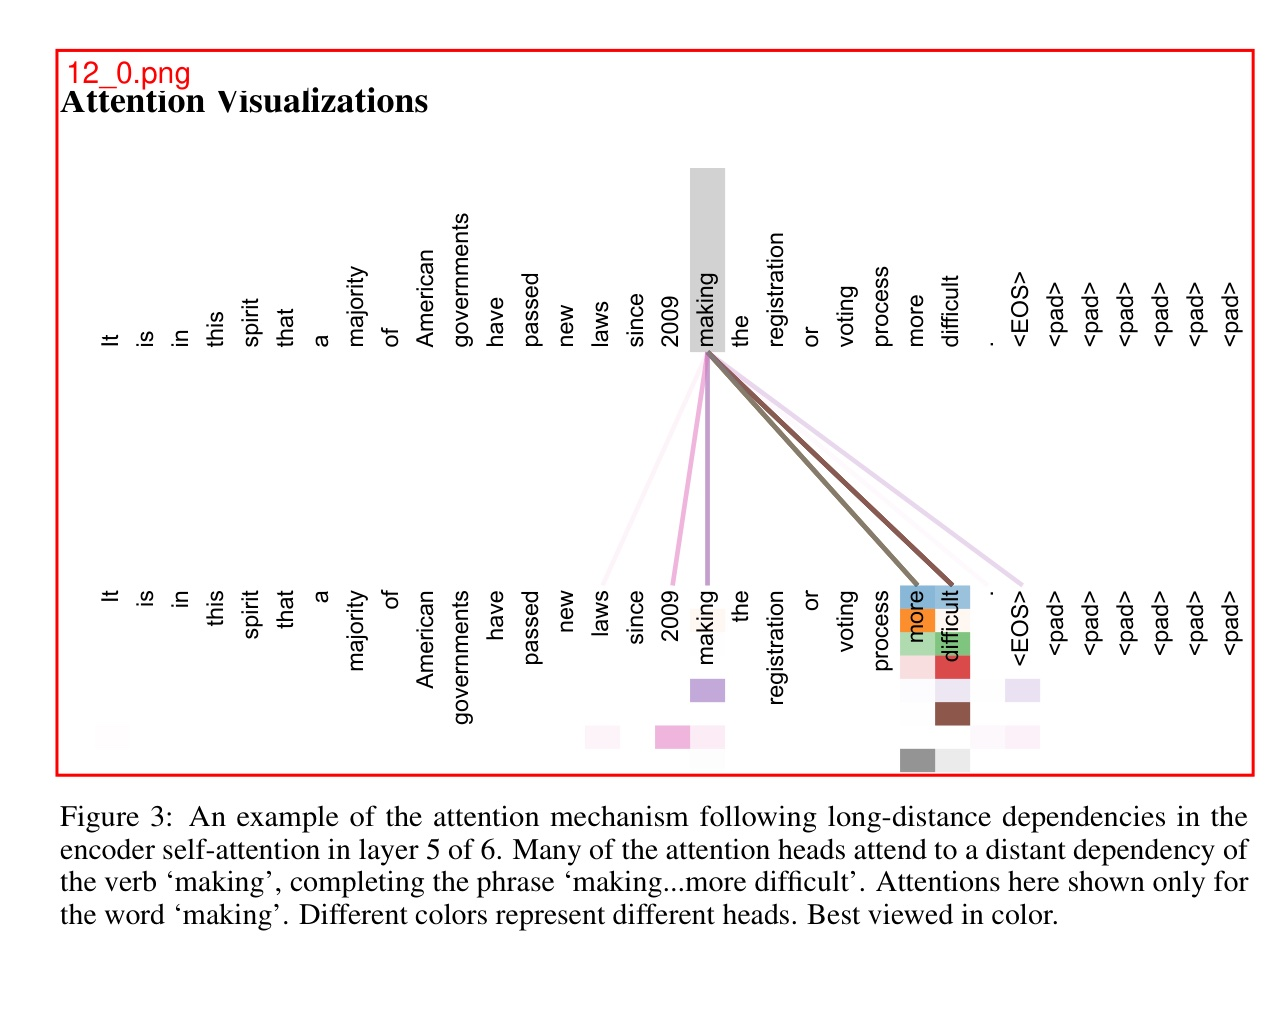
- 使用视觉大模型(如 GPT-4o)进行解析,得到 markdown 文件。
样例
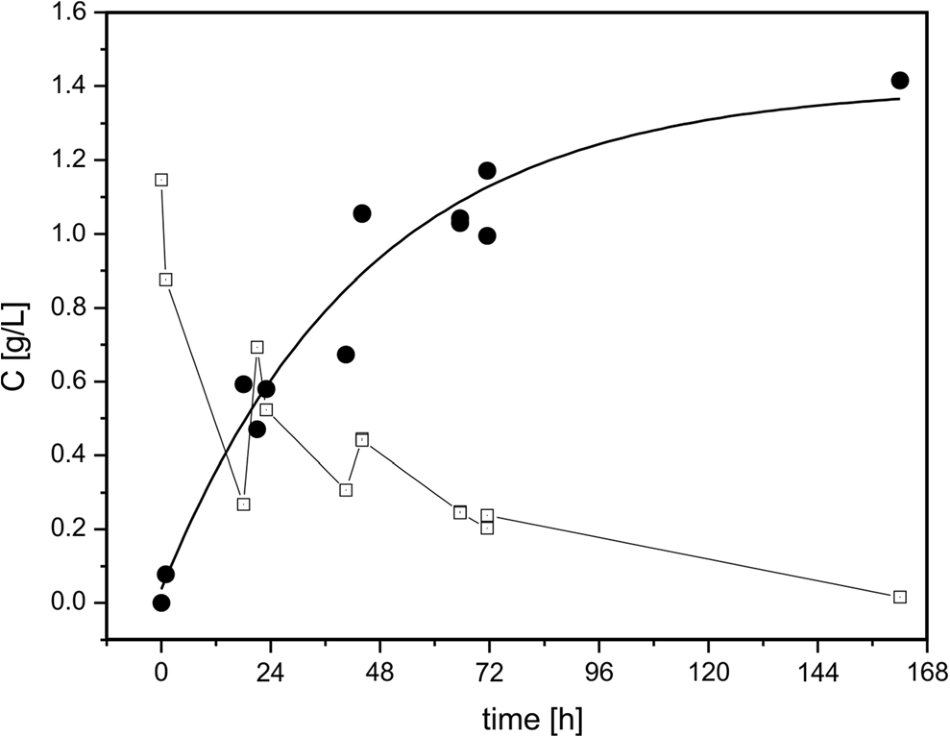
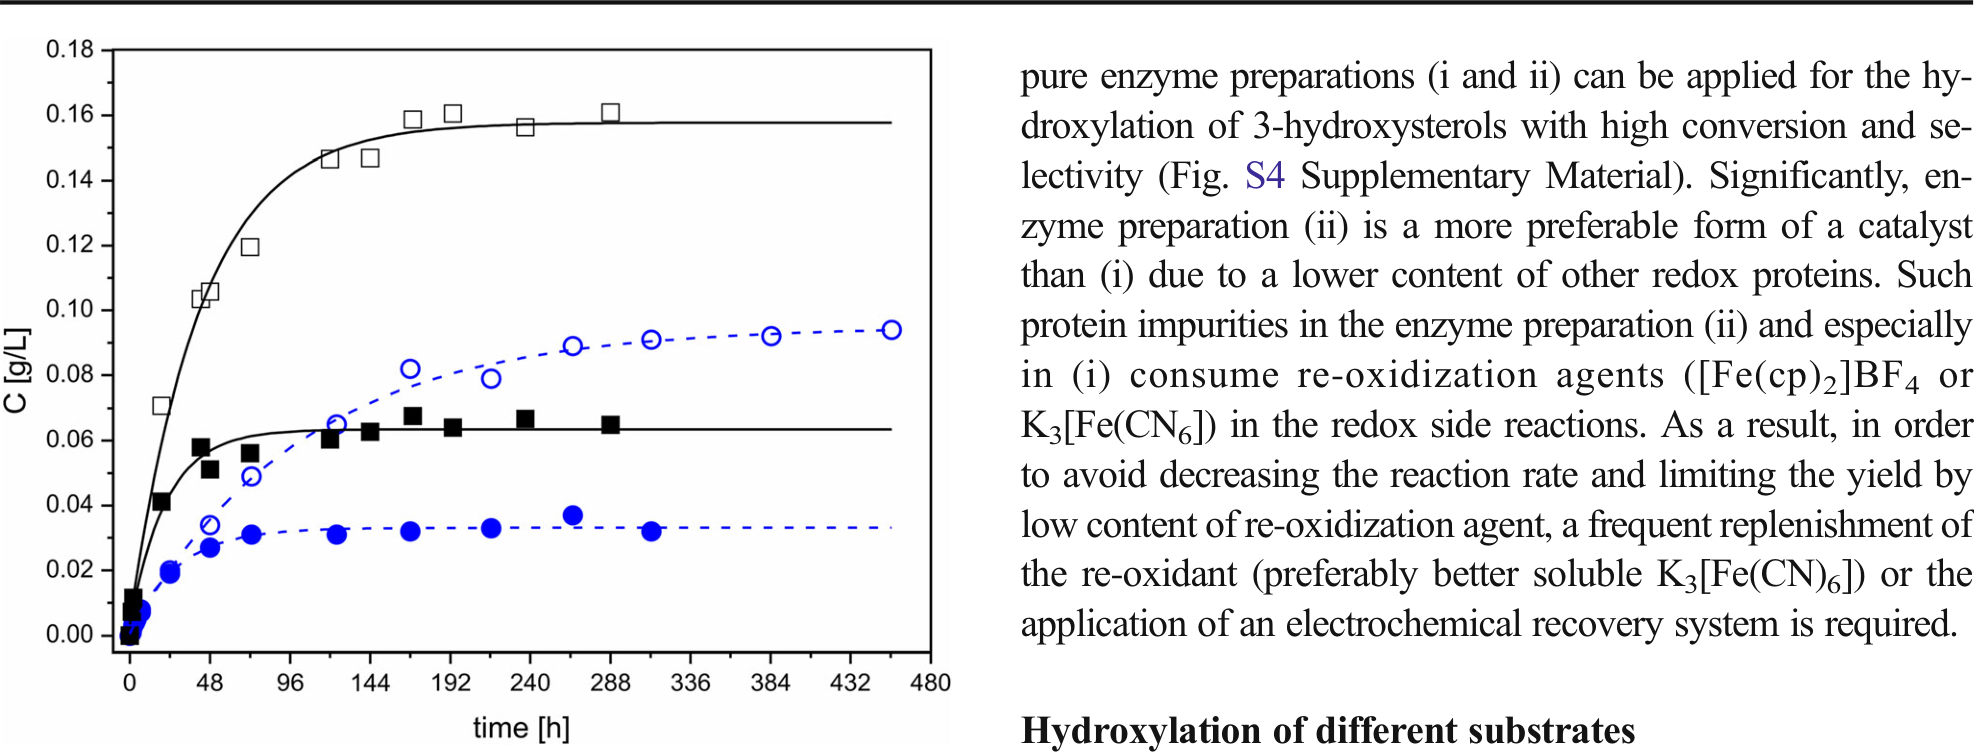
有关 PDF,请参阅 <examples/attention_is_all_you_need/output.md>
安装
pip install gptpdf使用
from gptpdf import parse_pdf

api_key = 'Your OpenAI API Key'
content, image_paths = parse_pdf(pdf_path, api_key=api_key)
print(content)
更多内容请见 <test/test.py>
API
def parse_pdf(
        pdf_path: str,
        output_dir: str = './',
        prompt: Optional[Dict] = None,
        api_key: Optional[str] = None,
        base_url: Optional[str] = None,
        model: str = 'gpt-4o',
        verbose: bool = False,
        gpt_worker: int = 1
) -> Tuple[str, List[str]]:
将 PDF 文件解析为 Markdown 文件,并返回 Markdown 内容和所有图片路径列表。
参数:
-
pdf_path :str
PDF 文件路径
-
output_dir :str ,默认值:'./'
输出目录,存储所有图片和 Markdown 文件
-
api_key :*Optionalstr*,可选
OpenAI API 密钥。如果未提供,则使用
OPENAI_API_KEY环境变量。 -
base_url :*Optionalstr*,可选
OpenAI 基本 URL。如果未提供,则使用
OPENAI_BASE_URL环境变量。可以通过修改该环境变量调用 OpenAI API 类接口的其他大模型服务,例如GLM-4V。 -
model :str,默认值:'gpt-4o'。OpenAI API 格式的多模态大模型。如果需要使用其他模型,例如
-
Azure OpenAI,通过将
base_url指定为https://xxxx.openai.azure.com/来使用 Azure OpenAI,api_key是 Azure API 密钥,模型类似于azure_xxxx,其中xxxx是部署的模型名称(已测试)。
-
verbose :bool,默认值:False,详细模式,开启后会在命令行显示大模型解析的内容。
-
gpt_worker :int ,默认值:1
GPT 解析工作线程数。如果您的机器性能较好,可以适当调高,以提高解析速度。
-
prompt : dict, 可选,如果您使用的模型与本仓库默认的提示词不匹配,无法发挥出最佳效果,我们支持自定义加入提示词。 仓库中,提示词分为三个部分,分别是:
-
prompt:主要用于指导模型如何处理和转换图片中的文本内容。 -
rect_prompt:用于处理图片中标注了特定区域(例如表格或图片)的情况。 -
role_prompt:定义了模型的角色,确保模型理解它在执行PDF文档解析任务。 您可以用字典的形式传入自定义的提示词,实现对任意提示词的替换,这是一个例子:prompt = {
"prompt": "自定义提示词语",
"rect_prompt": "自定义提示词",
"role_prompt": "自定义提示词"
}content, image_paths = parse_pdf(
pdf_path=pdf_path,
output_dir='./output',
model="gpt-4o",
prompt="",
verbose=False,
)
您不需要替换所有的提示词,如果您没有传入自定义提示词,仓库会自动使用默认的提示词。默认提示词使用的是中文,如果您的PDF文档是英文的,或者您的模型不支持中文,建议您自定义提示词。
-
版本
-
0.0.9~0.0.10: 优化 PDF 解析流程,解析效果更好
-
0.0.2 - 0.0.8: 添加 gpt_worker 参数;添加 GLM-4V、Azure OpenAI 支持;修复一些 bug
-
0.0.1: 第一个版本