在大数据快速发展的时代,流式处理技术对于实时数据分析至关重要。EMR Serverless Spark提供了一个强大而可扩展的平台,它不仅简化了实时数据处理流程,还免去了服务器管理的烦恼,提升了效率。本文将指导您使用EMR Serverless Spark提交PySpark流式任务,展示其在流处理方面的易用性和可运维性。
前提条件
已创建工作空间,详情请参见创建工作空间。
操作流程
步骤一:创建实时数据流集群并产生消息
-
在EMR on ECS页面,创建包含Kafka服务的实时数据流集群,详情请参见创建集群。
-
登录EMR集群的Master节点,详情请参见登录集群。
-
执行以下命令,切换目录。
cd /var/log/emr/taihao_exporter
-
执行以下命令,创建Topic。
创建名为taihaometrics的Topic,分区数10,副本因子2。
kafka-topics.sh --partitions 10 --replication-factor 2 --bootstrap-server core-1-1:9092 --topic taihaometrics --create
-
执行以下命令,发送消息。
使用kafka-console-producer发送消息到taihaometrics Topic。
tail -f metrics.log | kafka-console-producer.sh --broker-list core-1-1:9092 --topic taihaometrics
步骤二:新增网络连接
- 进入网络连接页面。
-
在EMR控制台的左侧导航栏,选择EMR Serverless > Spark。
-
在Spark页面,单击目标工作空间名称。
-
在EMR Serverless Spark 页面,单击左侧导航栏中的网络连接。
2.在网络连接 页面,单击新增网络连接。
3.在新增网络连接 对话框中,配置以下信息,单击确定。
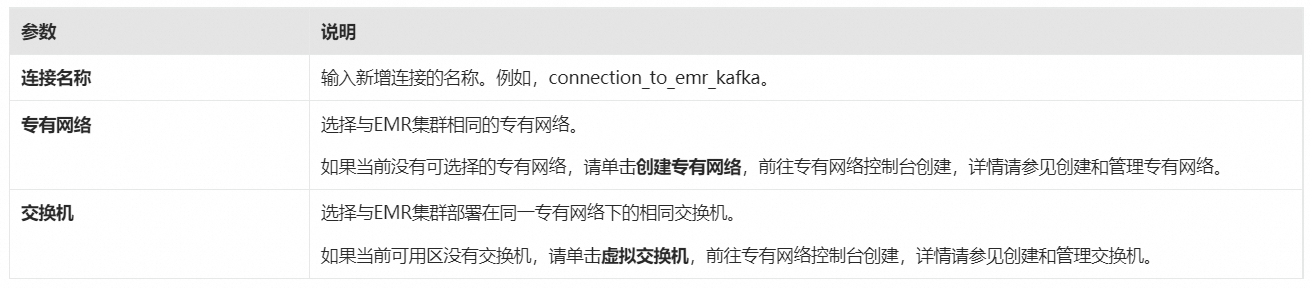
当状态 显示为已成功时,表示新增网络连接成功。
步骤三:为EMR集群添加安全组规则
- 获取集群节点交换机的网段。您可以在节点管理 页面,单击节点组名称,查看关联的交换机信息,然后登录专有网络管理控制台,在交换机页面获取交换机的网段。
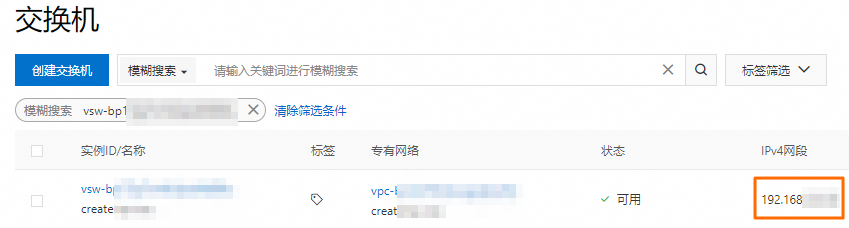
2.添加安全组规则。
-
在集群管理页面,单击目标集群的集群ID。
-
在基础信息 页面,单击集群安全组后面的链接。
-
在安全组规则页面,单击手动添加,填写端口范围和授权对象,然后单击保存。
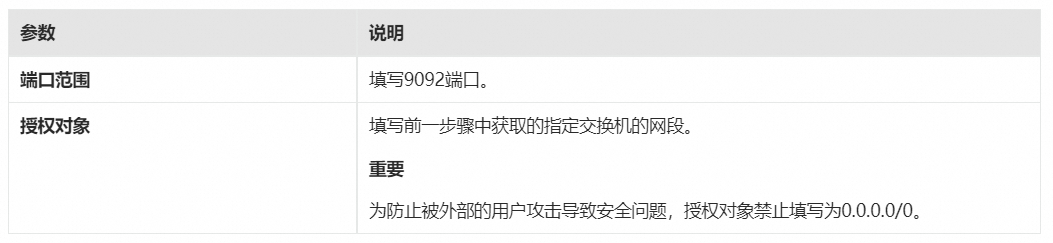
步骤四:上传JAR包至OSS
上传kafka.zip中的所有JAR包至OSS,上传操作可以参见简单上传。
步骤五:上传资源文件
-
在EMR Serverless Spark页面,单击左侧导航栏中的资源上传。
-
在资源上传 页面,单击上传文件。
-
在上传文件 对话框中,单击待上传文件区域选择pyspark_ss_demo.py文件。
步骤六:新建并启动流任务
-
在EMR Serverless Spark页面,单击左侧的任务开发。
-
单击新建。
-
输入任务名称,新建一个Application(流任务) > PySpark 类型的任务,然后单击确定。
-
在新建的任务开发中,配置以下信息,其余参数无需配置,然后单击保存。
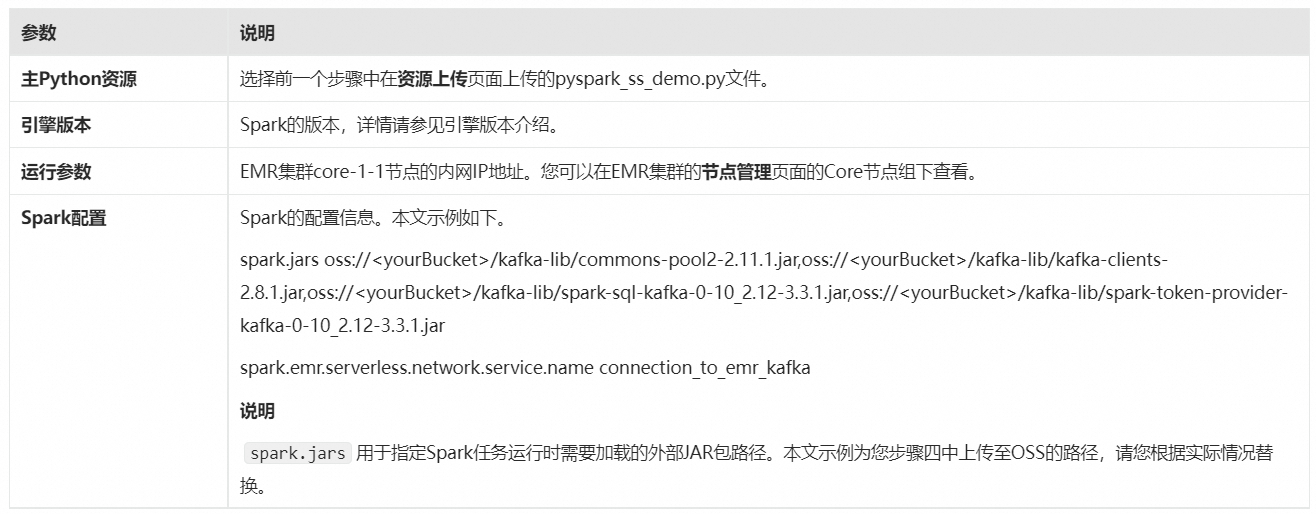
5.单击发布。
6.在发布 任务对话框中,单击确定。
7.启动流任务。
- 单击前往运维。
- 单击启动。
步骤七:查看日志
-
单击日志探查页签。
-
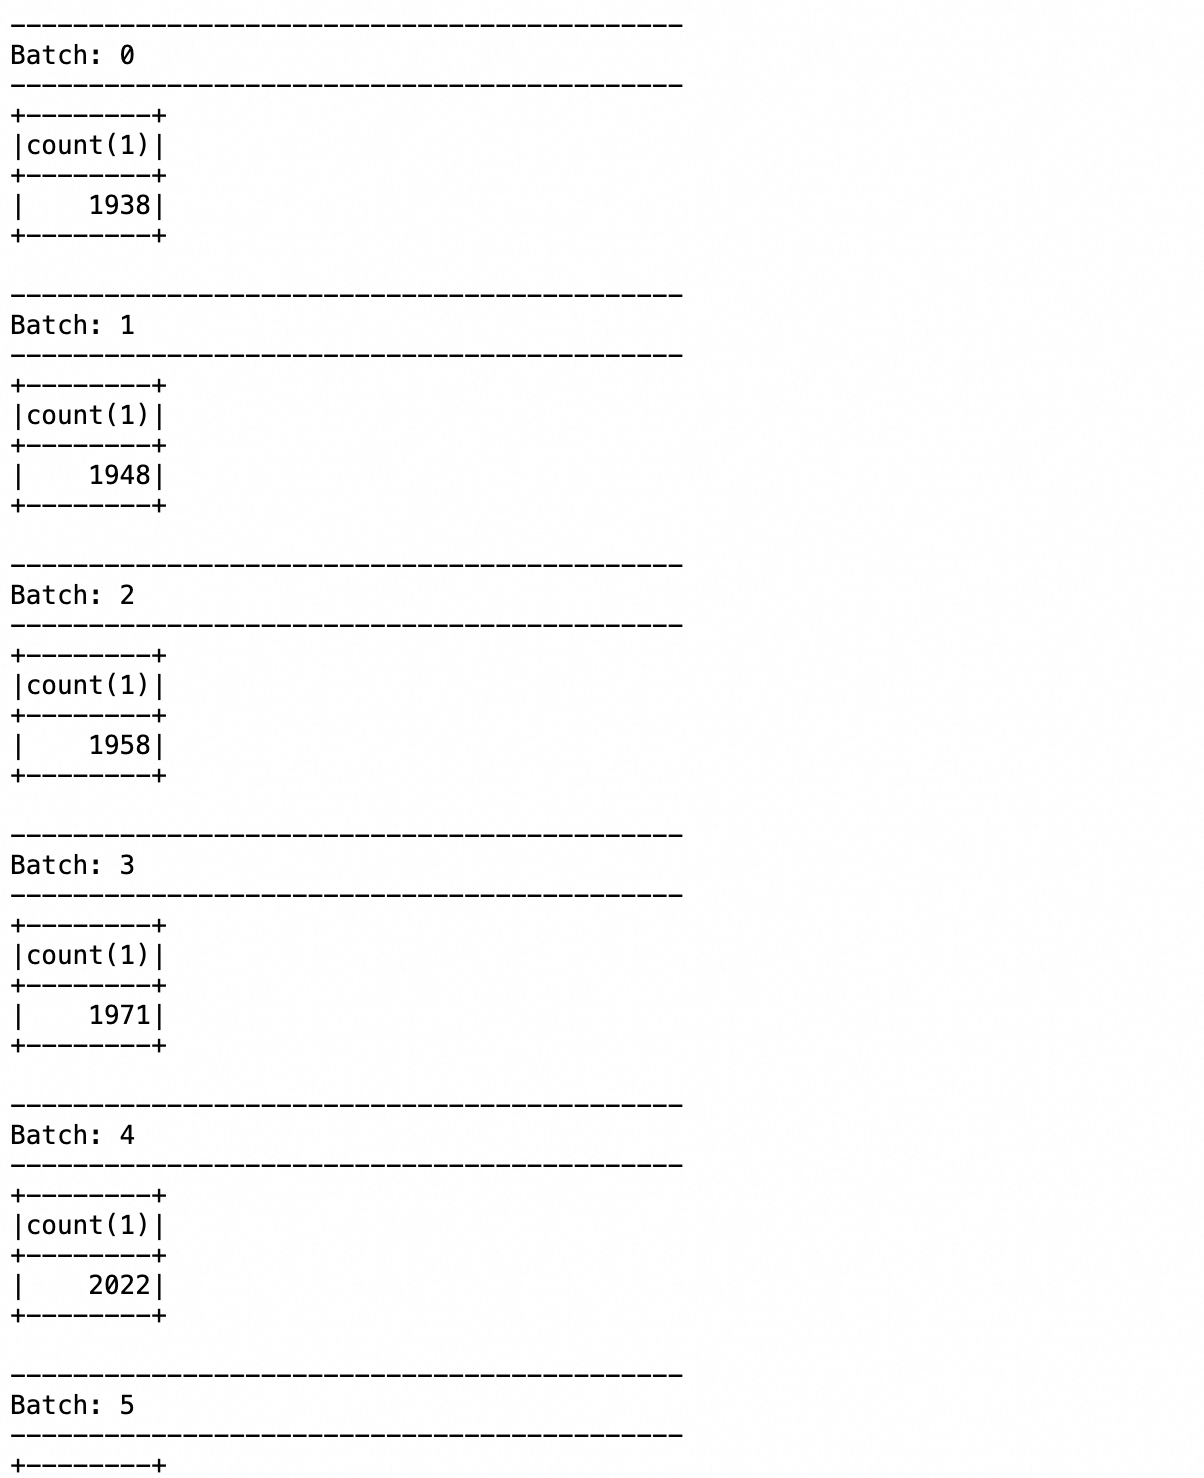
在Driver日志 列表中,单击stdOut.log。在打开的日志文件中,您可以看到应用程序执行的相关信息以及返回的结果。
相关文档
-
EMR Serverless Spark 版官网:https://www.aliyun.com/product/bigdata/serverlessspark
-
PySpark 批任务的开发流程示例:PySpark任务快速入门
EMR Serverless Spark 在 2024年5月正式开启公测,在公测期间可以免费使用最高 100 CU 计算资源,欢迎试用。 如果您在使用 EMR Serverless Spark 版的过程中遇到任何疑问,可加入钉钉群(群号:58570004119)咨询。