Perplex 是一个开源的AI 驱动的搜索引擎,可以使用 Grok 和 Open AI 等模型在计算机上本地安装和运行。它为学术研究、写作、YouTube 和 Reddit 提供了一系列搜索功能。用户可以通过选择不同的模型、设置本地嵌入模型和探索各种搜索选项来定制他们的体验。该工具演示了搜索 AI 新闻、学术论文和 YouTube 视频,提供相关信息并根据搜索查询生成响应。
接下来我们开始安装Perplexica
一:硬件配置
服务器配置:ubuntu22.04,2C8G。
安装位置:/app/Perplexica
安装方式:none-docker方式
二:环境准备
1、安装nodejs
#设置运行环境
sudo apt-get install python3 g++ make python3-pip

#安装nvm
curl -o- https://raw.githubusercontent.com/nvm-sh/nvm/v0.40.0/install.sh | bash

#使生效
source ~/.bashrc

#安装nodejs
nvm install 18
注:国内镜像源设置
npm config set registry https://registry.npmmirror.com2、安装ubuntu的图形界面
目前Perplexica只支持本机浏览,不支持共享浏览器使用。
sudo apt install gnome-panel gnome-settings-daemon metacity nautilus gnome-terminal ubuntu-desktop3、设置默认图形界面启动
sudo systemctl set-default graphical.target4、安装Chrome浏览器(假如需要)
sudo apt install chromium-browser三:安装Perplexica后端
1、克隆代码库
git clone https://github.com/ItzCrazyKns/Perplexica.git2、设置后端
#进入代码目录
cd /app/Perplexica/

#生成配置文件
cp sample.config.toml config.toml
修改config.toml
[GENERAL]
PORT = 3001 # Port to run the server on
SIMILARITY_MEASURE = "cosine" # "cosine" or "dot"

[API_KEYS]
OPENAI = "" # OpenAI API key - sk-1234567890abcdef1234567890abcdef
GROQ = "" # Groq API key - gsk_1234567890abcdef1234567890abcdef
ANTHROPIC = "" # Anthropic API key - sk-ant-1234567890abcdef1234567890abcdef

[API_ENDPOINTS]
SEARXNG = "http://localhost:32768" # SearxNG API URL
OLLAMA = "" # Ollama API URL - http://host.docker.internal:11434
其中:
SEARXNG地址即为我们上一章安装的searxng的地址
OLLAMA地址即为实际ollama访问地址,比如http://IP:11434
因为我们没有使用docker安装,这里直接写真实的ollama地址。
3、编译代码
npm i
npm run build
4、运行后端
#运行后端
npm run start
四:安装Perplexica前端
1、设置前端配置文件
#设置前端配置文件
cd /app/Perplexica/ui/
cp .env.example .env
前端.env文件无需修改
NEXT_PUBLIC_WS_URL=ws://localhost:3001
NEXT_PUBLIC_API_URL=http://localhost:3001/api
无需修改3001端口
2、编译代码:
#编译前端代码
npm i
npm run build 
如果在编译过程报错,留意报错内容,绝大部分原因是网络造成的,可以多运行几次。 强烈建议改用国内镜像源,以减少出错。
3、运行前端
#运行前端
npm run start
五:运行
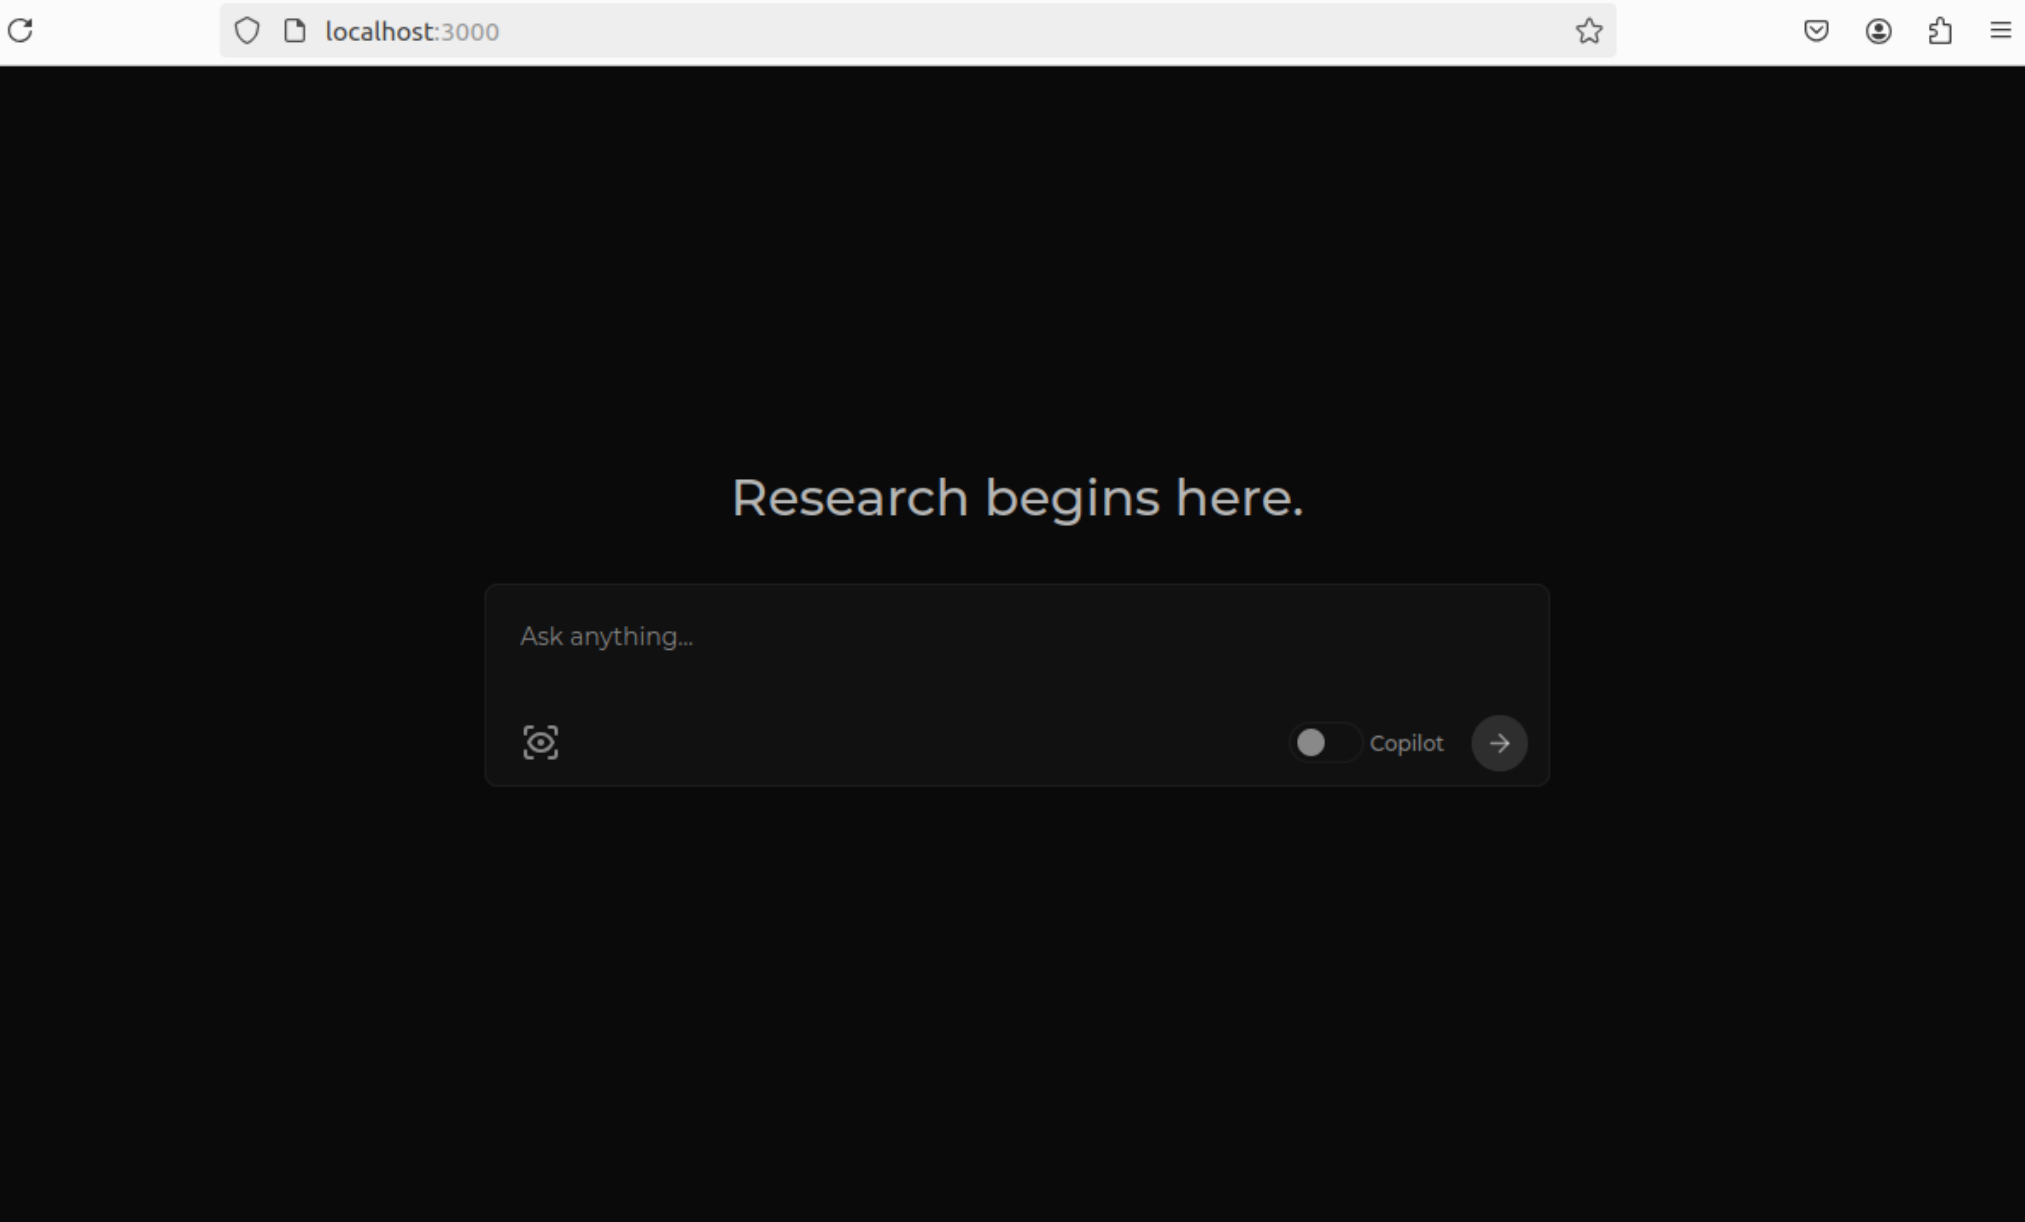
运行前,请确保前后端都已运行起来。然后在浏览器里打开。
注意下面的这些资源并不是所有都可以访问的,小伙伴们可以自己每一个都试试。

模型设置

可以选择ollama里面你pull下来的相关模型。 从第三方计算机,打开这个浏览器,可以看不到哦,如下图:

这个并不是问题,问题是当前该版本不支持共享访问,只能从本机访问。