0. 简介
深度学习中做量化提升运行速度是最常用的方法,尤其是大模型这类非常吃GPU显存的方法。一般是高精度浮点数表示的网络权值以及激活值用低精度(例如8比特定点)来近似表示达到模型轻量化,加速深度学习模型推理,目前8比特推理已经比较成熟。比如int8量化,就是让原来32bit存储的数字映射到8bit存储。int8范围是-128,127, uint8范围是0,255。
使用低精度的模型推理的优点:1. 模型存储主要是每个层的权值,量化后模型占用空间小,32比特可以缩减至8比特,并且激活值用8比特后,减小了内存的访问带宽需求。2:单位时间内处理定点运算指令比浮点数运算指令多。
1. 量化分类
一般按照量化阶段不同分为后量化和训练时量化,用的比较多的是后量化,像tensorRT和RKNN按照量化映射方法又可以分为对称量化和非对称量化。
1.1 非对称量化(uint8 0-256)
非对称量化需要一个偏移量Z来完成零点的映射,即量化前的零点和量化后的零点不一致。非对称量化的一般公式为:
S = r m a x − r m i n q m a x − q m i n S = \frac{r_{max} - r_{min}}{q_{max} - q_{min}} S=qmax−qminrmax−rmin
Z = q m a x − R o u n d ( r m a x S ) Z = q_{max} - Round(\frac{r_{max}}{S}) Z=qmax−Round(Srmax)
r m a x r_{max} rmax和 r m i n r_{min} rmin表示真实数据的最大值和最小值, q m a x q_{max} qmax和 q m i n q_{min} qmin表示量化后的最大值和最小值,例如uint8就是0和256。 Round()表示取整,如果是量化为int型。
1.1.1 量化
q = R o u n d ( r S + Z ) q = Round(\frac{r}{S} + Z) q=Round(Sr+Z)
1.1.2 反量化
r = ( q − Z ) ∗ S r = (q - Z)*S r=(q−Z)∗S


1.2 对称量化(int8 -128-127)
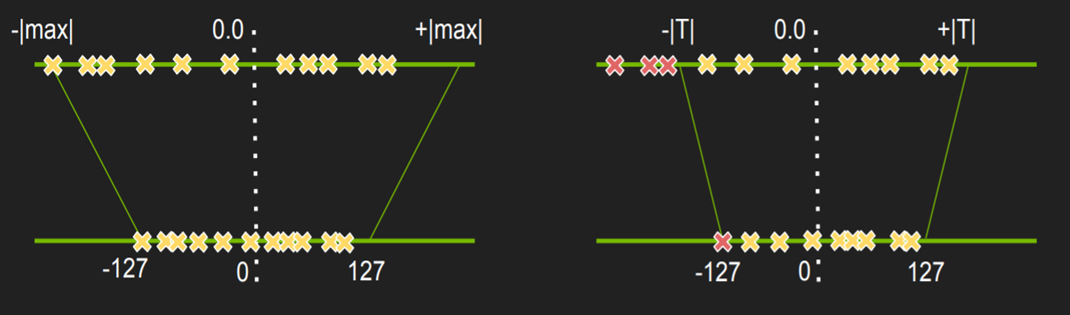
对称算法是通过一个收缩因子,将FP32中的最大绝对值映射到8比特的最大值,最大绝对值的负值(注意此值不是fp32的最小值,是最大绝对值的相反数,故对称)映射到8比特的最小值。对称量化在量化前和量化后的零点保持一致,即零点对应,因此无需像非对称量化那样引入一个偏移量Z。 对称量化的一般公式为:
S = ∣ r m a x ∣ ∣ q m a x ∣ S = \frac{|r_{max}|}{|q_{max}|} S=∣qmax∣∣rmax∣
1.2.1量化
q = R o u n d ( r S ) q = Round(\frac{r}{S}) q=Round(Sr)
Round()表示取整,如果是量化为int型。
1.2.2 反量化
r = q ∗ S r = q*S r=q∗S


2. 量化的优缺点
2.1 量化的优点
- 减小模型尺寸,如8位整型量化可减少75%的模型大小
- 减少存储空间,在边缘侧存储空间不足时更具有意义
- 易于在线升级,模型更小意味着更加容易传输
- 减少内存耗用,更小的模型大小意味着不需要更多的内存
- 加快推理速度,访问一次32位浮点型可以访问四次int8整型,整型运算比浮点型运算更快
- 减少设备功耗,内存耗用少了推理速度快了自然减少了设备功耗
- 支持微处理器,有些微处理器属于8位的,低功耗运行浮点运算速度慢,需要进行8bit量化
2.2 量化的缺点
- 模型量化增加了操作复杂度,在量化时需要做一些特殊的处理,否则精度损失更严重
- 模型量化会损失一定的精度,虽然在微调后可以减少精度损失,但推理精度确实下降
3. 对称和非对称使用
对称量化无需引入偏移量Z,因此计算量低,缺点是量化后的数据是非饱和的,即有一部分区域不存在量化的数据。
非对称量化因为额外引入了一个偏移量来修正零点,因此需要的计算量会大一点。优点是其量化后的数据是饱和的,即量化前的最小值对应量化范围的最小值,量化后的最大值对应量化范围的最大值。

对于fp32的值若均匀分布在0左右,映射后的值也会均匀分布,若fp32的值分布不均匀,映射后不能充分利用。所以非对称可以处理好FP32数据分布不均匀的情况。
...详情请参照古月居
若对称算法产生的量化后数据很多都是在【0,127】内,左边的范围利用很少,减弱了量化数据的表示能力,影响模型精度。

此外还有很多其他的魔改版本,比如激活值饱和量化,通过选择合适的阈值T来将一些范围利用少的情况去除,然后再做对称量化。从而也实现对应的饱和量化的操作。下图为魔改版本激活值饱和量化(右图),选择合适的阈值T。以及原始版本权值非饱和量化(左图)
4. 参考链接
https://www.cnblogs.com/ywheunji/p/13348190.html
https://errolyan.medium.com/1-模型为啥需要量化-1b6c49dbe621
http://www.yindaheng98.top/人工智能/quant.html#对称量化-uniform-affine-quantizer
https://blog.csdn.net/weixin_43863869/article/details/133893699