一、模型介绍
强大的小样本语音转换和文本转语音 WebUI。
具有以下特征:
- 零样本 TTS: 输入 5 秒的声音样本并体验即时文本到语音的转换。
- 少量样本 TTS: 仅使用 1 分钟的训练数据对模型进行微调,以提高语音相似度和真实感。
- 跨语言支持:使用不同于训练数据集的语言进行推理,目前支持英语、日语、韩语、粤语和中文。
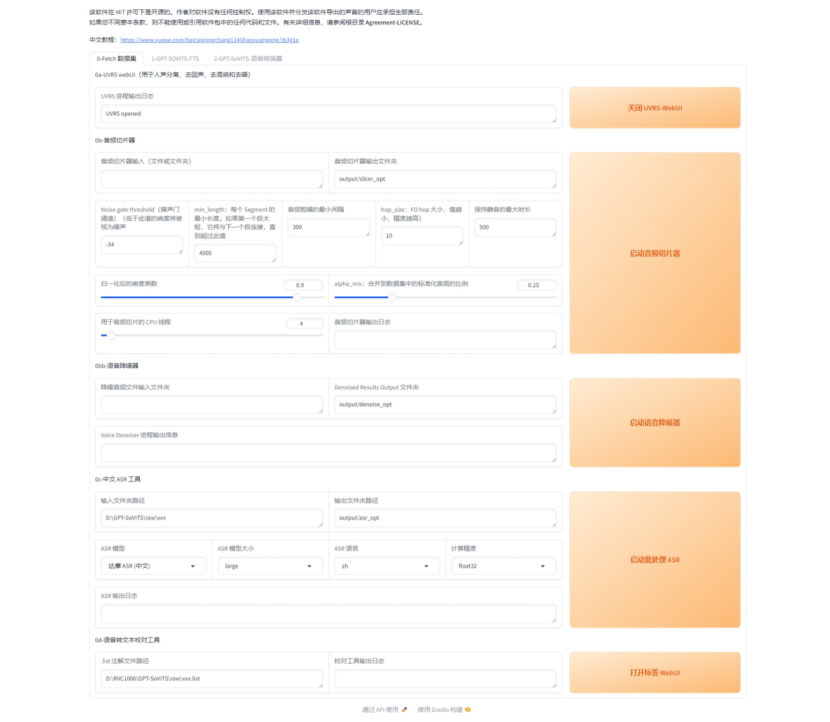
- WebUI 工具: 集成工具包括语音伴奏分离、自动训练集分割、中文 ASR 和文本标注,帮助初学者创建训练数据集和 GPT/SoVITS 模型。
二、部署流程
测试环境
- Python 3.9、CUDA 12.1
1.克隆
git clone https://github.com/RVC-Boss/GPT-SoVITS.git
cd /GPT-SoVITS/
2.创建虚拟环境并安装
conda create -n GPTSoVits python=3.9
conda activate GPTSoVits
bash install.sh
3.安装ffmpeg
conda install ffmpeg4.安装依赖项
pip install -r requirements.txt5.预训练模型
用户可以在这里下载所有这些模型。
- 从 GPT-SoVITS 模型下载预训练模型并将其放置在
GPT_SoVITS/pretrained_models。 - 下载 G2PW 模型G2PWModel_1.1.zip,解压并重命名为
G2PWModel,然后将其放置在GPT_SoVITS/text。(仅支持中文 TTS) - 对于 UVR5(此外还有人声/伴奏分离和混响消除),从UVR5 Weights下载模型并将其放入
tools/uvr5/uvr5_weights。 - 对于中文 ASR(另外),从Damo ASR 模型、Damo VAD 模型和Damo Punc 模型下载模型并将它们放置在 中
tools/asr/models。 - 对于英语或日语 ASR(另外),请从Faster Whisper Large V3下载模型并将其放入
tools/asr/models。此外,其他模型可能具有类似的效果,但磁盘占用空间更小。
也可从modelscope下载:
git lfs install
git clone https://www.modelscope.cn/AI-ModelScope/GPT-SoVITS.git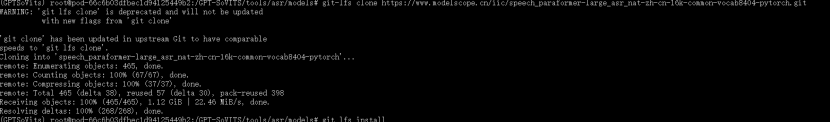
6.数据集格式
TTS 注释.list 文件格式:
vocal_path|speaker_name|language|text语言词典:
- 'zh':中文
- 'ja':日语
- 'en':英语
- 'ko':韩语
- '粤':粤语
三、推理
python webui.py 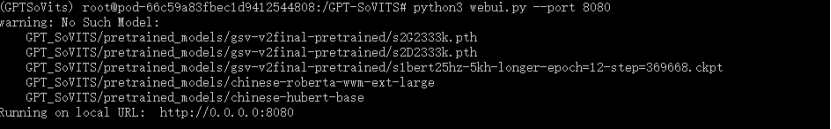
四、页面演示