把Llama 3蒸馏到Mamba,推理速度最高可提升1.6倍! 而且性能不减,甚至表现比原始模型还要优异。
这是来自Together AI的新作,通过蒸馏将Transformer和Mamba模型结合到了一起,同时还为混合模型涉及了推理加速算法
提出Mamba架构的大神、FlashAttention作者Tri Dao,也参与了这一项目。
Together AI创始人兼CEO表示,Transformer和Mamba的混合,是未来大模型的一大发展方向。
将Transformer蒸馏进Mamba
在蒸馏正式开始之前,需要先进行从Transformer到线性RNN的初始化。
作者观察到,Transformer的注意力机制与RNN的计算之间存在一定的相似性。
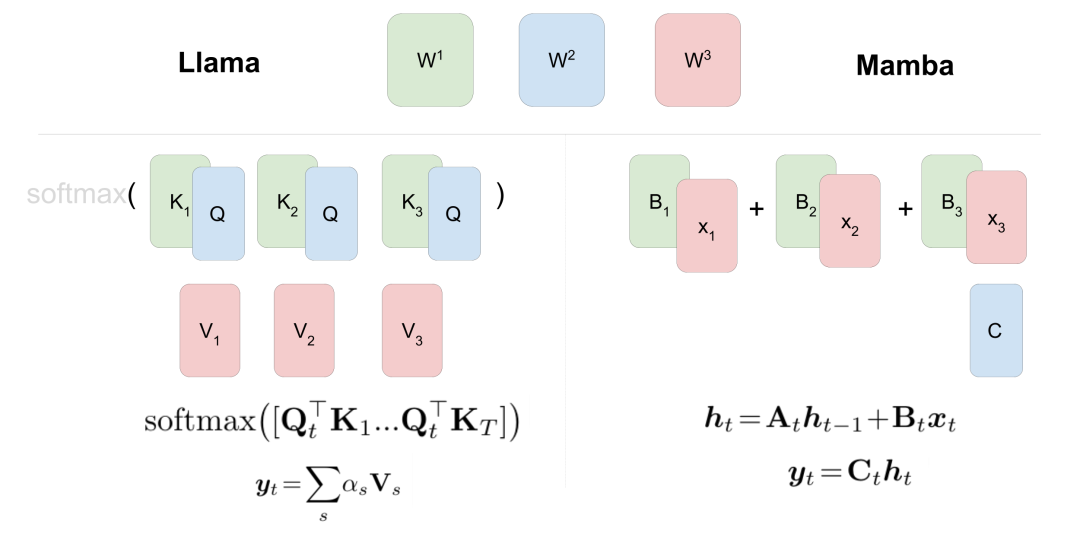
因此可以将Transformer的注意力线性化,从而建立二者的联系。
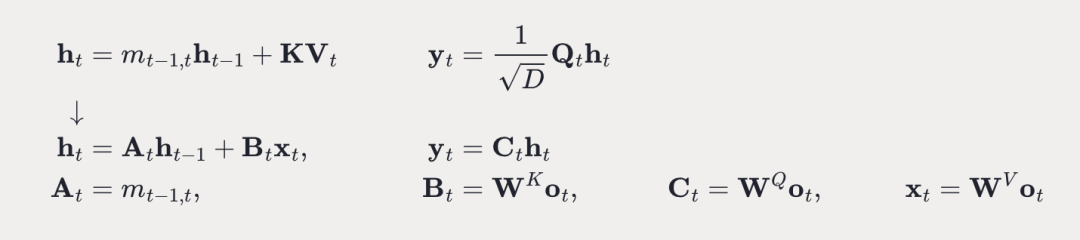
利用这种对应关系,可以将预训练的Transformer模型的参数复制到Mamba模型中。
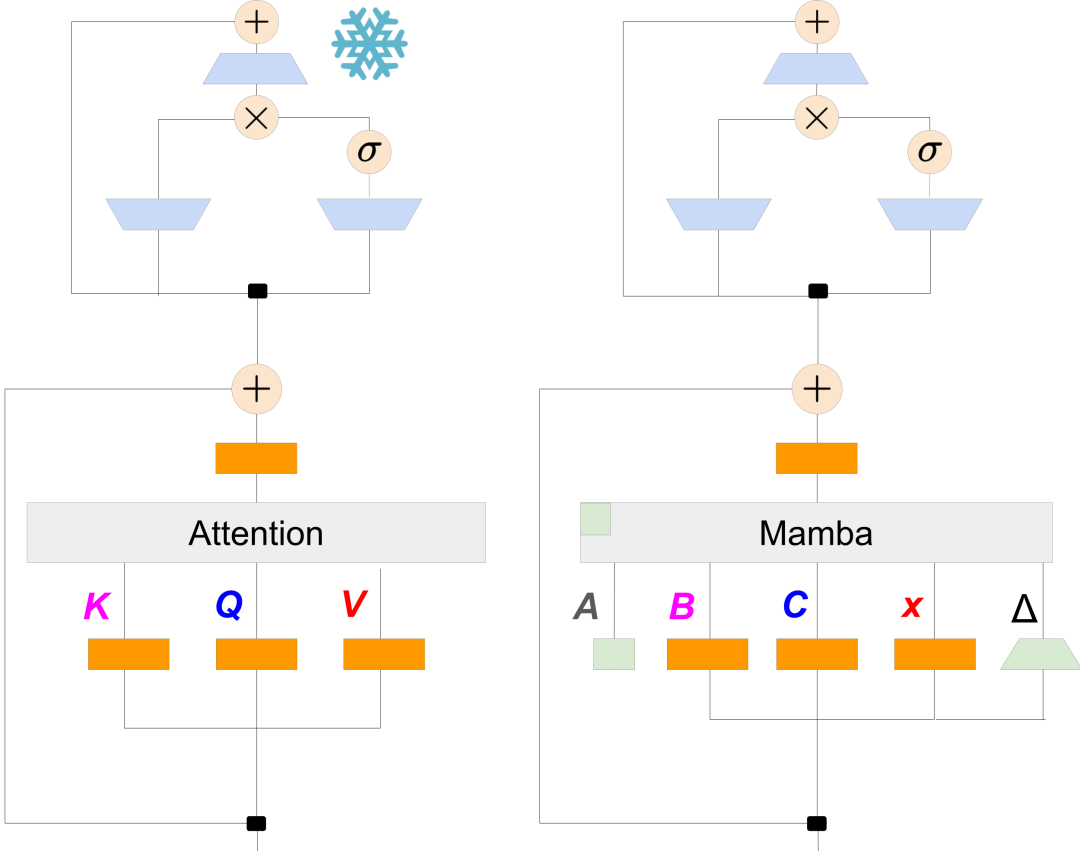
在完成参数初始化后,作者采用了一个三阶段的蒸馏流程进一步提升Mamba模型的性能,使其更好地学习Transformer的知识。
第一阶段是基于伪标签的蒸馏------使用预训练的Transformer教师模型在无标签数据上生成伪标签,然后让Mamba学生模型在这些伪标签上训练。
这一过程的损失函数结合了KL散度损失和交叉熵损失,分别用于模仿教师模型输出分布以及伪标签的拟合。
第二阶段是在指令数据集上进行的监督微调,使用带标签的指令数据集(如OpenHermes 2.5)进行训练。
最后一个阶段,是用人类反馈数据,通过基于奖励模型进行优化。
作者收集了人类对模型输出的反馈数据,然后据此构建一个奖励模型并使用 RL 算法(如 PPO)来优化模型在该奖励模型下的表现。
在8块80G A100 GPU上,每个混合模型的整个蒸馏过程,只需不到五天的时间。
通过以上的蒸馏过程,作者得到了Transformer-Mamba混合模型,之后又提出了Speculative Decoding(推测解码)算法来加速推理过程。
混合模型推理加速算法
推测解码算法的基本思想是使用一个轻量级的Draft模型来预测多个token,然后再用验证模型(Verifier)来验证这些预测。
这样可以显著提高解码的并行性,加速生成过程。

Draft模型通常是一个小的Transformer,根据当前的上下文预测出接下来的K个token。
对于预测出的K个token,Transformer层可以直接并行地处理这K个token,计算它们的隐状态;
Mamba层则需要按照顺序依次处理每个token,首先计算当前token的隐状态,并将其与之前的隐状态进行比较。
-
如果当前token是正确的,则将其添加到已接受的序列中,并更新最新的隐状态(但不保存中间状态)。
-
如果当前token是错误的,则停止处理后续token,并将最新的隐状态回退到上一个已接受的token处。
如果序列中的所有K个token都被接受,则将它们添加到输出序列中,并继续预测下一组token。
如果有token被拒绝,则从第一个被拒绝的token处截断预测序列,并返回初始步骤从该位置开始重新预测。
Llama 3推理速度提升1.6倍
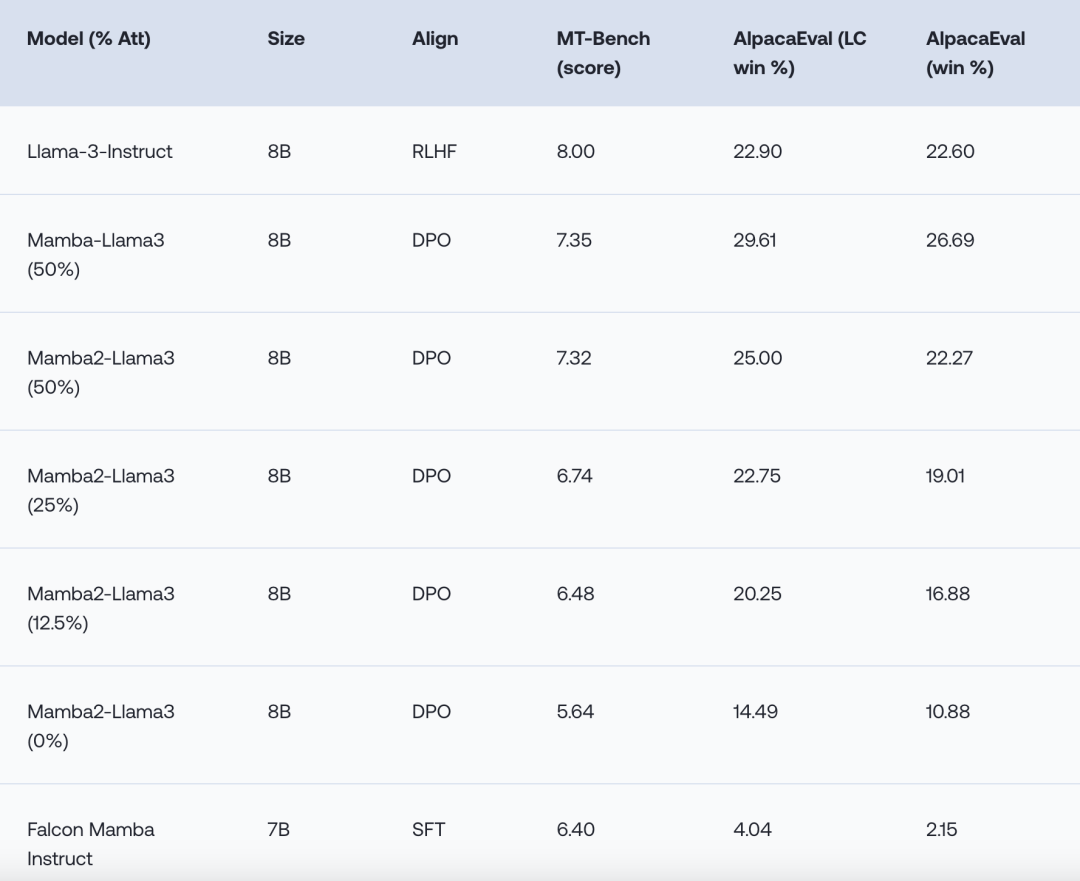
测试结果表明,混合模型在单论(AlpacaEval)和多轮(MT-Bench)聊天对话任务上与Llama-3相当甚至更优。
并且还对不同混合比例的模型表现进行了测试,发现其中按照1:1比例混合的模型表现最佳。
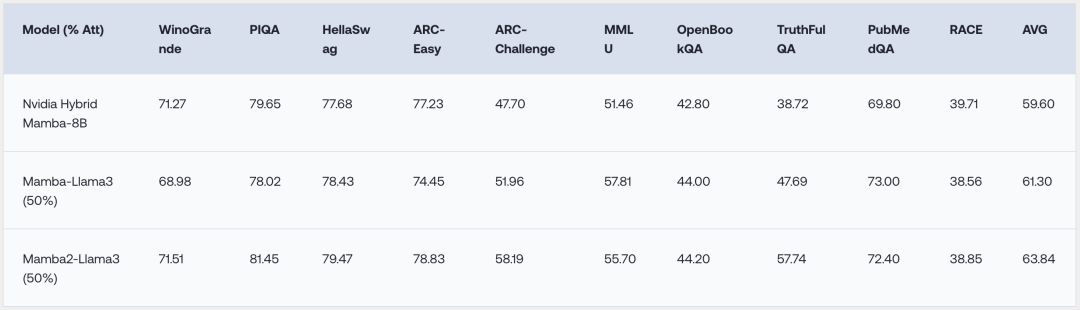
在零样本的通用 NLP 任务评测中,混合模型的平均成绩优于同等规模的RNN模型。
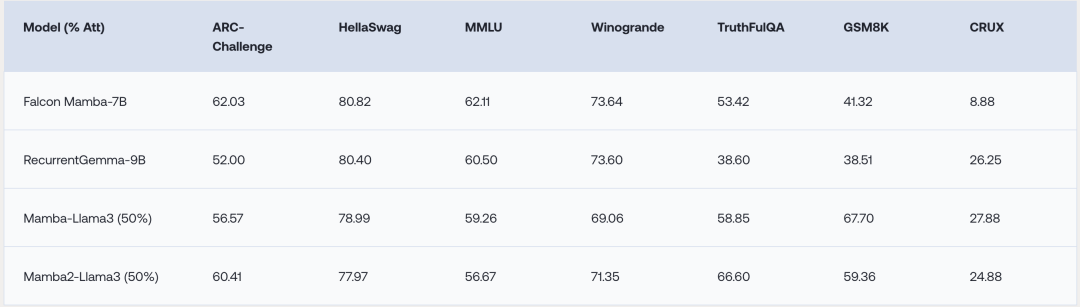
在少样本的OpenLLM Leaderboard榜单上,混合模型的表现与最好的开源RNN模型相当,并在GSM8K和CRUX任务上超过了对应的Instruct模型。
除了模型性能,作者也对推测解码算法带来的加速效果进行了测试。
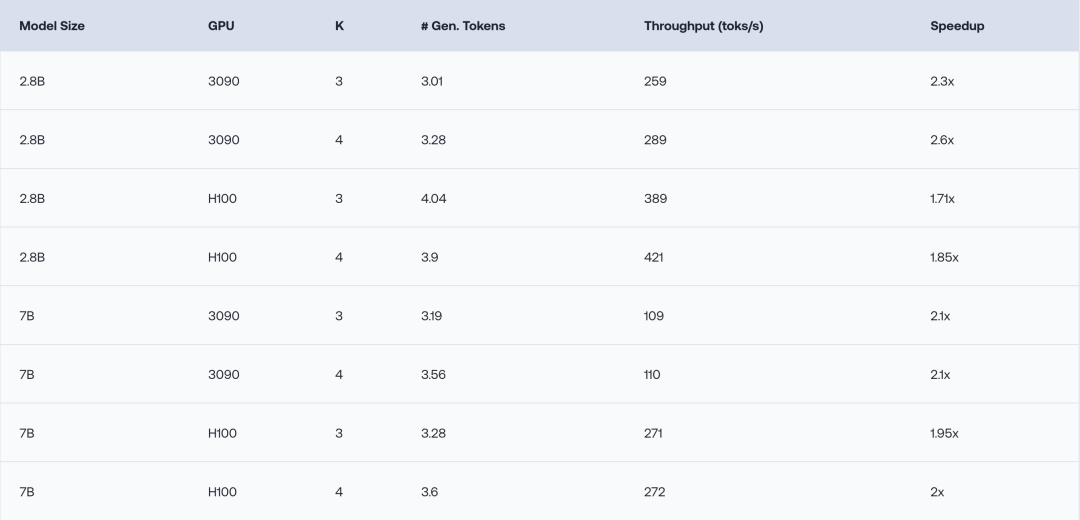
首先测试的是纯Mamba模型,结果在2.8B和7B的模型上,相比原来的解码方式,推理速度提升了1.7-2.6倍。
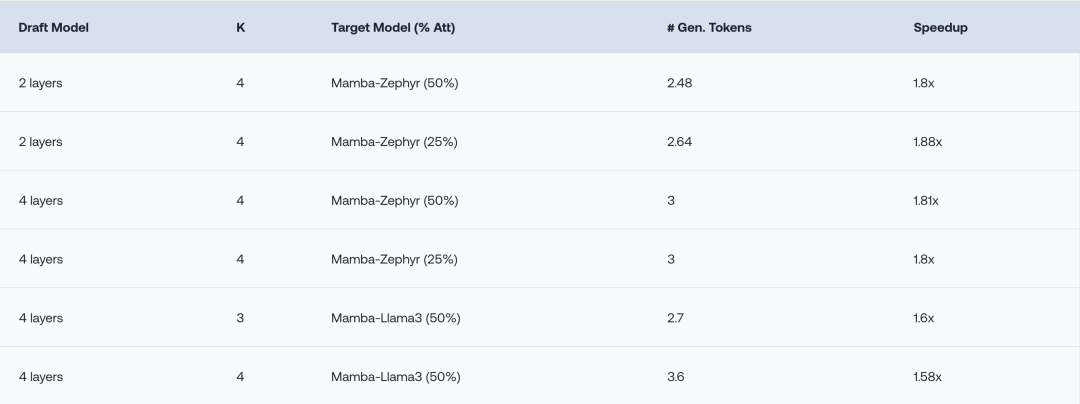
进一步地,作者在蒸馏的Zephyr和Llama混合模型上进行了测试,结果Zephyr混合模型的推理速度提升了1.8倍以上,Llama混合模型也有1.6倍左右的加速。
论文地址:
https://www.together.ai/blog/the-mamba-in-the-llama-distilling-and-accelerating-hybrid-models
如何系统的去学习大模型LLM ?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 "AI会取代那些行业?""谁的饭碗又将不保了?"等问题热议不断。
事实上,抢你饭碗的不是AI,而是会利用AI的人。
继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?
与其焦虑......
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。
针对所有自学遇到困难的同学们,我帮大家系统梳理大模型学习脉络,将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码 领取🆓↓↓↓

一、LLM大模型经典书籍
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套LLM大模型报告合集
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、LLM大模型系列视频教程

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

LLM大模型学习路线 ↓
阶段1:AI大模型时代的基础理解
-
目标:了解AI大模型的基本概念、发展历程和核心原理。
-
内容:
- L1.1 人工智能简述与大模型起源
- L1.2 大模型与通用人工智能
- L1.3 GPT模型的发展历程
- L1.4 模型工程
- L1.4.1 知识大模型
- L1.4.2 生产大模型
- L1.4.3 模型工程方法论
- L1.4.4 模型工程实践
- L1.5 GPT应用案例
阶段2:AI大模型API应用开发工程
-
目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
-
内容:
- L2.1 API接口
- L2.1.1 OpenAI API接口
- L2.1.2 Python接口接入
- L2.1.3 BOT工具类框架
- L2.1.4 代码示例
- L2.2 Prompt框架
- L2.3 流水线工程
- L2.4 总结与展望
阶段3:AI大模型应用架构实践
-
目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
-
内容:
- L3.1 Agent模型框架
- L3.2 MetaGPT
- L3.3 ChatGLM
- L3.4 LLAMA
- L3.5 其他大模型介绍
阶段4:AI大模型私有化部署
-
目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
-
内容:
- L4.1 模型私有化部署概述
- L4.2 模型私有化部署的关键技术
- L4.3 模型私有化部署的实施步骤
- L4.4 模型私有化部署的应用场景
这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码 领取🆓↓↓↓