本文带您快速体验Flink JAR流作业和批作业的创建、部署和启动,以了解实时计算Flink版JAR作业的操作流程。
前提条件
-
如果您使用RAM用户或RAM角色等身份访问,需要确认已具有Flink控制台相关权限,详情请参见权限管理。
-
已创建Flink工作空间,详情请参见开通实时计算Flink版。
步骤一:开发JAR包
Flink实时计算管理控制台不提供JAR包的开发环境,您需要在本地完成开发、编译、打包。有关配置环境依赖、连接器的使用以及OSS附加依赖文件读取,详情请参见JAR作业开发。
重要
本地开发依赖的Flink版本需确保与后续步骤三:部署JAR作业选择的引擎版本保持一致,同时注意依赖包作用域范围。
为了帮助您快速熟悉Flink的JAR作业操作,本文已为您提供统计单词出现频率的测试JAR包和数据文本,您可以直接下载待后续步骤使用。
-
单击FlinkQuickStart-1.0-SNAPSHOT.jar,下载测试JAR包。
如果您有兴趣研究其源代码,请单击FlinkQuickStart.zip下载后进行编译。
-
单击Shakespeare,下载数据文本Shakespeare。
步骤二:上传测试JAR包和数据文件
-
登录实时计算控制台。
-
单击目标工作空间操作 列下的控制台。
-
在左侧导航栏,单击文件管理。
-
单击上传资源,上传要部署的JAR包和数据文件。
本文上传步骤一下载的FlinkQuickStart-1.0-SNAPSHOT.jar和Shakespeare文件,文件存储路径详情请参见文件管理。
步骤三:部署JAR作业
流作业
批作业
-
在运维中心 > 作业运维 页面,单击部署作业 ,选择JAR作业 。
-
填写部署信息。
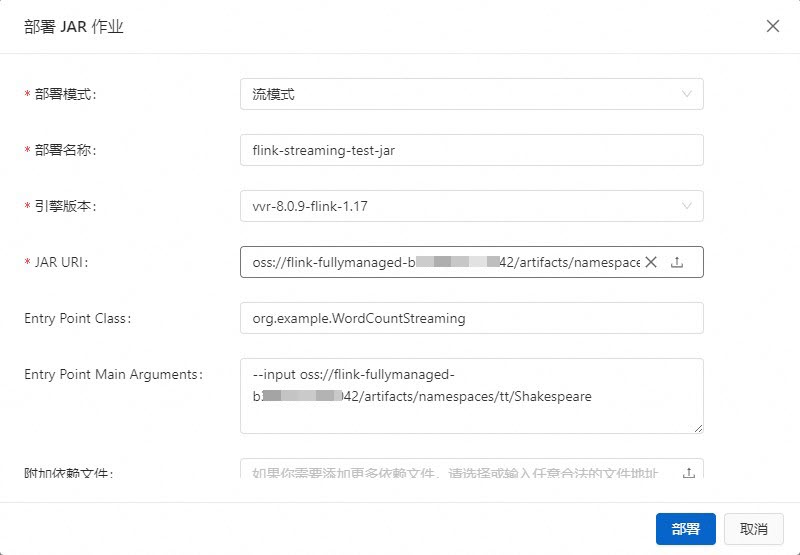
|--------------------------------|-----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| 参数 | 说明 | 示例 |
| 部署模式 | 请选择部署为流模式。 | 流模式 |
| 部署名称 | 填写对应的JAR作业名称。 | flink-streaming-test-jar |
| 引擎版本 | 当前作业使用的Flink引擎版本。 建议使用带有推荐 、稳定 标签的版本,这些版本具有更高的可靠性和性能表现,详情请参见功能发布记录和引擎版本介绍。 | vvr-8.0.9-flink-1.17 |
| JAR URI | 选择步骤二中资源管理上传的FlinkQuickStart-1.0-SNAPSHOT.jar,您也可以点击右侧的 图标选择文件,上传您自己的JAR包。 | - |
| Entry Point Class | 程序的入口类。如果您的JAR包未指定主类,请在此处输入您的Endpoint Class类的标准路径。 因为本文提供的测试JAR包中既包含了流作业代码,又包含批作业代码。所以此处需要指定为流作业的程序入口。 | org.example.WordCountStreaming |
| Entry Point Main Arguments | 填写传入参数信息,在主方法里面调用该参数。 本文填写输入数据文件Shakespeare的存放路径。 | * 存储类型为OSS Bucket:--input oss://<您绑定的OSS Bucket名称>/artifacts/namespaces/<项目空间名称>/Shakespeare您可以直接在文件管理中复制Shakespeare文件的完整路径。 * 存储类型为全托管存储:--input oss://flink-fullymanaged-<工作空间ID>/artifacts/namespaces/<项目空间名称>/Shakespeare* 工作空间ID详情请参见:操作指导。 * 项目空间名称详情请参见:查看与删除项目空间。 |
| 部署目标 | 在下拉列表中,选择目标资源队列 或者Session集群 (请勿生产使用)。详情请参见管理资源队列和步骤一:创建Session集群。 重要 部署到Session集群的作业不支持显示监控告警、配置监控告警和开启自动调优功能。请勿将Session集群用于正式生产环境,Session集群可以作为开发测试环境。详情请参见作业调试。 | default-queue |更多配置参数详情请参见部署作业。
-
单击部署。
步骤四:启动并查看Flink计算结果
流作业
-
在运维中心 > 作业运维 页面,单击目标作业名称操作 列中的启动。
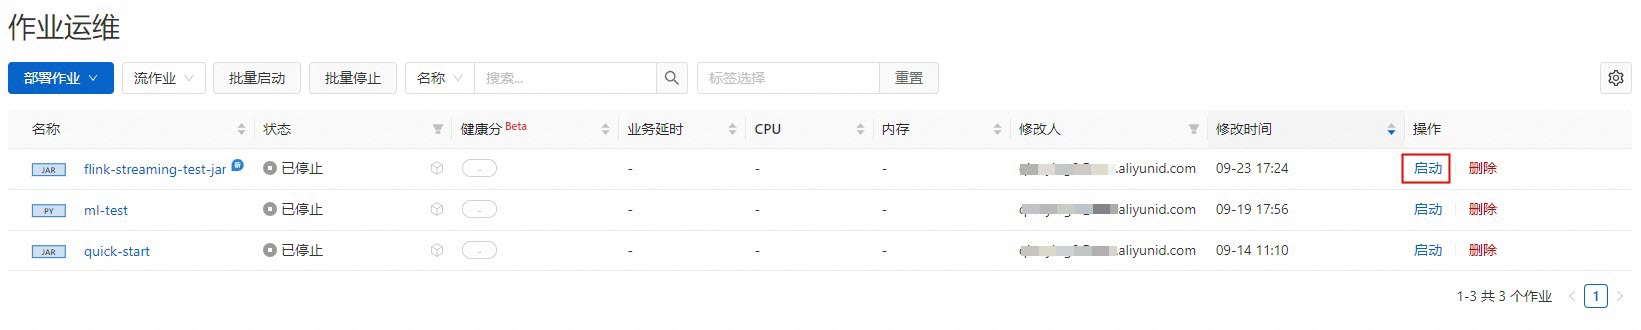
-
选择无状态启动 ,单击启动 ,作业启动详情请参见作业启动。
-
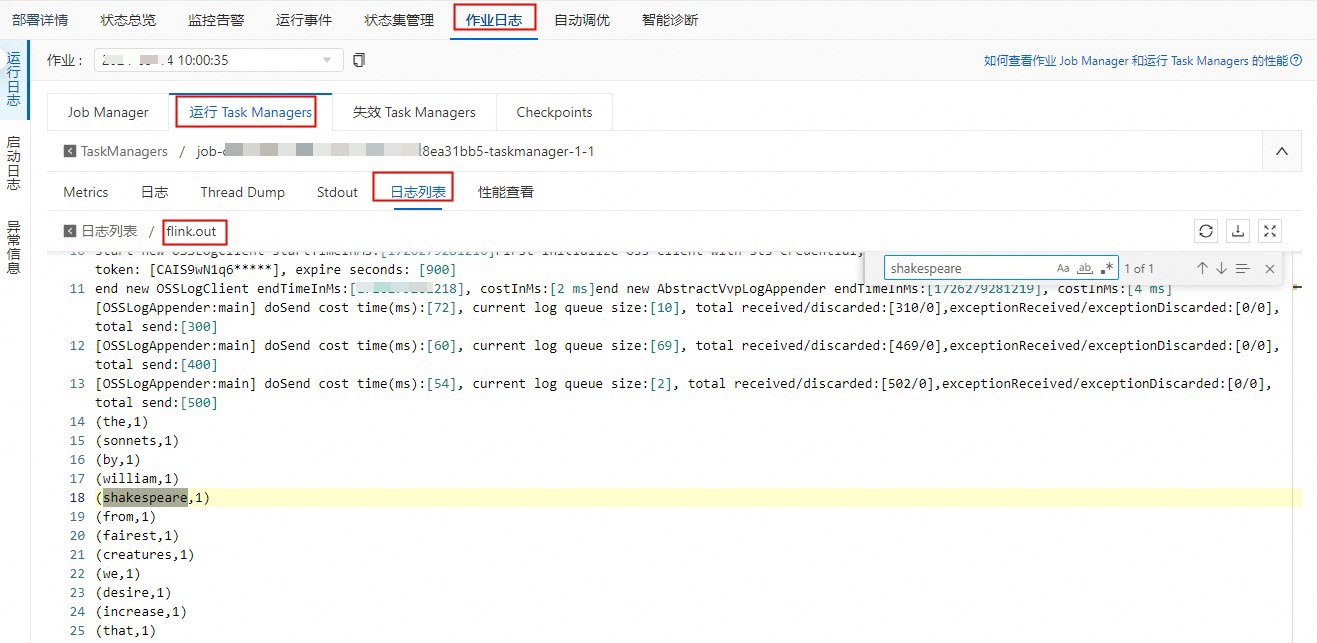
作业状态变为运行中后,查看流作业示例的计算结果。
在TaskManager中以.out结尾的日志文件中,搜索shakespeare查看Flink计算结果。
批作业
-
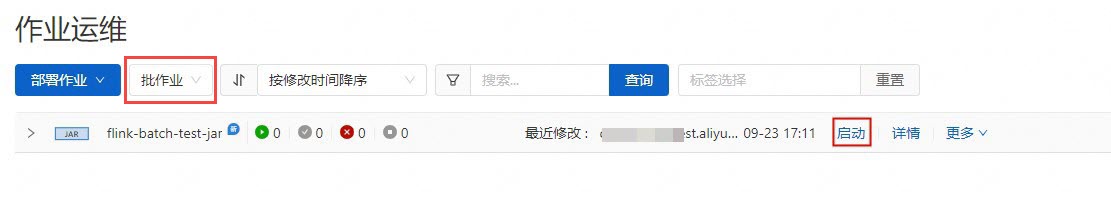
在运维中心 > 作业运维 页面,单击目标作业中的启动。
-
在作业启动 对话框中,单击启动 ,作业启动详情请参见作业启动。
-
作业状态变为已完成后,查看批作业示例的计算结果。
-
存储类型为OSS Bucket:登录OSS管理控制台,在oss://<您绑定的OSS Bucket名称>/artifacts/namespaces/<项目空间名称>/batch-quickstart-test-output.txt目录进行查看。
-
存储类型为全托管存储:您可以在文件管理 页面,单击batch-quickstart-test-output.txt文件操作 列的下载,在本地进行查看。
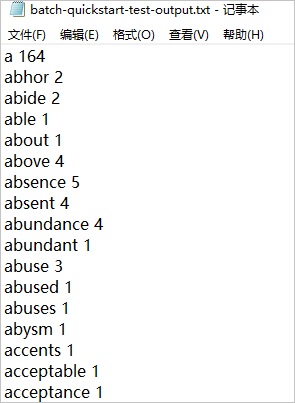
-
说明
由于Taskmanager.out日志展示数据限制为2000条,因此流作业和批作业的结果数据条数会不一致。有关限制详情请参见Print。
(可选)步骤五:停止作业
如果您对作业进行了修改(例如更改代码、增删改WITH参数、更改作业版本等),且希望修改生效,则需要重新部署作业,然后停止再启动。另外,如果作业无法复用State,希望作业全新启动时,或者更新非动态生效的参数配置时,也需要停止后再启动作业。