钉钉数据集成到MySQL的技术案例分享
在企业信息化建设中,数据的高效集成和管理是至关重要的一环。本文将详细介绍一个实际运行的系统对接集成案例------"品类即时报表集成方案-月度目标表v2更新",该方案实现了从钉钉获取数据并集成到MySQL数据库的全过程。
方案背景
为了满足企业对实时业务数据分析和报表生成的需求,我们设计并实施了一套高效的数据集成方案。通过调用钉钉API接口v1.0/yida/forms/instances/ids/{appType}/{formUuid},我们能够定时可靠地抓取所需的数据,并利用MySQL API execute进行批量写入。
技术要点
-
高吞吐量的数据写入能力:本方案支持大量数据快速写入到MySQL数据库,确保数据处理的时效性,大幅提升了业务响应速度。
-
集中监控和告警系统:通过实时跟踪数据集成任务的状态和性能,我们能够及时发现并处理异常情况,保障系统稳定运行。
-
自定义数据转换逻辑:为适应特定业务需求和数据结构,我们在数据流设计过程中引入了灵活的自定义转换逻辑,使得不同平台间的数据格式差异得到有效解决。
-
分页与限流处理:在调用钉钉接口时,通过合理设置分页参数和限流策略,有效避免了接口调用频率过高导致的请求失败问题。
-
异常处理与错误重试机制:针对可能出现的数据对接异常情况,我们设计了一套完善的错误重试机制,确保每条记录都能准确无误地写入到MySQL数据库中。
-
可视化的数据流设计工具:利用轻易云提供的可视化操作界面,使得整个数据集成过程更加直观、易于管理,同时也提高了开发效率。
实施效果
通过上述技术手段,"品类即时报表集成方案-月度目标表v2更新"成功实现了从钉钉到MySQL的大规模、高效率的数据同步,不仅提升了业务透明度,还显著优化了资源配置,为企业决策提供了强有力的数据支持。
调用钉钉接口获取并加工数据的技术实现
在轻易云数据集成平台中,调用钉钉接口v1.0/yida/forms/instances/ids/{appType}/{formUuid}是生命周期的第一步。此步骤至关重要,因为它决定了后续数据处理和集成的基础。以下将详细探讨如何高效调用该接口并进行数据加工。
接口调用配置
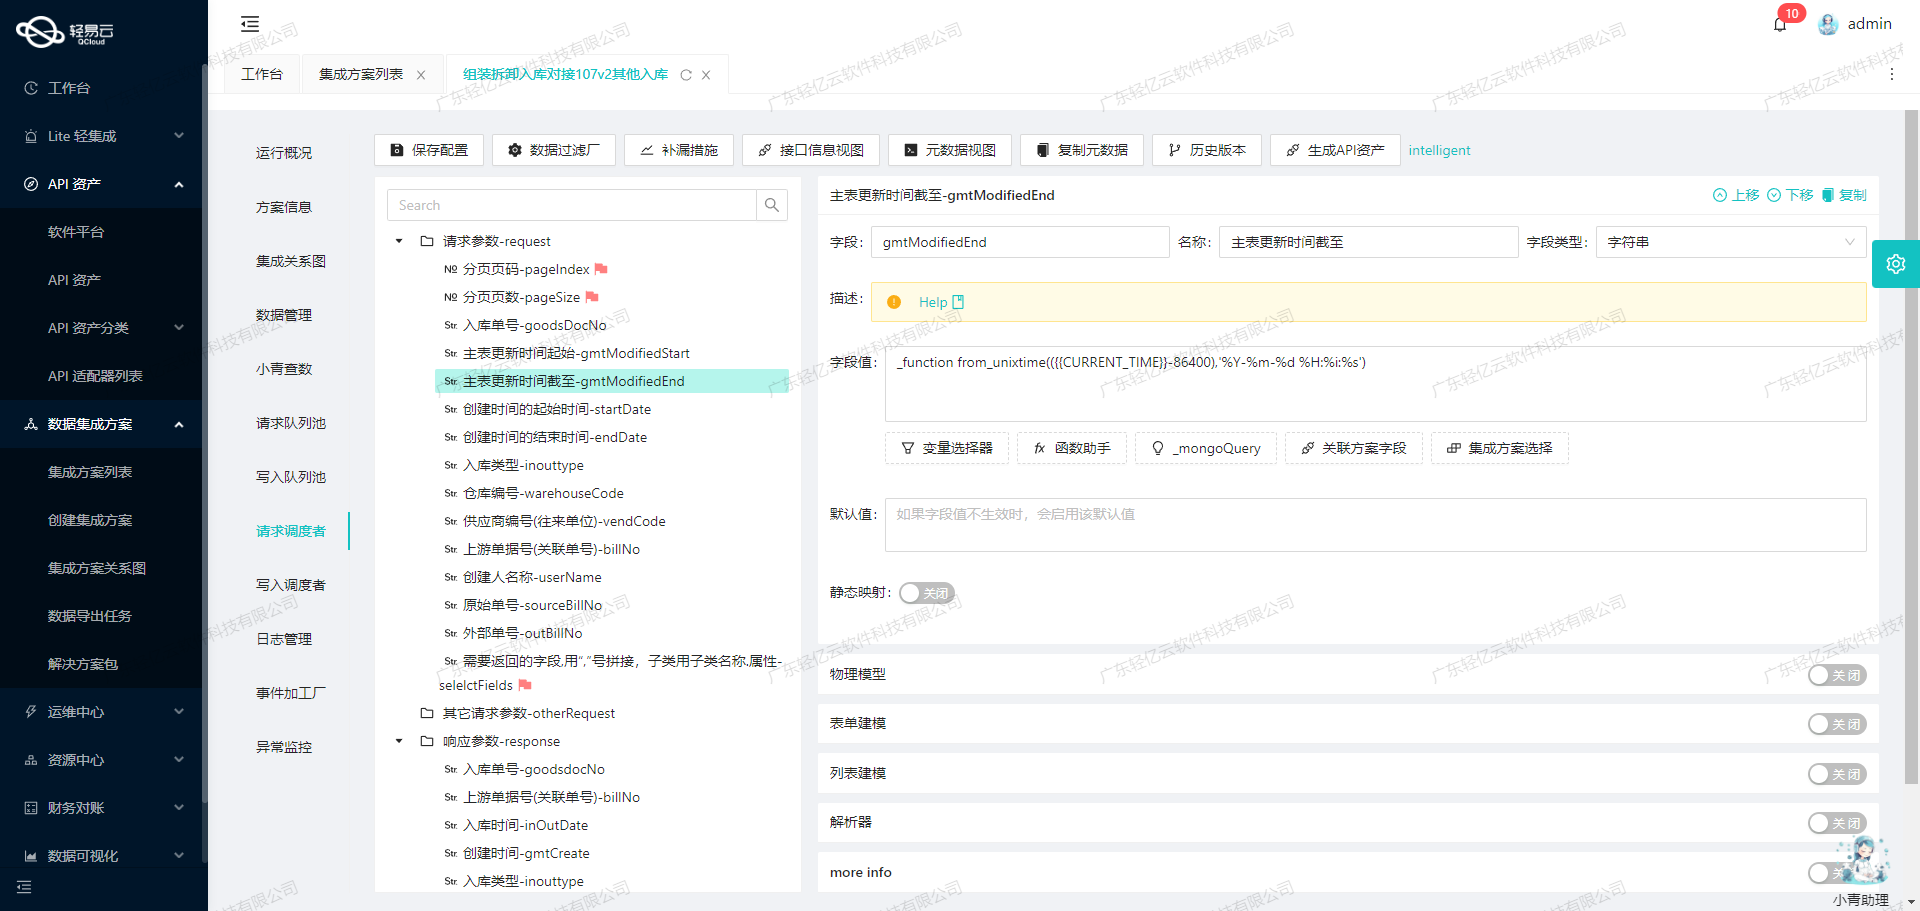
元数据配置中定义了多个关键字段,这些字段用于构建请求参数,以确保能够正确地从钉钉系统获取所需的数据。
{
  "api": "v1.0/yida/forms/instances/ids/{appType}/{formUuid}",
  "method": "POST",
  "request": [
    {"field":"appType","value":"APP_BNJNRVQ32174RSX3MROF"},
    {"field":"formUuid","value":"FORM-DA5DD28FDCC644ECB2A8F123534D3EF4I082"},
    {"field":"pageNumber","value":"1"},
    {"field":"pageSize","value":"50"},
    {"field":"modifiedToTimeGMT","value":"{{CURRENT_TIME|datetime}}"},
    {"field":"systemToken","value":"KYC664C1WR9LODIIAI09I913S0HO2G3YGREWL43"},
    {"field":"modifiedFromTimeGMT","value":"{{LAST_SYNC_TIME|datetime}}"}
  ]
}
这些字段包括应用编码、表单ID、分页信息、时间范围以及系统令牌等,确保请求能够准确定位到目标数据。
数据请求与清洗
在实际操作中,首先需要通过HTTP POST方法向钉钉API发送请求。为了保证高效性和可靠性,需要注意以下几点:
-
分页处理 :由于单次请求返回的数据量有限,通过设置
pageNumber和pageSize可以实现分页抓取。在每次请求后,根据返回结果判断是否需要继续抓取下一页。 -
时间过滤 :使用
modifiedFromTimeGMT和modifiedToTimeGMT字段,可以限定抓取的数据范围。这对于定时任务非常重要,能有效减少无效数据的传输,提高效率。 -
异常处理与重试机制:考虑到网络波动或其他不可控因素,必须设计合理的异常处理机制。例如,当请求失败时,可以设置重试次数及间隔时间,以确保最终成功获取数据。
数据转换与写入准备
在成功获取原始数据后,需要对其进行初步清洗和转换,以便于后续写入数据库或其他存储系统。主要步骤包括:
-
格式转换:根据目标系统(如MySQL)的要求,将原始JSON格式的数据转换为相应的表结构。例如,将日期字符串转换为数据库支持的日期类型。
-
字段映射:有时候源系统与目标系统之间存在字段名称或类型的不一致,需要进行映射。例如,将源系统中的"id"字段映射为目标数据库中的"record_id"。
-
去重与校验:在批量处理过程中,可能会遇到重复记录或不符合规范的数据。通过去重算法和校验规则,可以确保最终写入的数据质量。
实时监控与日志记录
为了保障整个过程的透明度和可追溯性,实时监控与日志记录是必不可少的一环。通过轻易云平台提供的集中监控功能,可以实时跟踪每个任务的执行状态,并及时发现潜在问题。此外,通过详细的日志记录,可以方便地进行问题排查和性能优化。
总结
调用钉钉接口获取并加工数据是轻易云数据集成平台生命周期的重要环节之一。从接口配置、数据请求与清洗,到转换准备,再到实时监控,每一步都需要精心设计和实施,以确保高效、可靠地完成数据集成任务。这不仅提升了业务透明度,也为后续的数据分析和决策提供了坚实基础。
集成方案:品类即时报表集成方案-月度目标表v2更新
在数据集成的生命周期中,第二步至关重要,即将已经集成的源平台数据进行ETL转换,并转为目标平台 MySQL API 接口所能够接收的格式,最终写入目标平台。本文将深入探讨如何利用轻易云数据集成平台实现这一过程。
数据请求与清洗
首先,我们需要从钉钉接口获取原始数据。钉钉接口提供了丰富的数据访问功能,如调用v1.0/yida/forms/instances/ids/{appType}/{formUuid}获取表单实例数据。为了确保不漏单,需要处理接口的分页和限流问题。通过定时任务可靠地抓取这些数据,可以保证数据的完整性和及时性。
数据转换与写入
在获取到源平台的数据后,需要进行ETL(提取、转换、加载)处理,将其转换为目标平台MySQL API能够接收的格式。
-
提取(Extract):
- 从钉钉接口中提取必要的字段,例如
form_instance_id、platform、date、shop_name等。这些字段对应于元数据配置中的主参数。
- 从钉钉接口中提取必要的字段,例如
-
转换(Transform):
- 将提取的数据进行格式化和清洗。例如,将时间戳格式的数据通过
_function FROM_UNIXTIME( ( {dateField_lxa3pxie} \/ 1000 ) ,'%Y-%m-%d' )转换为 MySQL 能够识别的日期格式。 - 对于创建时间和更新时间,可以使用
_function DATE_FORMAT('{gmtCreate}','%Y-%m-%d %H:%i:%s')和_function DATE_FORMAT('{gmtModified}','%Y-%m-%d %H:%i:%s')进行格式化。 - 确保所有字段类型匹配,例如将销售目标和出库目标转换为浮点数类型。
- 将提取的数据进行格式化和清洗。例如,将时间戳格式的数据通过
-
加载(Load):
- 使用元数据配置中的 SQL 语句,将转换后的数据写入到 MySQL 数据库中。示例如下:
UPDATE
lehua.month_goal
SET
platform= <{platform: }>,
date= <{date: }>,
shop_name= <{shop_name: }>,
shop_code= <{shop_code: }>,
category= <{category: }>,
sale_goal= <{sale_goal: }>,
sale_out_goal= <{sale_out_goal: }>,
create_time= <{create_time: CURRENT_TIMESTAMP}>,
create_by= <{create_by: }>,
create_user_id= <{create_user_id: }>,
modify_time= <{modify_time: }>,
modify_by= <{modify_by: }>,
modify_user_id= <{modify_user_id: }>
WHERE
form_instance_id= <{form_instance_id: }>;
技术实现细节
-
高吞吐量的数据写入能力:
- 为了应对大量数据快速写入 MySQL 的需求,可以采用批量操作,并行处理等技术手段。轻易云平台支持高吞吐量的数据写入能力,确保数据处理的时效性。
-
集中监控和告警系统:
- 实时跟踪数据集成任务的状态和性能,通过集中监控和告警系统,及时发现并处理异常情况,提高系统稳定性。
-
自定义数据转换逻辑:
- 针对特定业务需求和数据结构,可以自定义复杂的数据转换逻辑,确保每个字段都能正确映射到目标数据库中。
-
异常处理与错误重试机制:
- 在对接 MySQL 时,需要考虑异常处理与错误重试机制。通过捕获异常并记录日志,确保在出现问题时能够及时响应并重试操作,保证数据的一致性和完整性。
-
实时监控与日志记录:
- 实现整个数据处理过程的实时监控与日志记录,有助于快速定位问题并采取相应措施,提高系统的可靠性。
总结
通过以上步骤,我们可以高效地将已经集成的源平台数据进行ETL转换,并成功写入到目标平台 MySQL 中。在这个过程中,关键在于合理设计元数据配置,确保每个字段都能正确映射,并利用轻易云平台提供的各种特性,实现高效、稳定的数据集成。