1、cuda安装
1.1 卸载安装失败的cuda
参考 :https://blog.csdn.net/weixin_40826634/article/details/127493809
注意:因为/usr/local/cuda-xx.x/bin/下没有卸载脚本,很可能是apt安装的,所以通过执行下面的命令删除:
cpp
apt-get --purge remove "cuda*"
apt-get autoremove
然后执行find / -name "cuda",查看是否还有残留的cuda相关文件,比如/etc/alternatives/cuda-12还存在,则执行下面的命令:
cpp
rm /etc/alternatives/cuda-121.2 安装cuda及cudnn
参考 :https://blog.csdn.net/weixin_40826634/article/details/127493809
注意:
- 服务器显卡驱动支持的cuda最高版本是12.4,SparseDrive官方教程依赖的cuda运行时版本是11.6,因为运行时版本只要小于最高版本即可,所以这里安装的是cuda-11.6。
- 安装完cuda后,发现/usr/local/cuda-11.6/samples路径下没有测试用例,从官网使用命令git clone https://github.com/NVIDIA/cuda-samples.git拉取了测试用例仓库,验证cuda成功安装。
- cudnn减压后的文件夹名为cudnn-linux-x86_64-8.4.1.50_cuda11.6-archive,和参考文档里减压后的文件夹cuda是对应的,只不过这里是cuda11.6对应的cudnn,参考文档里是cuda10.0对应的cudnn。

2、数据集准备
数据集的目录:
nuSenses/
├── can_bus
├── maps
│ ├── 36092f0b03a857c6a3403e25b4b7aab3.png
│ ├── 37819e65e09e5547b8a3ceaefba56bb2.png
│ ├── 53992ee3023e5494b90c316c183be829.png
│ ├── 93406b464a165eaba6d9de76ca09f5da.png
│ ├── basemap
│ ├── expansion
│ └── prediction
├── samples
│ ├── CAM_BACK
│ ├── CAM_BACK_LEFT
│ ├── CAM_BACK_RIGHT
│ ├── CAM_FRONT
│ ├── CAM_FRONT_LEFT
│ ├── CAM_FRONT_RIGHT
│ ├── LIDAR_TOP
│ ├── RADAR_BACK_LEFT
│ ├── RADAR_BACK_RIGHT
│ ├── RADAR_FRONT
│ ├── RADAR_FRONT_LEFT
│ └── RADAR_FRONT_RIGHT
├── sweeps
│ ├── CAM_BACK
│ ├── CAM_BACK_LEFT
│ ├── CAM_BACK_RIGHT
│ ├── CAM_FRONT
│ ├── CAM_FRONT_LEFT
│ ├── CAM_FRONT_RIGHT
│ ├── LIDAR_TOP
│ ├── RADAR_BACK_LEFT
│ ├── RADAR_BACK_RIGHT
│ ├── RADAR_FRONT
│ ├── RADAR_FRONT_LEFT
│ └── RADAR_FRONT_RIGHT
└── v1.0-trainval
├── attribute.json
├── calibrated_sensor.json
├── category.json
├── ego_pose.json
├── instance.json
├── log.json
├── map.json
├── sample.json
├── sample_annotation.json
├── sample_data.json
├── scene.json
├── sensor.json
└── visibility.json
注意 :要将nuScenes-map-expansion-v1.3中的basemap、expansion、prediction拷贝到maps下。
3、SparseDrive训练
完全按照官网的教程进行部署,训练脚本不需要修改,就是两步,执行训练脚本遇到如下的问题:

排查是因为共享空间不足!在这里插入图片描述(https://i-blog.csdnimg.cn/direct/c388ef7294314b3abef5321d227a6a97.png
执行以下两条命令,申请了8G的共享内存,并把batch_size从64改成32后,程序可以正常训练:
cpp
卸载默认的 /dev/shm
umount /dev/shm
#挂载更大的内存文件系统(例如8g)
mount -t tmpfs -o size=8g tmpfs /dev/shm
4、使用screen在服务器后台运行程序
用ssh远程的服务器终端只要关闭该终端,训练程序也会中断,是因为虽然ssh的终端是在本地电脑上显示的,但是其实是服务器端的终端,所以关掉ssh的终端,就是关掉了服务器的终端,在终端上运行的程序就会中断,通过使用screen就可以让程序在后台运行,即使关掉终端,程序仍然会在后台运行。
screen常用命令:
cpp
screen -S sparsedrive #创建一个名字为sparsedrive的会话

按ctrl+a后再按d,退出会话

screen -r sparsedrive #重新进入会话

screen -ls #查看所有会话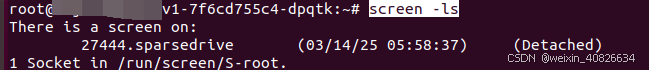
cpp
screen -X -S 27444 quit 删除会话5、报显存不足的解决方法
在训练时,如果发现显存不足,用htop查看未释放显存的进程,如果存在程序已经结束,但是显存还没释放的进程,则用下面的命令强制杀死这些进程:
cpp
kill -9 <进程id>然后,用nvidia-smi查看,会发现素所有gpu的util都是0了,即显存都被释放了。