Spark Core

partitionBy

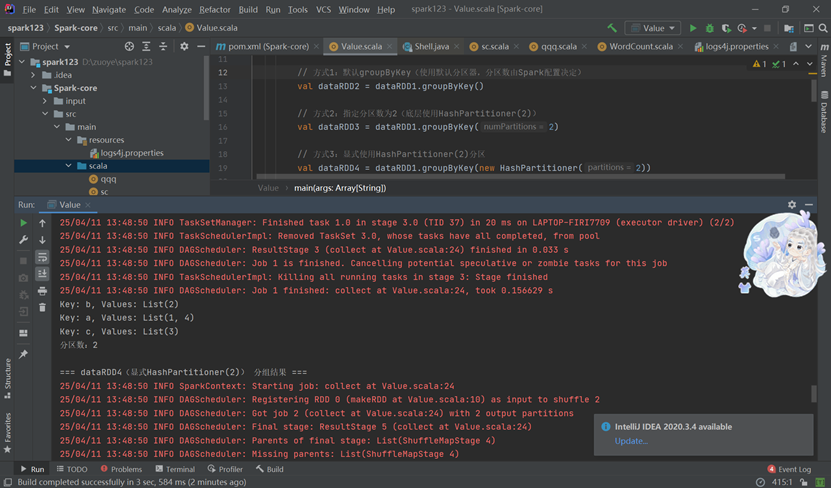
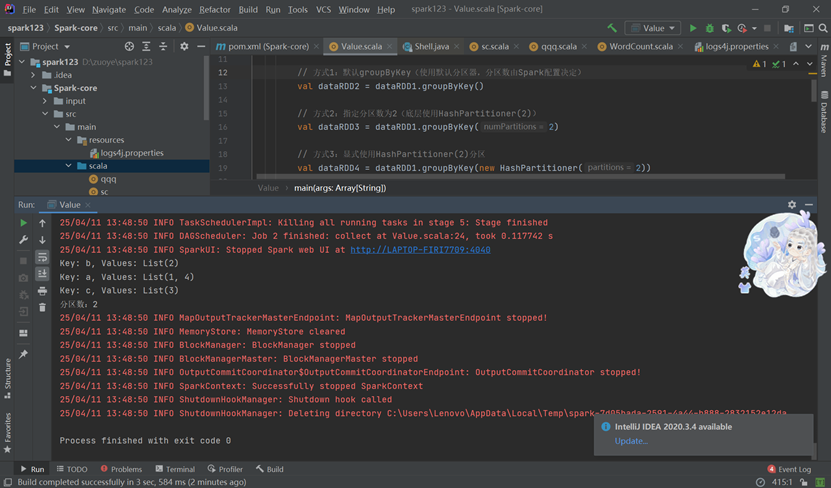
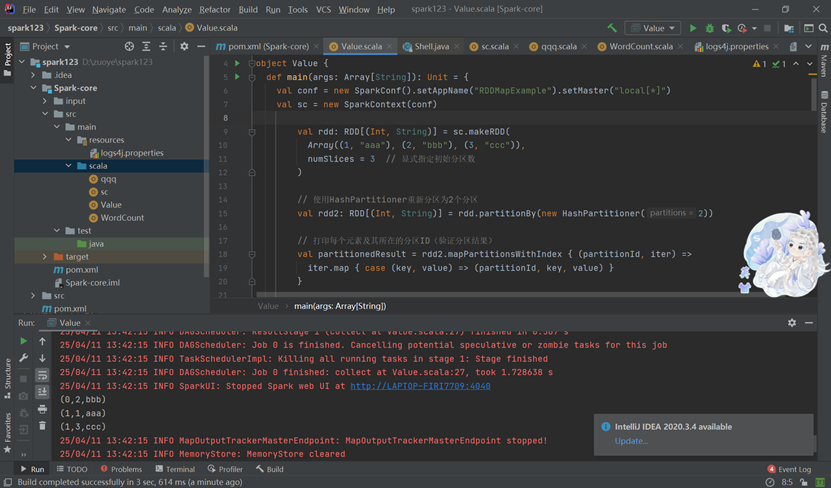
对键值对RDD进行自定义分区,使相同键的数据尽可能分布在同一个分区中(或按指定规则分布)。

示例
join

使用join操作将两个RDD中相同键的值连接在一起,形成嵌套形式的结果。

join示例

转换算子和行动算子

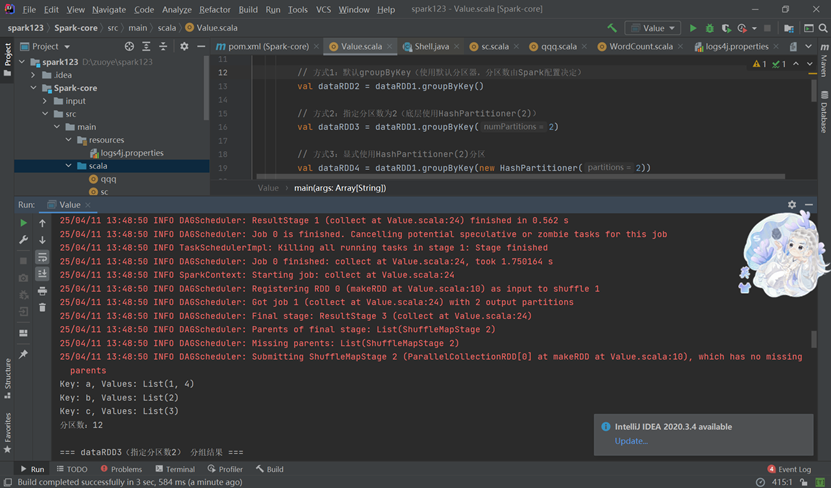
转换算子:各种转换算子(如groupByKey)的作用和用法,这些算子不会立即执行,只有在遇到行动算子时才会触发执行。

groupByKey

示例

代码
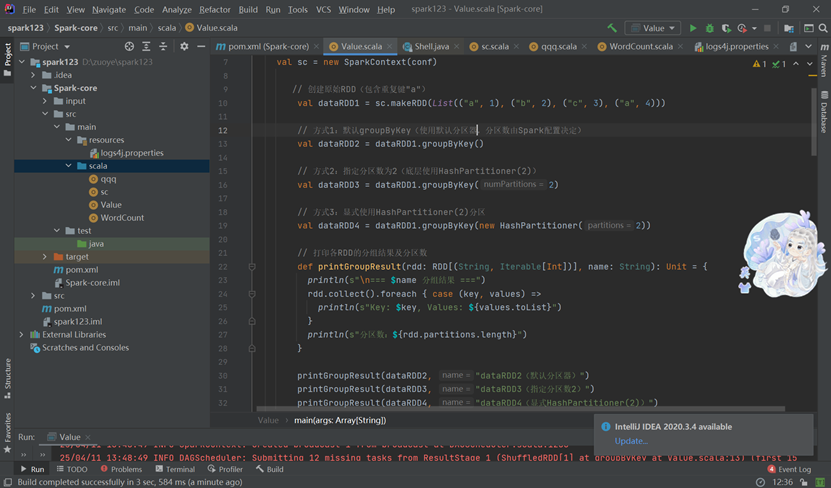
运行结果
行动算子:行动算子(如collect、reduce、count、first、take等)的作用和用法,这些算子会触发实际的计算并返回结果。

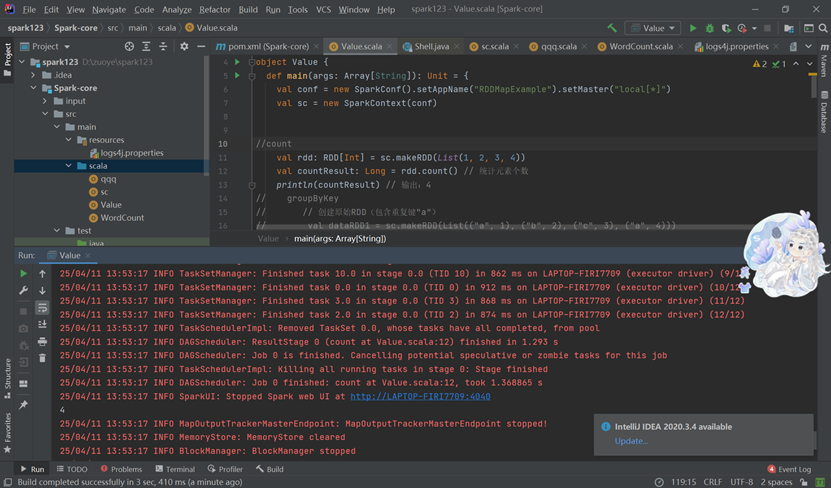
Count

是一个常用的基础算子,用于统计数据集中的元素数量

示例
分布式计算和分区

分布式计算:RDD是分布式数据结构,数据分布在不同的节点上,行动算子在executor端执行,而结果需要在driver端收集。

分区操作:

输出结果:在使用行动算子时,特别是collect操作时需要注意数据量的大小,避免driver内存溢出。

数据结构与变量

Spark 中的三大数据结构:弹性分布式数据集(RDD)、累加器和广播变量。

广播变量在处理较大只读变量时的高效性。

相关推荐
starzy199011 小时前
Scala循环与判断:一切皆表达式的控制流
开发语言·人工智能·scala
starzy199011 小时前
Scala类和对象:从构造器到样例类的完整指南
开发语言·后端·scala
乌恩大侠13 小时前
「AI-RAN」Aerial,使用ORAN C1模式
人工智能·5g·spark·o-ru·ai-ran
测试盐19 小时前
spark作业日志定位过程
java·hadoop·spark
IT研究室20 小时前
最新大数据毕业设计选题推荐-基于大数据的Kaggle竞赛团队协作模式与效能可视化分析-大数据-Spark-Hadoop-Bigdata
大数据·spark·课程设计
棣廷3 天前
初识Spark Core
大数据·分布式·spark
磁场转动100万匹6 天前
Spark Core 核心原理:从 RDD 到分布式计算
大数据·分布式·spark
ha_lydms8 天前
AnalyticDB MySQL 技术架构
大数据·hadoop·mysql·adb·spark·dataworks·1024程序员节
红海云8 天前
两台DGX Spark部署DeepSeek的实战边界
大数据·分布式·spark
爱吃火鸡面呀10 天前
PySpark 入门实战:从 DataFrame 到 SQL、DSL 与窗口函数
分布式·spark