Spark-SQL核心编程(二)

  • Spark-SQL 开发:

借助 IDEA 开发 Spark-SQL,创建子模块并添加org.apache.spark:spark-sql_2.12:3.0.0依赖。创建SparkConf(设置运行模式和应用名)和SparkSessio(作为 Spark 入口,可读取数据、执行 SQL 查询)配置上下文环境。

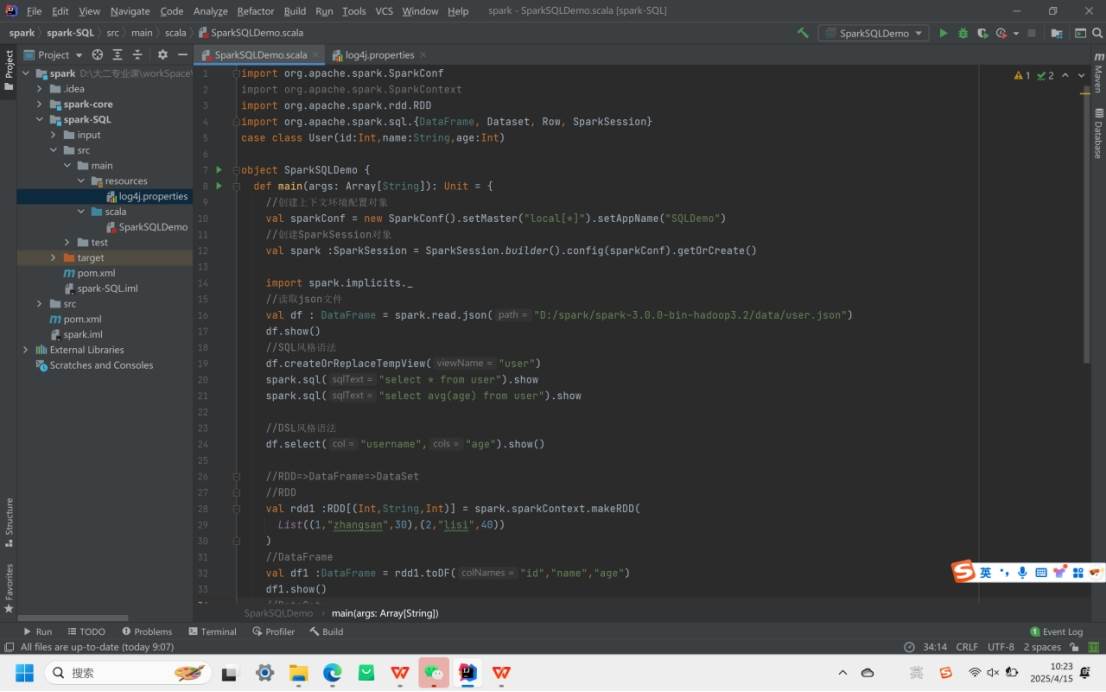
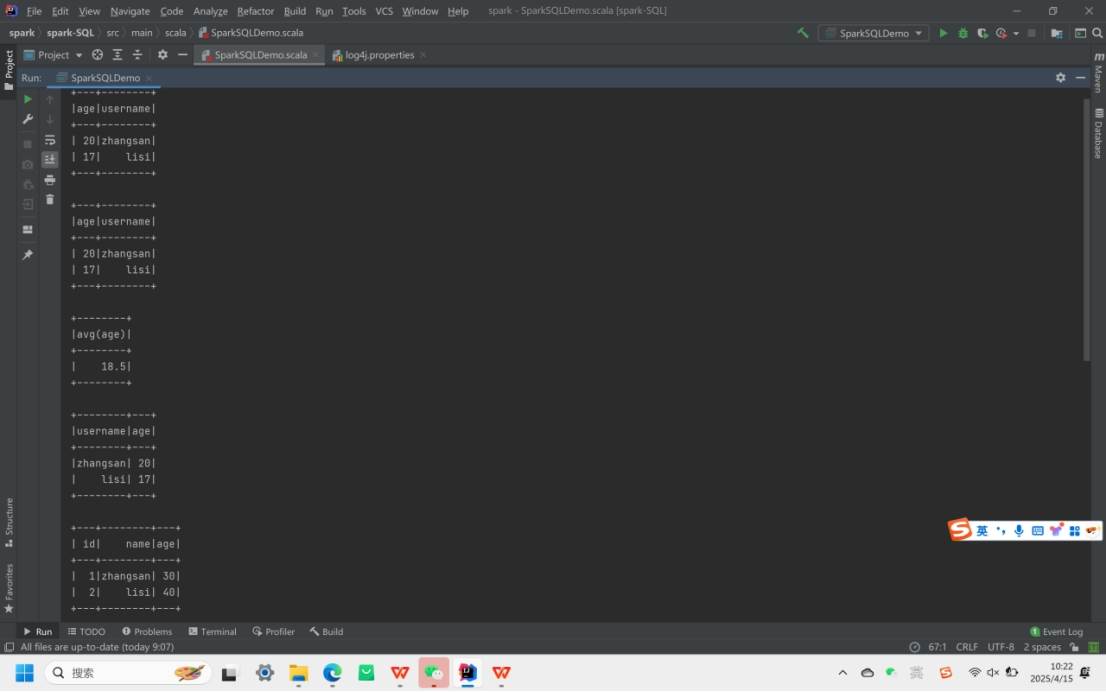
RDD、DataFrame、DataSet 转换:三者可相互转换。RDD 可通过toDF转为DataFrame,指定字段名;DataFrame用as转为DataSet,需有对应的样例类。反向转换时,DataSet用toDF转回DataFrame,DataFrame通过rdd获取 RDD,转换过程能发挥不同数据结构优势。

自定义函数

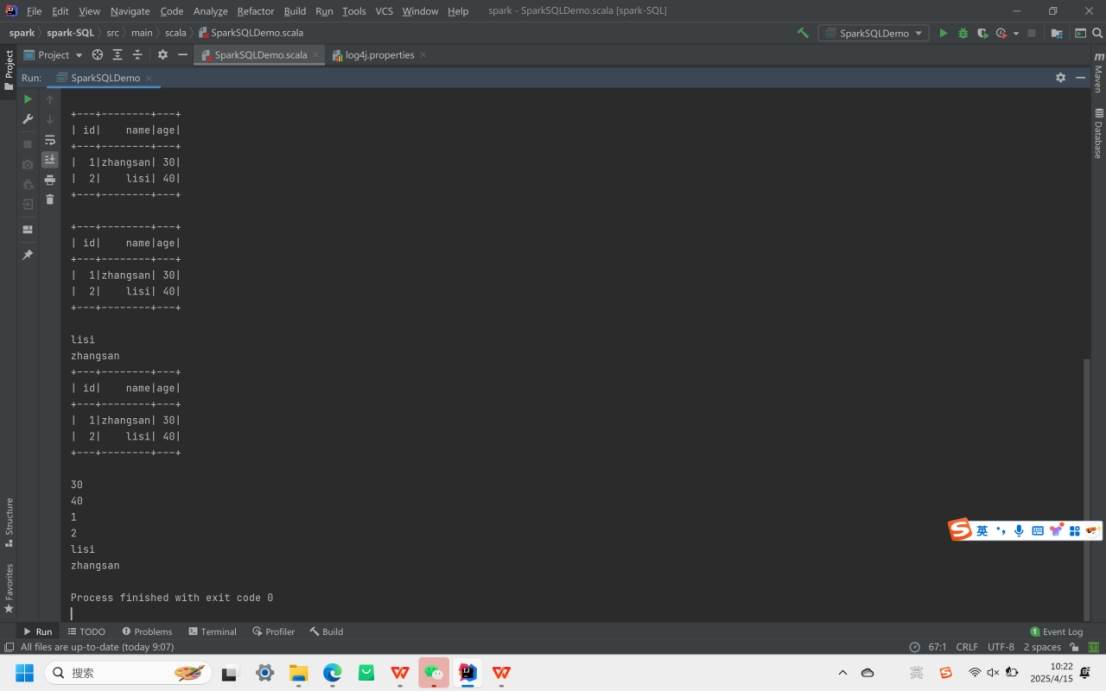
运行代码:
运行结果如下:
  • UDF(用户自定义函数):

可注册自定义函数处理数据。在 Spark 环境中,注册函数如addName后,可在 SQL 查询中调用,对指定字段按自定义逻辑处理。

  • UDAF(用户自定义聚合函数):

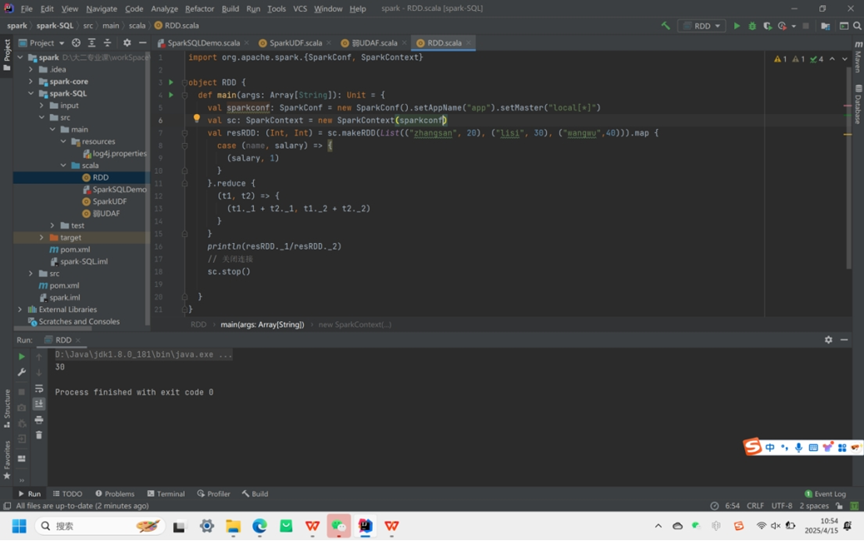
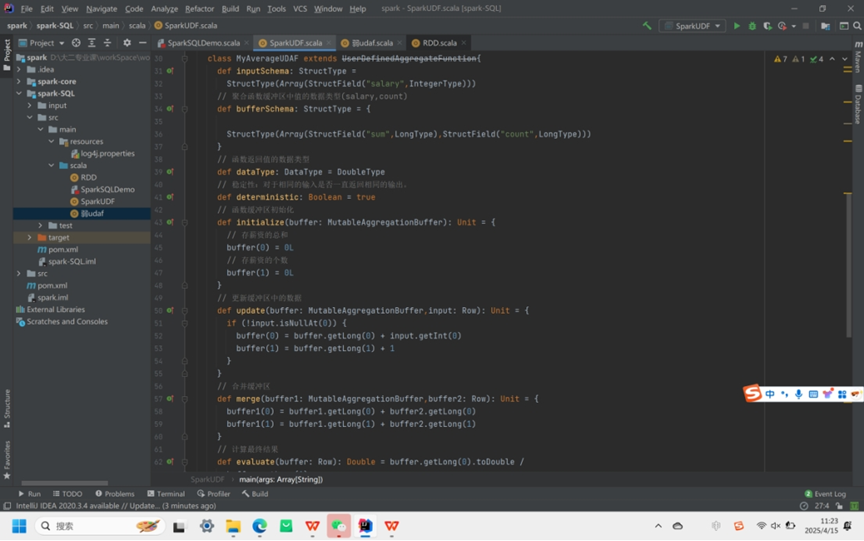
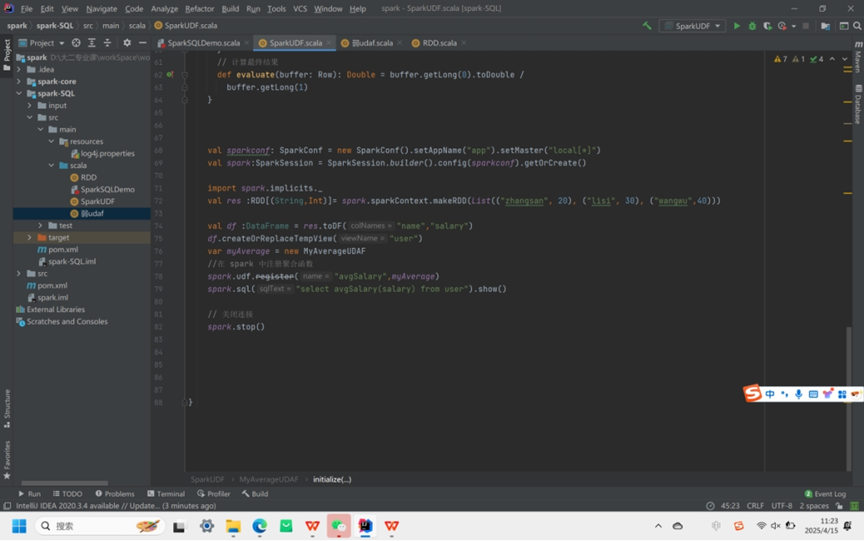
用于数据聚合计算,有多种实现方式(RDD与强弱UDAF)。RDD 方式通过映射和规约操作计算;弱类型 UDAF 继承UserDefinedAggregateFunction,自定义输入、缓冲区和返回值的 Schema 及相关操作方法;强类型 UDAF 继承Aggregator,利用样例类和类型系统,实现更简洁安全 。

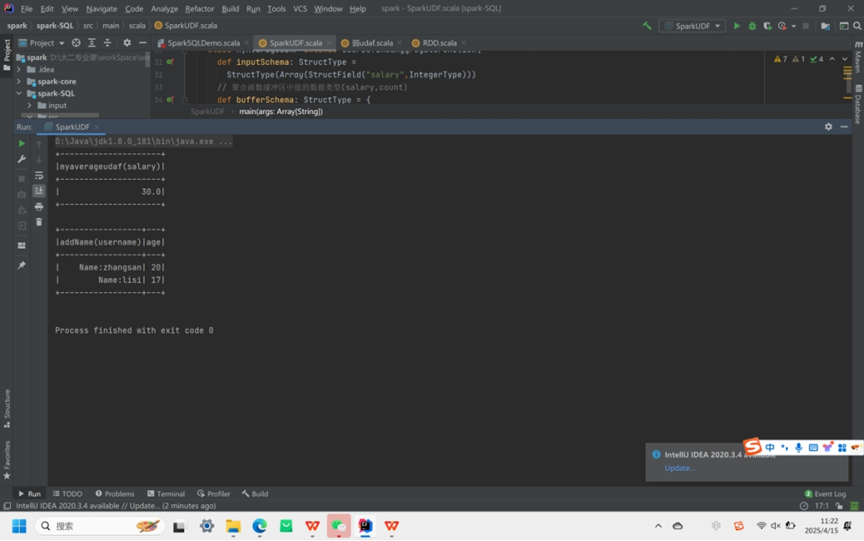
实验需求:计算平均工资

  1. 实现方式一:RDD
  1. 实现方式二:弱类型UDAF

代码:

运行结果:

相关推荐
龙腾AI白云6 小时前
数字孪生与计算机视觉:让机器看懂现场
大数据·数据库·机器学习·知识图谱·pygame
Star(up up up)8 小时前
MySQL 事务隔离级别是如何实现的?从 MVCC 到锁机制原理详解
笔记·vscode·sql·学习·程序人生·mysql·学习方法
starzy19908 小时前
Structured Streaming 案例剖析:一个 8 万 QPS 实时大屏的完整落地与三次线上事故复盘
大数据·spark
Decay__17 小时前
PostgreSQL 数据库全栈运维实战系列 — 合集索引(24 篇)
运维·数据库·sql·mysql·架构
武昌库里写JAVA17 小时前
SpringBoot+Vue 项目介绍
java·javascript·git·sql·ai
大大大大晴天18 小时前
浅聊维度建模中的星型模型与雪花模型
大数据
ZhengEnCi1 天前
覆盖索引怎么设计:从回表代价到 MySQL 与 PostgreSQL 的落地写法
sql·mysql·postgresql
数字新视界1 天前
能耗管理系统提升企业能源效率的实践与展望
大数据·人工智能·数据中心·机房管理·模块化机房
大大大大晴天1 天前
别让金额越算越多:事实表与维度表设计避坑指南
大数据
如夏倾城1 天前
入侵检测系统(IDS)原理、部署模式与 IPS/防火墙对比
大数据·网络·人工智能·网络安全·云原生·架构·kubernetes