Spark-Sql编程(三)

一、数据加载与保存

通用方式:使用spark.read.load和df.write.save,通过format指定数据格式(如csv、jdbc、json等),option设置特定参数(jdbc格式下的url、user等),load和save指定路径。保存时可通过mode设置SaveMode,如ErrorIfExists(默认,文件存在则抛异常)、Append(追加)、Overwrite(覆盖)、Ignore(忽略)。

Parquet:Spark SQL 默认数据源,是嵌套数据的列式存储格式。加载和保存无需format指定,可通过修改spark.sql.sources.default变更默认格式。

JSON:Spark SQL 能自动推测结构并加载为DatasetRow,读取的 JSON 文件每行应为 JSON 串,可通过SparkSession.read.json加载。

CSV:可配置列表信息,如设置分隔符sep、推断模式inferSchema、指定表头header等。

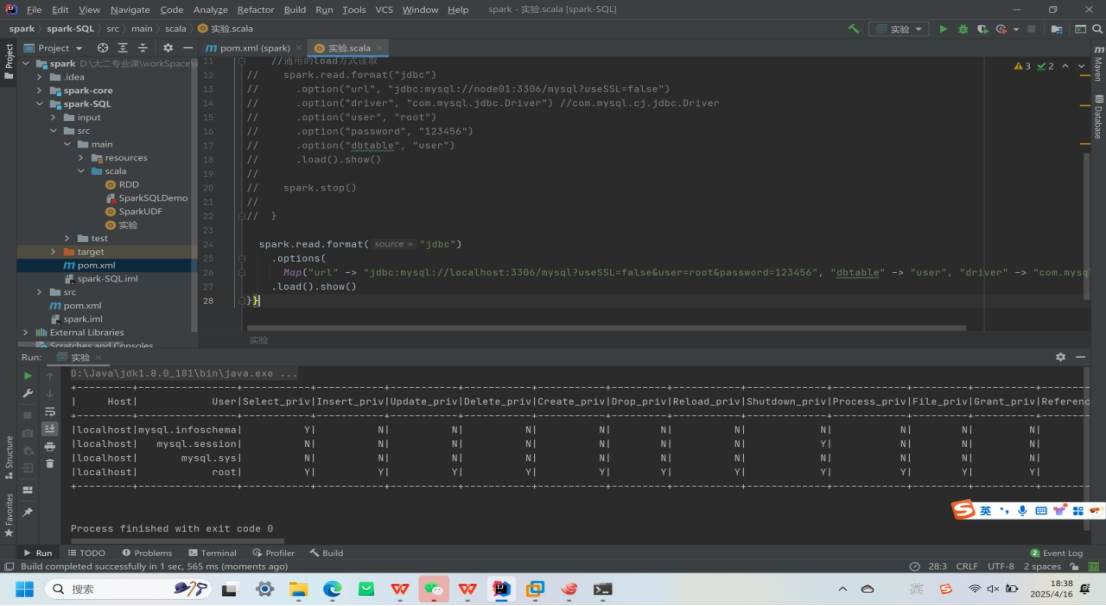
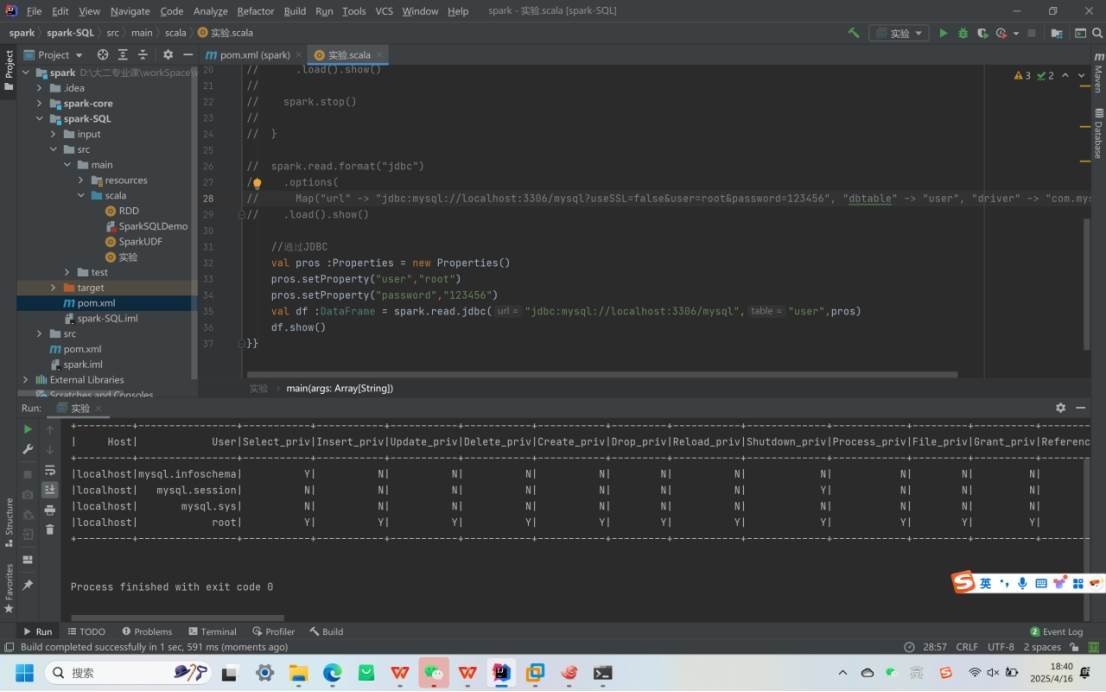
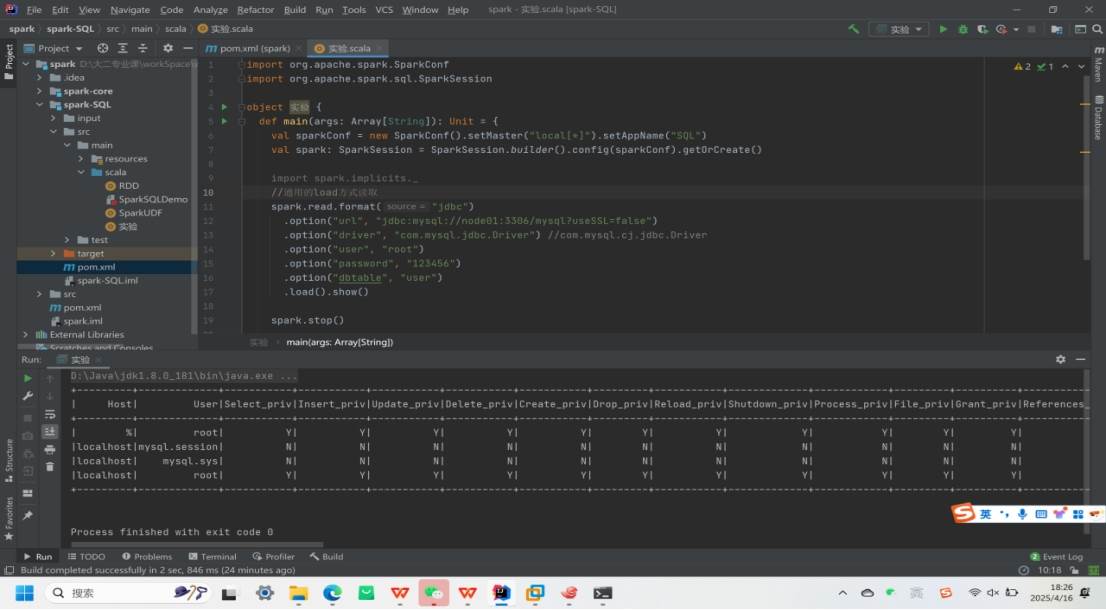
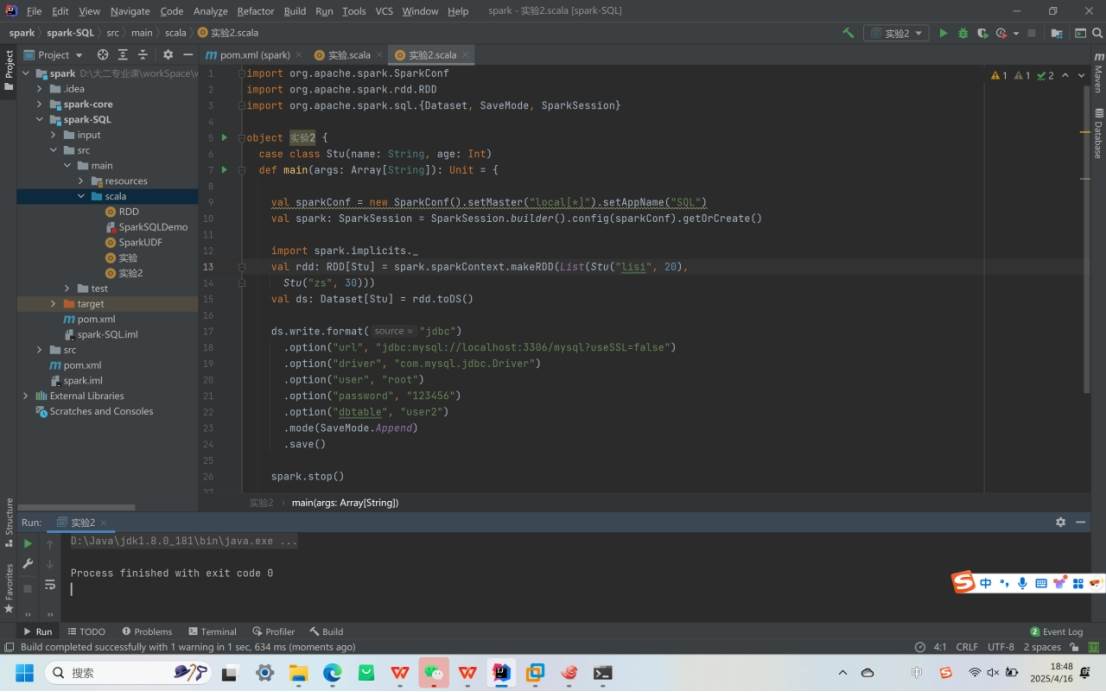
MySQL:借助 JDBC 读取和写入数据。

1.读取数据
写入数据
二、Spark-SQL连接Hive

内嵌 Hive:可直接使用,但实际生产中很少用。

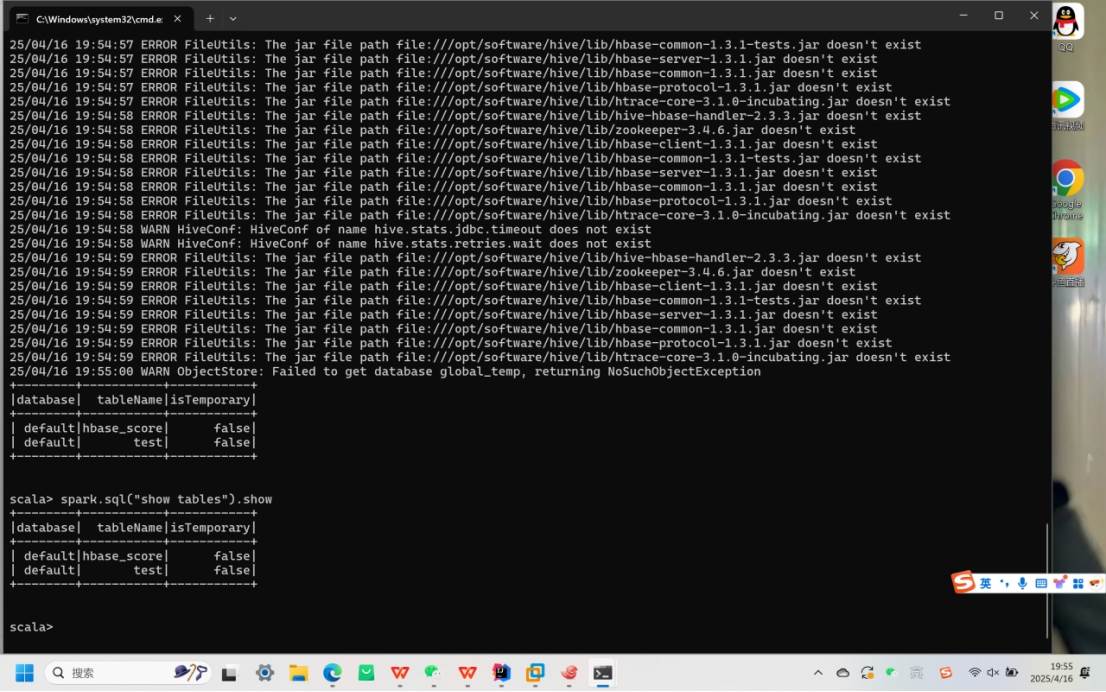
外部 Hive:
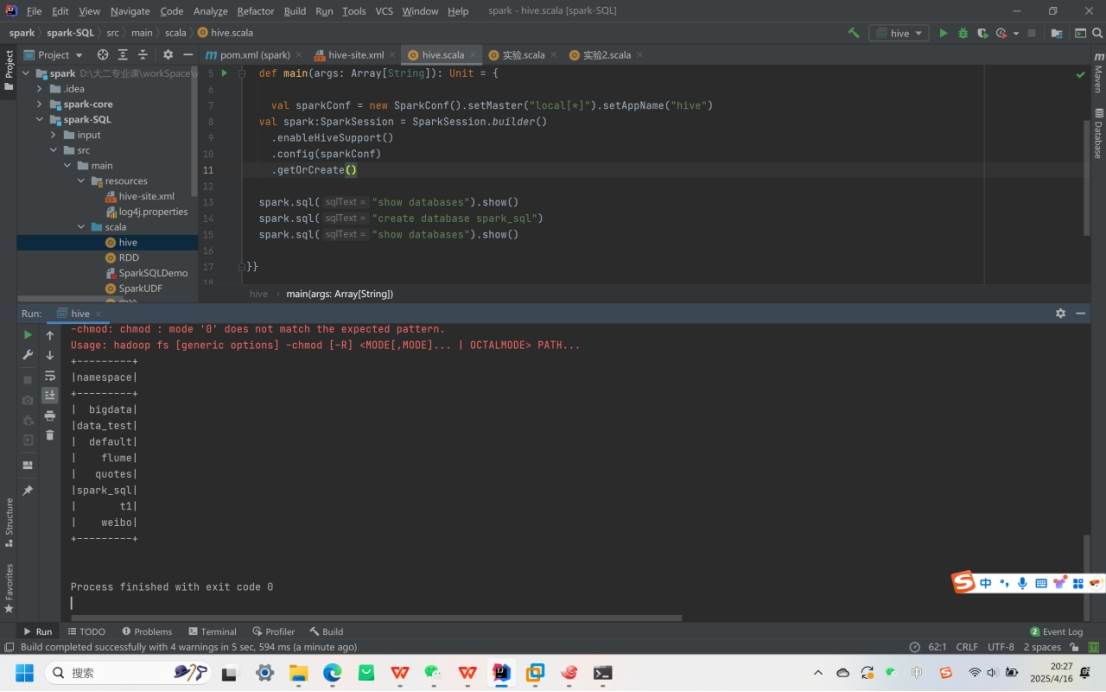
代码操作Hive
相关推荐
ZhengEnCi9 分钟前
覆盖索引怎么设计:从回表代价到 MySQL 与 PostgreSQL 的落地写法
sql·mysql·postgresql
数字新视界1 小时前
能耗管理系统提升企业能源效率的实践与展望
大数据·人工智能·数据中心·机房管理·模块化机房
大大大大晴天2 小时前
别让金额越算越多:事实表与维度表设计避坑指南
大数据
如夏倾城3 小时前
入侵检测系统(IDS)原理、部署模式与 IPS/防火墙对比
大数据·网络·人工智能·网络安全·云原生·架构·kubernetes
wuyk5553 小时前
Spider-第20讲-综合实战可上线爬虫
大数据·爬虫·python·elasticsearch
培培说证4 小时前
大数据与会计专业性价比高的证书有哪些?
大数据
FungLeo4 小时前
FengCMS · PHP+MySQL 升级实录·模型导入从“加密 SQL 码“到.fengmodel.json
sql·mysql·php·工程实践·fengcms
正在走向自律4 小时前
MySQL兼容性深度实践:建表、增删改查与迁移避坑全记录
数据库·sql·mysql·信创·数据库迁移
Decay__5 小时前
PostgreSQL 体系架构全解 —— 进程模型、共享内存、MVCC 与 WAL 预写日志深入
运维·数据库·sql·mysql·架构
伞伞悦读6 小时前
【第90期】KNN分类回归流水线与K值对照的实验与排查
大数据·人工智能·python·深度学习·机器学习