Scrapy是一个目前还比较流行的开源爬虫框架。
专门用于提供爬虫学习的网站如:http://books.toscrape.com、https://www.zhihu.com/hot、https://movie.douban.com/top250等。
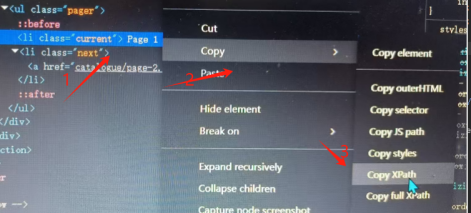
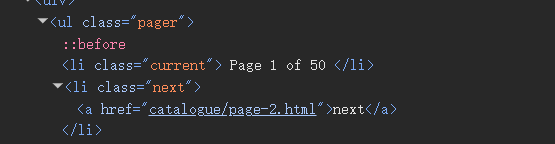
在使用parse来对网页内容进行爬时,使用的是CSS选择器或XPath来提取页面中的数据内容。以以下图片中的内容为例。XPath的使用用法:提取信息的命名=爬虫名称.XPath("输入复制的XPath").提取第几个内容
CSS选择器的使用方法:提取信息的命名=爬虫名称.css("ul.pager li.next a::attr(herf)").提取第几个内容
对获取的下一个网页的URL,使用yield和request的组合方式将请求都由yield语句交给Scrapy引擎,例子:yield scrapy.Request(next_url,cllback=self.parse)
知识扩展:yield与return的区别:都是返回一个值,return返回一个值后,yield返回的是一个对象。代码段执行结束;yield在返回值以后会交出CPU的使用权,代码段并没有直接结束,而是在此处中断,当调用send()或next()方法后,yield可以从之前中断的地方继续执行后续新增的代码段。
爬虫注意事项:①爬虫的时候在爬取网页的URL的时候记得对URL进行去重,这很关键;在进行网页搜索中的搜索策略可以选择深度搜索或者广度搜索两种策略;以及还要考虑爬虫的边界限定的问题。
②Scrapy的安装很简单:直接就是pip install scrapy,然后查看下载的版本:scrapy.version_info
③爬虫的起始点可以设定多个,但是需要预先对每个不同的爬虫进行不同的命名,是的爬虫的效率增加
④爬虫的流程:创建并命名爬虫名称-》对爬取的网页的URL进行设定-》parse方法的使用来提取页面总的内容
爬虫学习——Scrapy
爱吃泡芙的小白白2025-04-21 17:10
相关推荐
实名上网宋凯宣3 小时前
Django如若1234 小时前
【论文复现】CoFailMed:从零复现医学图像分割的共享失败审计,含完整代码流程与科研绘图砚底藏山河6 小时前
python量化自定义周期 K 线合成视觉小萌新6 小时前
AI Class 3 · Chapter 1:变量、字符串、list/dict、if/for(python学习-小白版-有经验可跳过)薛定谔的猫-菜鸟程序员7 小时前
软件架构设计师开发资料大全(从入门到精通)Ramble_Naylor8 小时前
Rust深度解读:Send 与 Sync 的本质与线程安全边界Allen_LVyingbo9 小时前
NVIDIA CUDA Tile 在医疗计算中的算子形式化、算法重构与内核实现云和数据.ChenGuang9 小时前
Python 闭包详解:从原理到实战我命由我1234511 小时前
Python 实用操作 - 文件操作(打开与关闭文件、读取文件、文件写入)青少儿编程课堂11 小时前
蓝桥杯·全国青少年信息素养大赛·电子学会Python/C++考级:倍增法求最近公共祖先LCA解析