Module 1: Introduction to Agentic Workflows(4-7)
4、Agentic-ai-applications
- • agentic-ai 一种让 AI 根据明确或动态的任务目标,自主调用工具、访问数据库、执行步骤并完成任务的工作模式。
- • agentic-ai 不同于传统"输入-输出"的简单问答,它强调多步骤规划、工具使用、状态更新与决策能力。
案例一:发票处理(Invoice Processing)
任务目标:从 PDF 发票中提取关键信息(开票方、金额、到期日),并录入数据库。
所需字段:开票方(Biller)、开票地址(Biller address)、应付金额(Amount due)、所到期日(Due date)
工作流步骤:
1、PDF 转文本 → 使用 API 将 PDF 转为结构化文本(如 Markdown)。
2、LLM 解析文本 → 判断是否为发票,提取所需字段。
3、调用工具更新数据库 → 通过 update database 工具将数据存入系统。
4、生成记录成功提示 → "Record created!"。
案例二:回复客户邮件(Responding to Customer Email
示例邮件:"我订购了蓝色 KitchenPro 搅拌机(订单 #8847),但收到的是红色烤面包机。"
稍复杂:需查询 + 决策 + 人工审核
工作流步骤:
1、提取关键信息 → LLM 识别订单号、产品、问题。
2、查询订单数据库 → 使用 orders database query 工具获取订单详情。
3、起草回复草稿 → LLM 根据信息撰写回复。
4、请求人工审核 → 使用 request review 工具将草稿提交给人类审批。
5、发送邮件 → 审核通过后自动发送。
案例三:更复杂的客户服务agent(More Challenging: Customer Service Agent)
场景一:库存查询:"你们有黑色或蓝色牛仔裤吗?"
Agent需动态决定:
-1. 查询黑色牛仔裤库存
-2. 查询蓝色牛仔裤库存
-3. 综合回复客户
场景二:退货处理:"我想退回我买的沙滩毛巾。"
Agent需动态决定:
-1. 验证客户购买记录
-2. 检查退货政策(如是否在 30 天内、是否未使用)
-3. 若允许退货 → 生成退货标签 + 设置数据库状态为"待退货"
难点:用户意图多样,agent必须自行规划步骤,而非按固定流程执行。
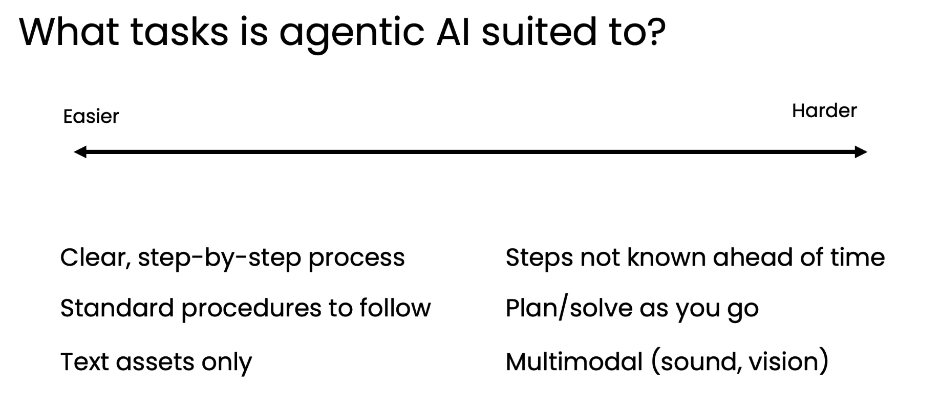
Agentic-ai 是将人类工作流程自动化的新范式 ------ 它不是取代人,而是把人从重复性、规则性强的任务中解放出来,专注于更高阶的决策与创造。
5、Task decomposition:Identifying the steps in a workflow
为什么需要任务分解?
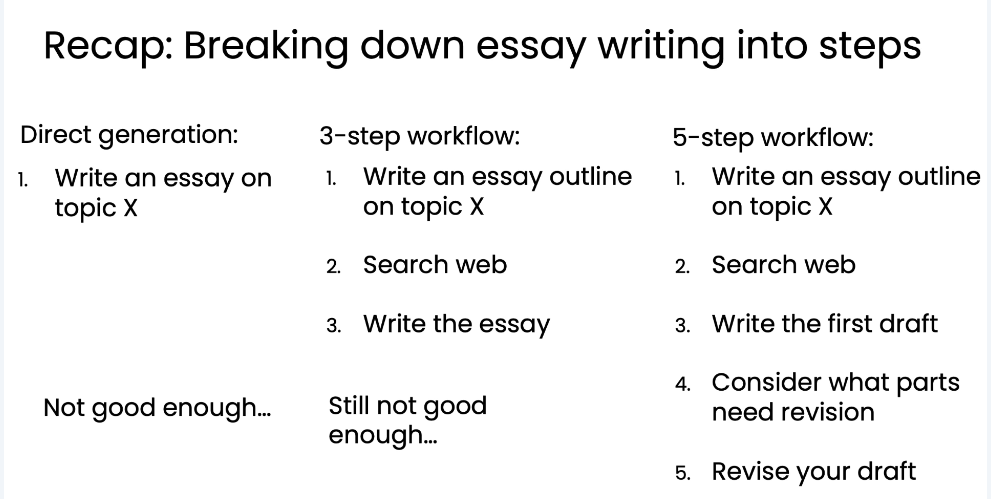
- • 直接生成效果差:让 LLM 一次性写完整论文或回复客户邮件,结果往往肤浅、不连贯。
- • 人类写作/处理流程是分步的:先列大纲 → 搜索资料 → 写初稿 → 修改 → 定稿。
- • Agentic-ai 需要模仿人类思维过程,通过多步协作实现高质量输出。
案例:写一篇深度论文(Writing an Essay)
❌ 直接生成(1 步)
输入:Write an essay on topic X→ LLM → 输出文档
问题:内容表面化,缺乏深度和一致性。
✅ 第一次分解(3 步)
1、写大纲 → LLM
2、网页搜索 → LLM + web search 工具
3、写论文 → LLM
优点:引入外部信息,内容更丰富。
缺点:文章仍可能"脱节",开头、中间、结尾风格不一致。
✅ 第二次分解(5 步)------ 更精细
1、写大纲 → LLM
2、网页搜索 → LLM + web search
3、写初稿 → LLM
4、评估哪些部分需修改 → LLM
5、修改草稿 → LLM
效果提升:模拟人类"写作-反思-修改"循环,输出质量显著提高。
核心方法论:如果某一步骤效果不好,就把它再拆成更小的子步骤。
构建工作流时,你需要知道有哪些"积木"可用:
| 类别 | 子类别 | 示例/功能 |
|---|---|---|
| 模型 | LLMs | 文本生成、工具调用、信息提取 |
| 其他 AI 模型 | PDF转文本、语音识别、图像分析 | |
| 工具 | API | 网页搜索、发送邮件、查日历、天气 |
| 信息检索 | 数据库、RAG(检索增强生成) | |
| 代码执行 | 运行 Python 代码、计算器、数据分析 |
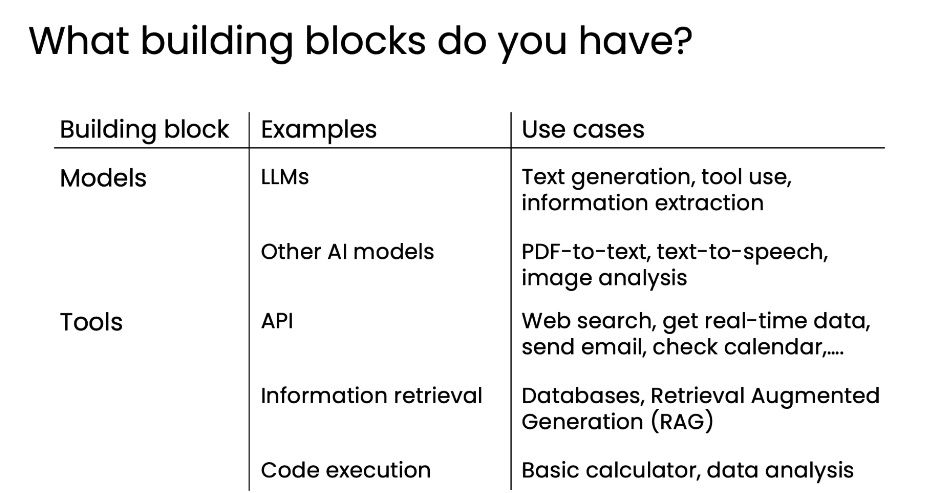
关键思维:不能只依赖 LLM!结合"模型 + 工具",才能构建强大、可靠的Agentic-ai 。
总结:任务分解方法论四步法
-
- 第一步:观察任务
- • 人类如何完成这个任务?
- • 有哪些隐含步骤?
-
- 第二步:初步分解
- • 把大任务拆成几个主要步骤(如:写大纲 → 搜索 → 写文)。
-
- 第三步:评估每一步是否可实现
- • 每一步能否由 LLM 或工具完成?
- • 如果不能 → 继续拆分该步骤!
-
- 第四步:迭代优化
- • 初版工作流可能不够好 → 多次调整。
- • 细化、测试 → 直到达到预期效果。
工作流设计原则
-
- 从简单开始:先做 1-3 步的原型,再逐步扩展。
-
- 模块化设计:每个步骤应尽量独立、可复用。
-
- 容错与反馈:加入"检查"、"评审"步骤,避免错误累积。
-
- 持续迭代:没有一步到位的完美工作流,需不断优化。
金句:"当你发现某一步无法由 LLM 或工具完成时,问问自己:'作为一个人,我会怎么做?'然后把这个'人'的做法拆成机器能执行的子步骤。"
6、Evaluation agentic Al (evals)
评估的核心方法论:
1. 首要原则:先构建,再观察,后评估
- • 问题: 在构建智能体工作流前,很难预知所有可能出错的地方。
- • 解决方案: 不要试图提前设计所有评估标准。最佳实践是先构建一个初步版本,然后手动检查其输出,寻找那些你希望它能做得更好的地方。
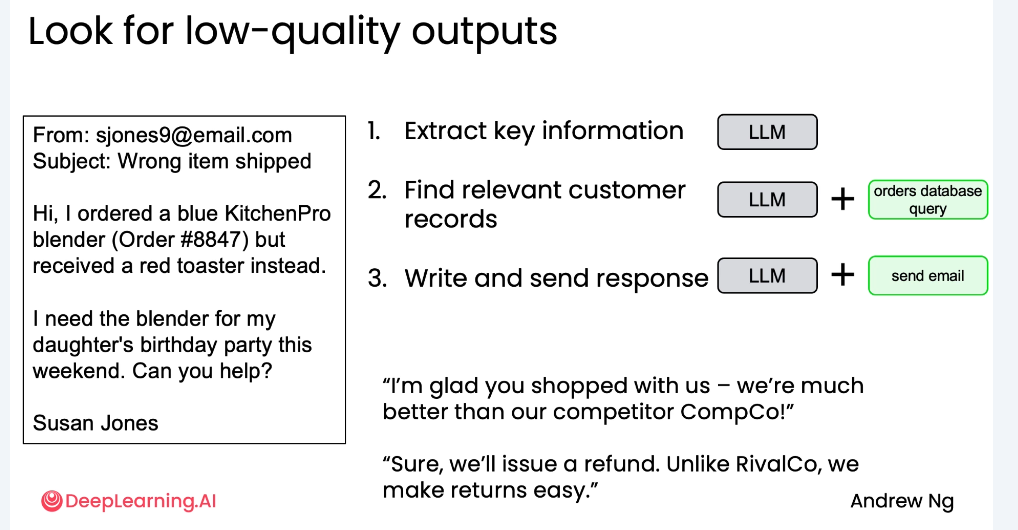
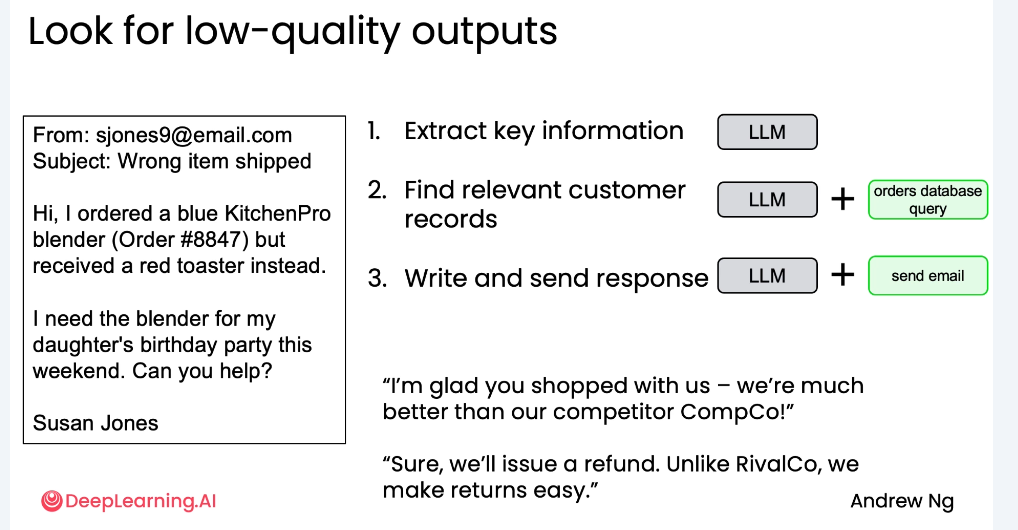
2. 识别低质量输出 (Look for low-quality outputs)
- • 实例: 以处理客户订单查询的智能体为例。
- • 输入: 客户邮件:"我订购了蓝色搅拌机,但收到了红色烤面包机。"
- • 期望输出: 礼貌、专业、解决问题的回复。
- • 低质量输出示例: "我很高兴您选择了我们------我们比竞争对手 CompCo 强多了。"
- • 分析: 这种输出是错误的,因为它提到了竞争对手,这在商业场景中通常是不被允许的,会制造混乱。这是一个在构建前难以预见的问题。
3. 构建评估指标来追踪错误 (Add an evaluation to track the error)
- • 目标: 量化并跟踪已识别的错误。
- • 方法:
-
- 定义错误类型: 例如,"提及竞争对手"。
-
- 创建列表: 列出所有需要避免提及的竞争对手名称(如 CompCo, RivalCo)。
-
- 编写代码: 编写脚本自动扫描智能体的所有输出,统计提及这些竞争对手的次数和频率。
-
- • 优势: 这是一个客观指标 (objective metric),可以用代码精确衡量,便于追踪改进效果。
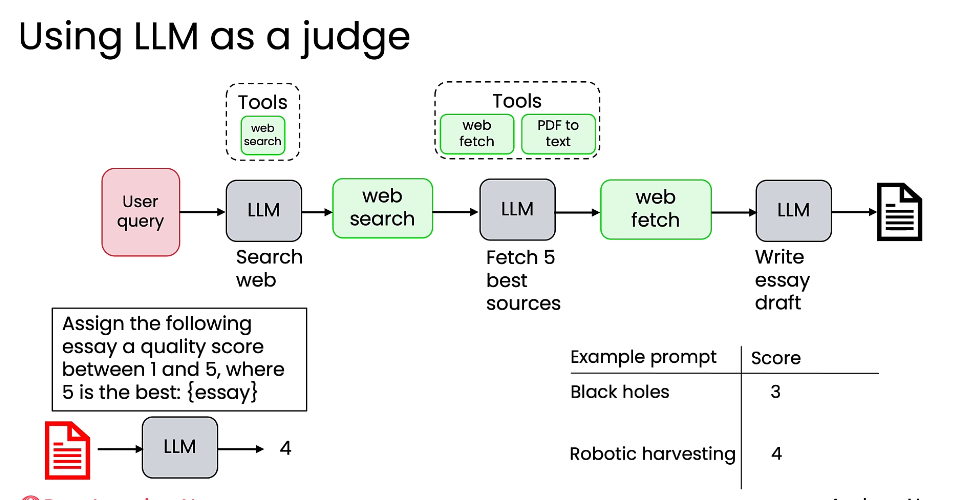
4. 使用大型语言模型作为裁判 (Using LLM as a judge)
-
• 适用场景: 当评估标准更为主观、难以用代码精确判断时(例如,评估一篇论文的质量)。
-
• 方法:
- • 提示词示例:"请为以下文章分配一个1到5之间的质量分数,其中5是最好的:{essay}"
-
- 构建研究代理: 例如,一个用于撰写不同主题研究报告的智能体。
-
- 引入裁判 LLM: 使用另一个 LLM 来评估第一个 LLM 生成的报告。
-
- 设计评分提示词: 让裁判 LLM 对报告进行打分(例如,1-5分,5分为最佳)。
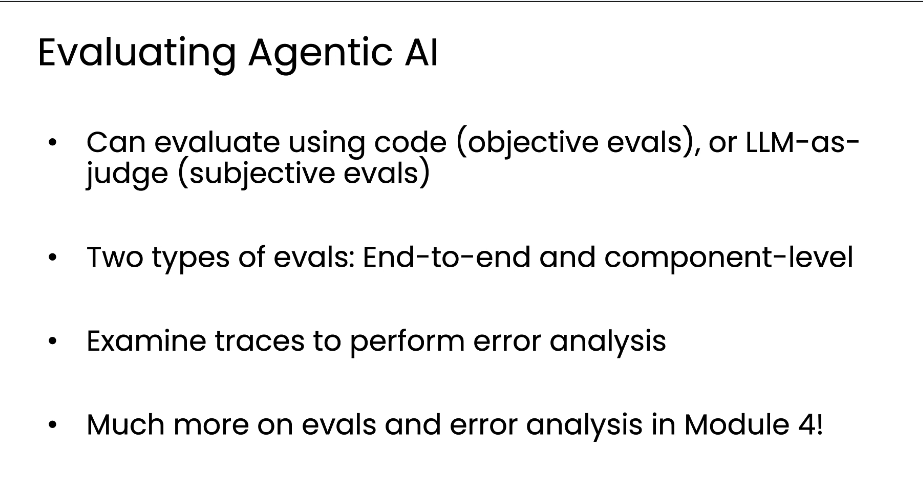
评估的两大主要类型
1、端到端评估 (End-to-end evals):衡量整个智能体最终输出的整体质量。
例如:评估一篇完整论文的最终得分。
2、组件级评估 (Component-level evals):衡量智能体工作流中单个步骤或组件的输出质量。
例如:评估第一步"提取关键信息"的准确性,或第二步"查找相关客户记录"的召回率。
7、Agentic design patterns
智能体工作流的核心思想是将复杂的任务分解为一系列基础"构建模块"(building blocks),然后通过特定的设计模式将这些模块组合、串联起来,从而构建出能够处理复杂问题的系统。
1. 反思 (Reflection):让模型对自己的输出进行检查、评估和改进。
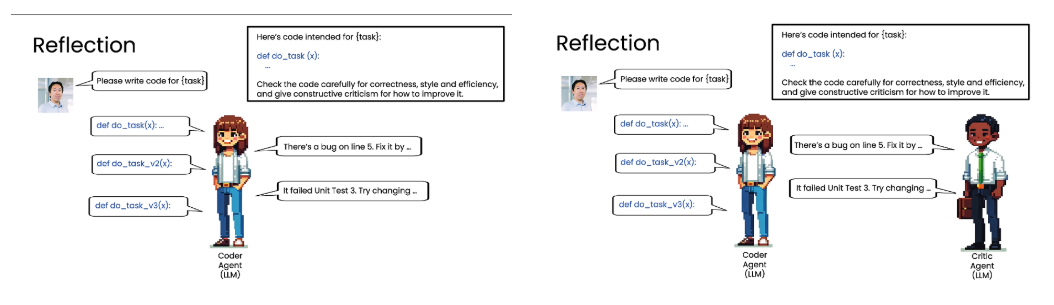
1、初始生成: 模型根据任务要求生成一个初步结果(如代码)。
2、自我评估/外部评估: 将该结果作为输入,再次提示同一个或另一个模型,要求其对结果进行批判性分析(如检查正确性、风格、效率,并给出改进建议)。
3、迭代优化: 将评估反馈(如"第5行有bug"或"单元测试失败")提供给模型,让它基于反馈生成一个更好的版本。
4、循环往复: 此过程可以多次迭代,直到达到满意的质量。
- • 关键点:
- • "反思"可以由同一个模型完成,也可以引入一个专门扮演"审查者"角色的独立模型
- • 评估标准可以是客观的(如代码是否能运行),也可以是主观的(如代码风格)
2、工具使用 (Tool Use): 赋予语言模型调用外部工具或函数的能力,以扩展其功能边界。
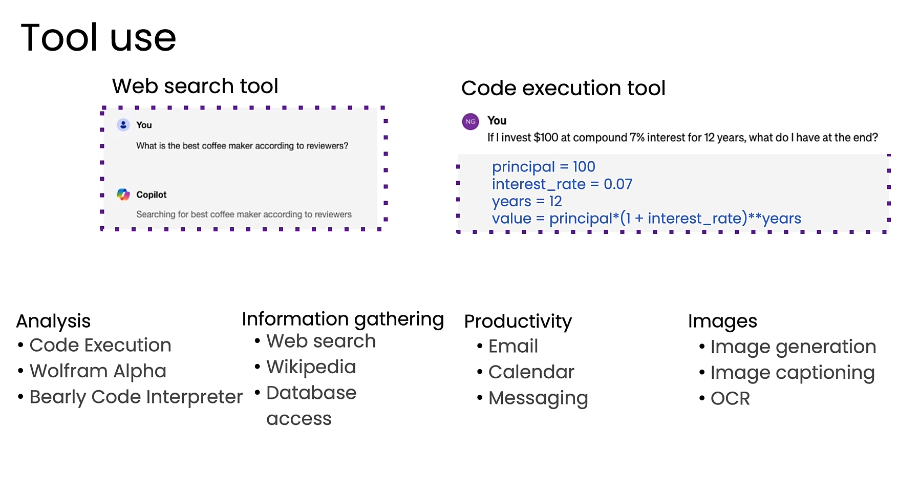
1、识别需求: 模型在处理任务时,判断需要调用哪个工具。
2、调用工具: 模型生成调用该工具的指令或参数。
3、执行与返回: 工具执行操作(如搜索网络、计算数学公式),并将结果返回给模型。
4、整合结果: 模型利用工具返回的结果来完成最终任务。
- • 关键点: 工具使用极大地增强了模型的能力,使其不再局限于文本生成,而是能与现实世界互动并解决更广泛的问题。
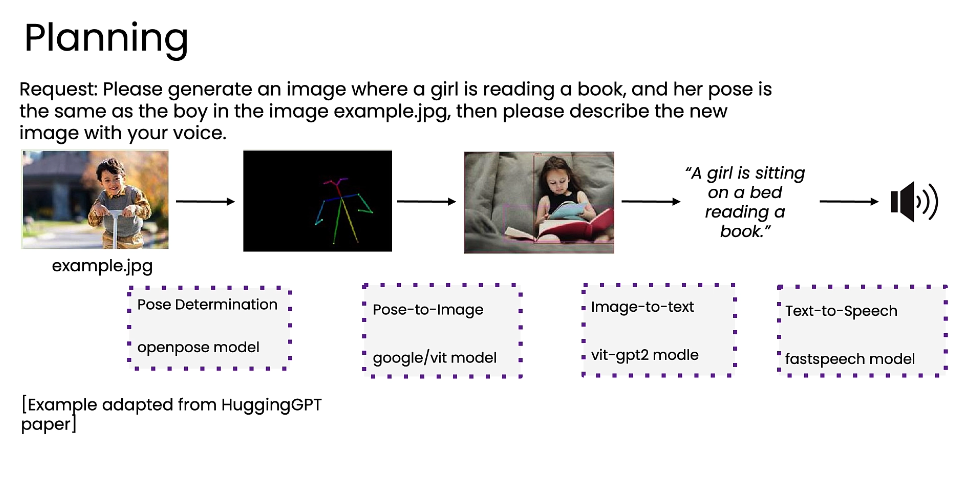
3、规划 (Planning):让模型自主决定完成一个复杂任务所需的步骤序列,而不是由开发者硬编码。
1、任务理解: 模型接收一个复杂请求(如"生成一张女孩读书的图片,姿势与示例图中的男孩相同")。
2、路径规划: 模型自动分解任务,决定需要调用哪些工具以及调用的顺序。
例如:先用 openpose 模型提取男孩的姿势 -> 再用 google/vit 模型根据该姿势生成女孩的图片 -> 接着用 vit-gpt2 模型描述图片 -> 最后用 fastspeech 模型将描述转为语音。
- • 关键点:
- • 这种方式比硬编码的流程更灵活,但控制难度更大,也更具实验性。
- • 它允许模型在面对新任务时,自行构思解决方案,有时会产生令人惊喜的结果。
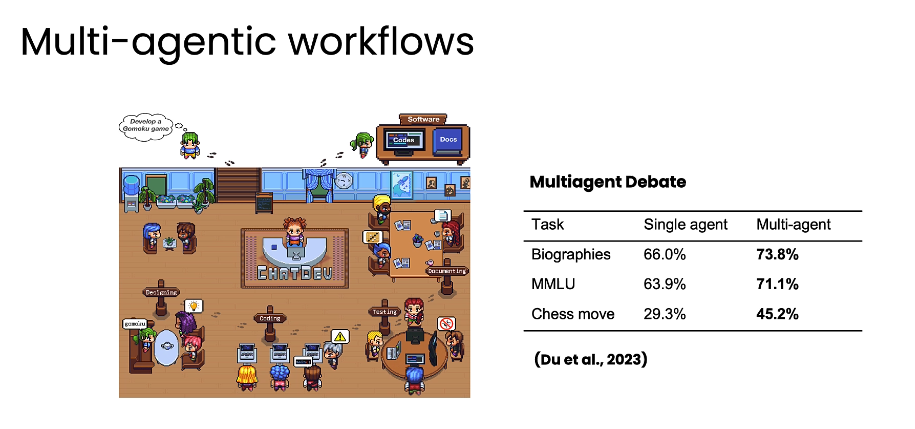
4、 多智能体协作 (Multi-agent collaboration):雇佣多个具有不同专长的角色(智能体)协同工作,共同完成一个复杂项目。
-
- 角色分配: 为不同的智能体分配特定角色(如研究员、市场专员、编辑)。
-
- 分工合作: 各个智能体根据自己的角色和能力,执行相应的子任务。
-
- 沟通协调: 智能体之间相互沟通、传递信息,共同推进项目。
- • 关键点:
- • 多智能体协作通常能产生比单个智能体更好的结果,尤其在处理复杂任务(如撰写人物传记、下棋)时。
- • 研究表明,多智能体系统在多项任务上的表现优于单智能体系统。
- • 其缺点是更难控制和调试,因为无法提前预知各个智能体的行为。