技术栈
spark与hadoop的区别
461K.
2025-04-22 20:07
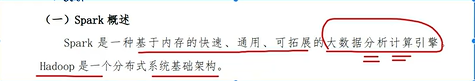
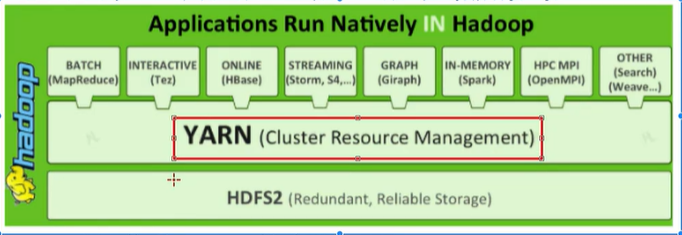
一.概述
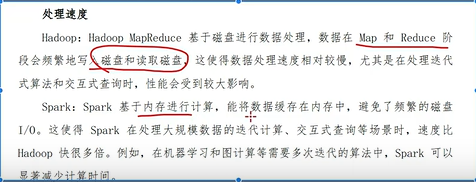
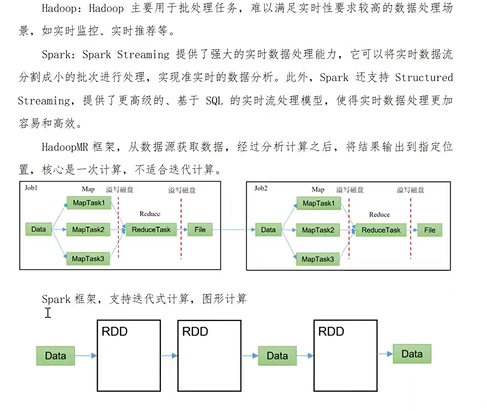
二.处理速度
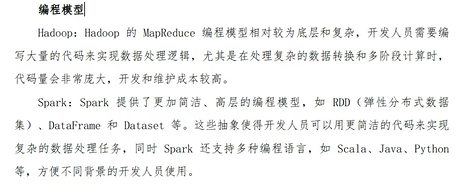
三.编程模型
四:实时性处理
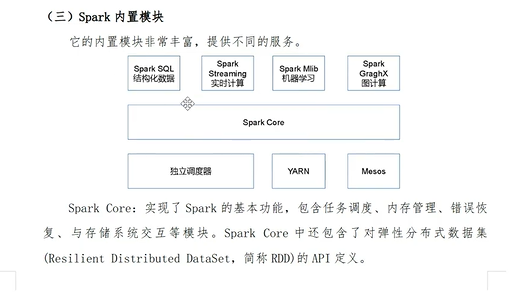
五.spark内置模块
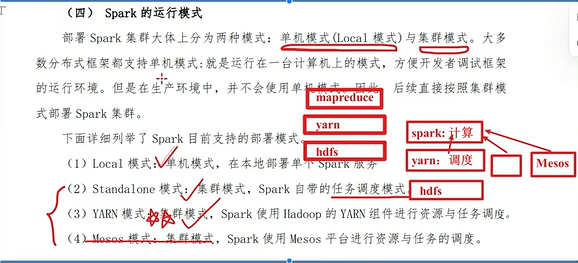
六.spark的运行模式
大数据
运维
hadoop
分布式
spark
intellij-idea
上一篇:
STM32CubeMX-H7-15-SPI通信协议读写W25Q64
下一篇:
Linux——系统安全及应用
相关推荐
小羊没烦恼!
5 小时前
Memory 记忆设计讨论:Agent Memory 的安全边界:权限、删除、版本与回执
java
·
大数据
·
word
·
powerpoint
·
.net
刃神太酷啦
5 小时前
Redis 核心进阶:哨兵、集群、缓存问题与分布式锁详解----《Hello Redis!》(6)
linux
·
c语言
·
数据库
·
c++
·
redis
·
分布式
·
缓存
colourmind
5 小时前
K3S+Hami+Higress+Vip(nginx+keepalived)搭建云原生高可用的大模型部署平台
运维
·
nginx
·
云原生
喻师傅
5 小时前
Apache Hudi 概述:从 Parquet 更新难题到数据湖 Upsert
大数据
·
数据仓库
·
big data
团子股股东峥哥
5 小时前
day38-RHEL-管理存储堆栈
linux
·
运维
·
服务器
qq2953
6 小时前
自然语言投研 Agent 的工程化选型:从问财式 NL2SQL 到多智能体投研社区
大数据
·
人工智能
一隅论数智
6 小时前
数据消费主体变了:智能时代如何重构业务管理逻辑
大数据
·
人工智能
·
经验分享
·
笔记
·
学习
·
行业数字化
工业HMI实战笔记
6 小时前
【拯救HMI】:自动化对外输出新范式:从设备出口到 “技术 + 服务” 全链条交付
运维
·
自动化
时下握今
6 小时前
战略数据分析完整流程:从桌面研究、调研取证到报告落地
大数据
·
人工智能
用户361058862612
6 小时前
Flink高级之富函数类深度剖析:执行时序、状态注册与序列化陷阱
大数据
·
flink
热门推荐
01
国内可直接用、免费额度/永久免费的大模型API清单(含 SiliconFlow、火山、阿里、智谱、百度、Kimi、DeepSeek、DMXAPI 等)
02
历年考研数学一、数学二、数学三真题试卷及答案PDF
03
微信历史版本含下载地址( Windows PC | 安卓 | MAC )及设置微信不更新
04
蜘蛛磁力 搜索引擎大全,如何使用蜘蛛磁力查找磁力链接
05
GitHub 镜像站点
06
2026 国产 AI 大模型横评:DeepSeek、通义千问、Kimi、文心一言、星火、豆包谁更能打?
07
人工智能(AI)发展史:详细里程碑
08
【一等奖版】2026 国赛 A题 药材的烘干问题
09
ZCode 周末送额度活动开启:3 亿 Token 免费领取
10
Agnes AI 免费 API 接入指南:文本、生图、生视频,一套接口全免费