这篇论文主要提出并验证了一种用于风电功率预测的新型混合深度学习模型 ,其核心是基于并行结构的 TCN-LSTM 模型结合 Savitzky-Golay (SG) 滤波器。
1 Liu S, Xu T, Du X, et al. A hybrid deep learning model based on parallel architecture TCN-LSTM with savitzky-golay filter for wind power predictionJ. Energy Conversion and Management, 2024, 302: 118122.
Shujun Liu a , ∗ {}^{a,*} a,∗, Tong Xu a {}^a a, Xiaoze Du a , b , ∗ {}^{a,b,*} a,b,∗, Yaocong Zhang b {}^b b, Jiangbo Wu a {}^a a
a {}^a a School of Energy and Power Engineering, Lanzhou University of Technology, Lanzhou 730050, China
b {}^b b School of Energy Power and Mechanical Engineering, North China Electric Power University, Beijing 102206, China
Corresponding authors: Shujun Liu, Xiaoze Du
论文内容可以概括为以下几个要点:
🌟 1. 模型创新点
- 结构创新 :将 TCN(时序卷积网络)和 LSTM(长短期记忆网络)以并行架构 组合,通过张量拼接(tensor concatenation)模块融合各自提取的特征,提高时间序列建模能力。
- SG滤波器引入:在模型训练阶段,使用 SG 滤波器对风速序列进行平滑降噪,提升了输入数据质量,降低了模型学习难度。
🧪 2. 实验设计
论文设计了三组实验来验证模型效果:
实验 I:验证 SG 滤波对模型性能的提升。
- SG 滤波能显著提高 TCN、LSTM、CNN-LSTM、PA-TCN-LSTM 的预测精度和 R² 值。
实验 II:进行超参数优化。
- 采用三步优化策略:①调整 TCN 滤波器数量和 LSTM 单元数量;②选择最佳 TCN 滤波器尺寸;③选择最优激活函数、优化器、批大小。
- 最优配置为:TCN 滤波器数 = 64,LSTM 单元数 = 64,滤波器大小 = 3,激活函数为 Tanh,优化器为 Adam,batch size 为 32。
实验 III:与多种单模型与传统混合模型对比。
- 对比对象包括:KNN、SVR、XGBoost、随机森林、MLP、RNN、LSTM、CNN、TCN、CNN-LSTM、传统 TCN-LSTM。
- 在所有评估指标(nMAE、nMSE、nRMSE、R²)上,PA-TCN-LSTM 性能最佳。
📊 3. 模型性能亮点
- 相较单模型(如 KNN、SVR、XGBoost),PA-TCN-LSTM 最大可将 nMAE 降低 58.26%,nMSE 降低 80.71%,nRMSE 降低 56.10%,R² 提高 3.50%。
- 相较 CNN-LSTM:nMAE 降低 22.70%,nMSE 降低 26.37%,nRMSE 降低 14.09%。
- 相较 TCN-LSTM:在性能略有提升的同时,参数量减少 6.59%,计算时间降低 25.82%。
✅ 4. 统计验证
- 使用 Diebold-Mariano (DM) 检验进一步验证预测性能差异的统计显著性。
- DM 检验结果显示,所有对比中 PA-TCN-LSTM 的表现都显著优于其他模型(统计量均为负值,P 值均 < 0.05)。
🔚 5. 结论与未来展望
- PA-TCN-LSTM 在预测精度、效率和计算复杂度方面表现优越。
- 当前数据集特征维度较少(仅风速、风向、功率),未来将考虑引入更多特征、更大数据集,进一步挖掘模型的特征提取能力。
- 并行结构具备良好扩展性,未来可接入更多深度学习模型进行融合。
### 文章目录
- [🌟 1. **模型创新点**](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [🧪 2. **实验设计**](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [**实验 I**:验证 SG 滤波对模型性能的提升。](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [**实验 II**:进行超参数优化。](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [**实验 III**:与多种单模型与传统混合模型对比。](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [📊 3. **模型性能亮点**](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [✅ 4. **统计验证**](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [🔚 5. **结论与未来展望**](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [@toc](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [**摘要**](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [1. 引言](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [2. 方法](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [2.1 并行架构的混合深度学习模型](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [2.2 时序卷积网络(Temporal Convolutional Network, TCN)](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [2.3 长短期记忆神经网络(LSTM)](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [2.4 张量拼接模块(Tensor Concatenate Module)](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [3. 案例研究](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [3.1 数据说明](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [3.2 数据预处理](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [3.2.1 SG 滤波去噪](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [3.2.2 数据划分与归一化](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [3.3 评估指标](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [3.4 实验结果与分析](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [3.4.1 实验 I](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [3.4.2 实验二](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [3.4.3 实验三](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
- [4. 结论](#文章目录 🌟 1. 模型创新点 🧪 2. 实验设计 实验 I:验证 SG 滤波对模型性能的提升。 实验 II:进行超参数优化。 实验 III:与多种单模型与传统混合模型对比。 📊 3. 模型性能亮点 ✅ 4. 统计验证 🔚 5. 结论与未来展望 @[toc] 摘要 1. 引言 2. 方法 2.1 并行架构的混合深度学习模型 2.2 时序卷积网络(Temporal Convolutional Network, TCN) 2.3 长短期记忆神经网络(LSTM) 2.4 张量拼接模块(Tensor Concatenate Module) 3. 案例研究 3.1 数据说明 3.2 数据预处理 3.2.1 SG 滤波去噪 3.2.2 数据划分与归一化 3.3 评估指标 3.4 实验结果与分析 3.4.1 实验 I 3.4.2 实验二 3.4.3 实验三 4. 结论)
全文翻译
摘要
风能正经历着全球范围的快速增长。然而,风电生成的时间序列数据通常具有非线性和非平稳性特征,给精确预测带来了巨大挑战。因此,风电预测在电力和能源系统的规划与部署中扮演着越来越关键的角色。近年来,为提高风电预测性能,研究人员提出了多种混合深度学习预测模型,但这些模型较深的网络层级和复杂的结构也带来了更高的计算成本和较低的预测效率。
为实现更高的预测性能、降低混合深度学习模型的复杂度和计算成本、提高预测效率,本研究提出了一种基于并行架构的混合深度学习模型。该模型通过张量拼接模块将时序卷积网络(TCN)与长短期记忆神经网络(LSTM)结合用于风电预测,并在模型训练阶段引入 Savitzky-Golay(SG)滤波器以去除噪声、平滑输入的风速时间序列。
本文以土耳其某风电机组为案例,开展了三组对比实验。通过与多种单一及混合模型的对比,并结合当前主流评估指标及 Diebold-Mariano 检验,验证了所提模型的有效性与优越性。结果表明,在相同超参数设置下,所提并行架构 TCN-LSTM 混合模型的训练参数数量和计算时间分别减少了 6.59% 和 25.82%;归一化平均绝对误差(nMAE)、归一化均方误差(nMSE)与归一化均方根误差(nRMSE)分别降低了 2.00%、9.21% 和 4.74%。Diebold-Mariano 检验结果亦表明,所提出模型在预测性能方面表现更佳。此外,本研究提出的创新性架构为构建风电预测的混合深度学习网络提供了一种新的思路。
关键词:风能;时序卷积网络(TCN);长短期记忆神经网络(LSTM);风电预测;Savitzky-Golay 滤波器
1. 引言
化石燃料排放碳排放物,加剧了气候变化和生态环境的恶化,而这些正是人类生存所依赖的基础 1。发展可再生能源在实现基于化石燃料的能源系统脱碳方面发挥着重要作用 2。中国已提出在2030年实现"碳达峰",并在2060年实现"碳中和"的目标,这意味着国家能源结构将发生重大转型,并将更加广泛地采用可再生能源 3。风能是一种无污染的可再生能源,作为发电能源的利用已引起广泛关注 4。
根据全球风能理事会发布的《2023全球风能报告》5,2022年全球新增风电装机容量达77.6吉瓦,全球累计装机容量达到906吉瓦,同比增长9%。预计未来五年,风电年均新增装机容量将达到136吉瓦,实现15%的两位数年增长率。然而,风电发电具有随机性和不确定性,这对电网管理的灵活性与鲁棒性提出了巨大挑战 6。一个可行的解决方案就是开展风电预测。
目前,风电预测方法层出不穷。根据方法原理和技术路径的不同,风电预测方法大致可以分为物理模型、统计模型、机器学习模型和混合模型。物理模型主要利用数值天气预报(NWP)和计算流体动力学来模拟风场,通过获取气象数据(如风速、风向、气压、空气密度、温度和湿度等)和环境风场信息(如地形、等高线、障碍物等),结合风功率曲线预测风电机组输出 7。此类方法能够在缺乏历史数据的情况下弥补信息空缺 8。
统计模型和机器学习模型都属于数据驱动的方法 9。统计模型通过分析历史运行数据 10,提取季节性和周期性规律,并根据预测值与实际值之间的差异动态调整模型参数。该方法更适用于揭示数据之间的线性关系,如自回归滑动平均模型(ARMA)11和自回归积分滑动平均模型(ARIMA)12。而机器学习方法已被证明在非线性和非规则特征提取方面表现优异 13,因而越来越多地用于解决上述方法在学习复杂观测数据中的非线性关系方面的不足。例如,基于距离的K近邻算法(KNN)14、支持向量回归(SVR)15以及决策树模型如随机森林(RF)16和极端梯度提升(XGBoost)17已广泛用于风电时间序列预测。
近年来,先进的深度学习网络被逐步引入预测模型中,用于增强对历史时间序列数据的特征提取,从而进一步提升传统模型的预测精度。作为一种深度学习网络,循环神经网络(RNN)因其建模时间依赖关系的能力,已被广泛应用于序列数据的分类与回归任务,如音乐生成、语音识别等 18,并在能源和电力负荷预测中得到应用 19。然而,RNN在训练过程中存在梯度消失问题,难以建模长期依赖性,限制了其进一步应用。因此,提出了长短期记忆神经网络(LSTM)这一RNN变体,通过引入多个门控机制以解决长期依赖问题 20。《文献》21提出了一种基于遗传算法优化的LSTM风电预测方法,《文献》22则提出了结合多任务学习的LSTM预测模型,两者均验证了LSTM网络方法优于传统方法的预测性能。
卷积神经网络(CNN)也是一种常见的深度学习结构,其通过多次卷积操作能够有效提取复杂时间序列中的特征,实现高精度预测 23,并识别时间序列中的局部特征关联 24。此外,CNN具有局部连接和参数共享的特点,可显著缩短模型训练时间,提升预测效率 25。因此,CNN也常用于捕捉时间序列之间的相关性,以实现精准高效的预测 26。在此基础上,时序卷积网络(TCN)被提出用于研究和预测时间序列中的特征关系 27。TCN主要由因果卷积和空洞卷积组成,因果卷积在时间步 t t t 的输出仅依赖于 t t t 之前的输入,不涉及未来输入,从而适用于多时间序列间关系建模 28。空洞卷积通过扩大卷积核感受野,使输出包含更丰富的输入特征。此外,TCN支持并行处理,提升了特征学习和预测的效率 29。
尽管上述单一深度学习模型在风电预测中表现良好,但面对日益复杂和庞大的风电数据,这些方法已难以满足实际需求。因此,有必要探索更高效且精度更高的预测方案。一种常见策略是引入信号处理方法,如变分模态分解(VMD)30--31、经验模态分解(EMD)32--33、奇异值分解(SVD)34 和 Savitzky-Golay(SG)滤波器 35,对与风电相关的关键特征数据进行分解或平滑处理。处理后的数据噪声降低,波动规律更明显,从而提升模型对关键特征的提取能力,提高预测精度。
另一种策略是结合多种单一深度学习方法,构建多样的混合模型 36--37,以充分发挥各方法的优势,进一步提升预测精度与效率。例如,文献 38 提出了CNN-LSTM混合模型,利用CNN提取气象特征的时空相关向量并重构时间序列,再通过LSTM进行多步预测。结果显示,该混合模型在预测精度方面优于单一CNN或LSTM模型。文献 39 构建了融合Time2Vec时间嵌入层、CNN、双向LSTM(BiLSTM)和注意力机制的混合模型,测试结果表明其预测效果优于多种单一与混合模型。
总的来说,随着深度学习网络结构的不断深化以及更复杂算法的叠加,混合模型的预测能力不断提升。但现有方法仍存在问题:网络复杂度增加导致计算内存和时间需求上升,训练成本显著增加,影响预测的实时性。尤其在混合模型中,为了提升预测精度而引入更多功能层与结构,往往忽视了模型参数规模的急剧增加,从而带来计算资源消耗过大和训练时效性下降的问题。
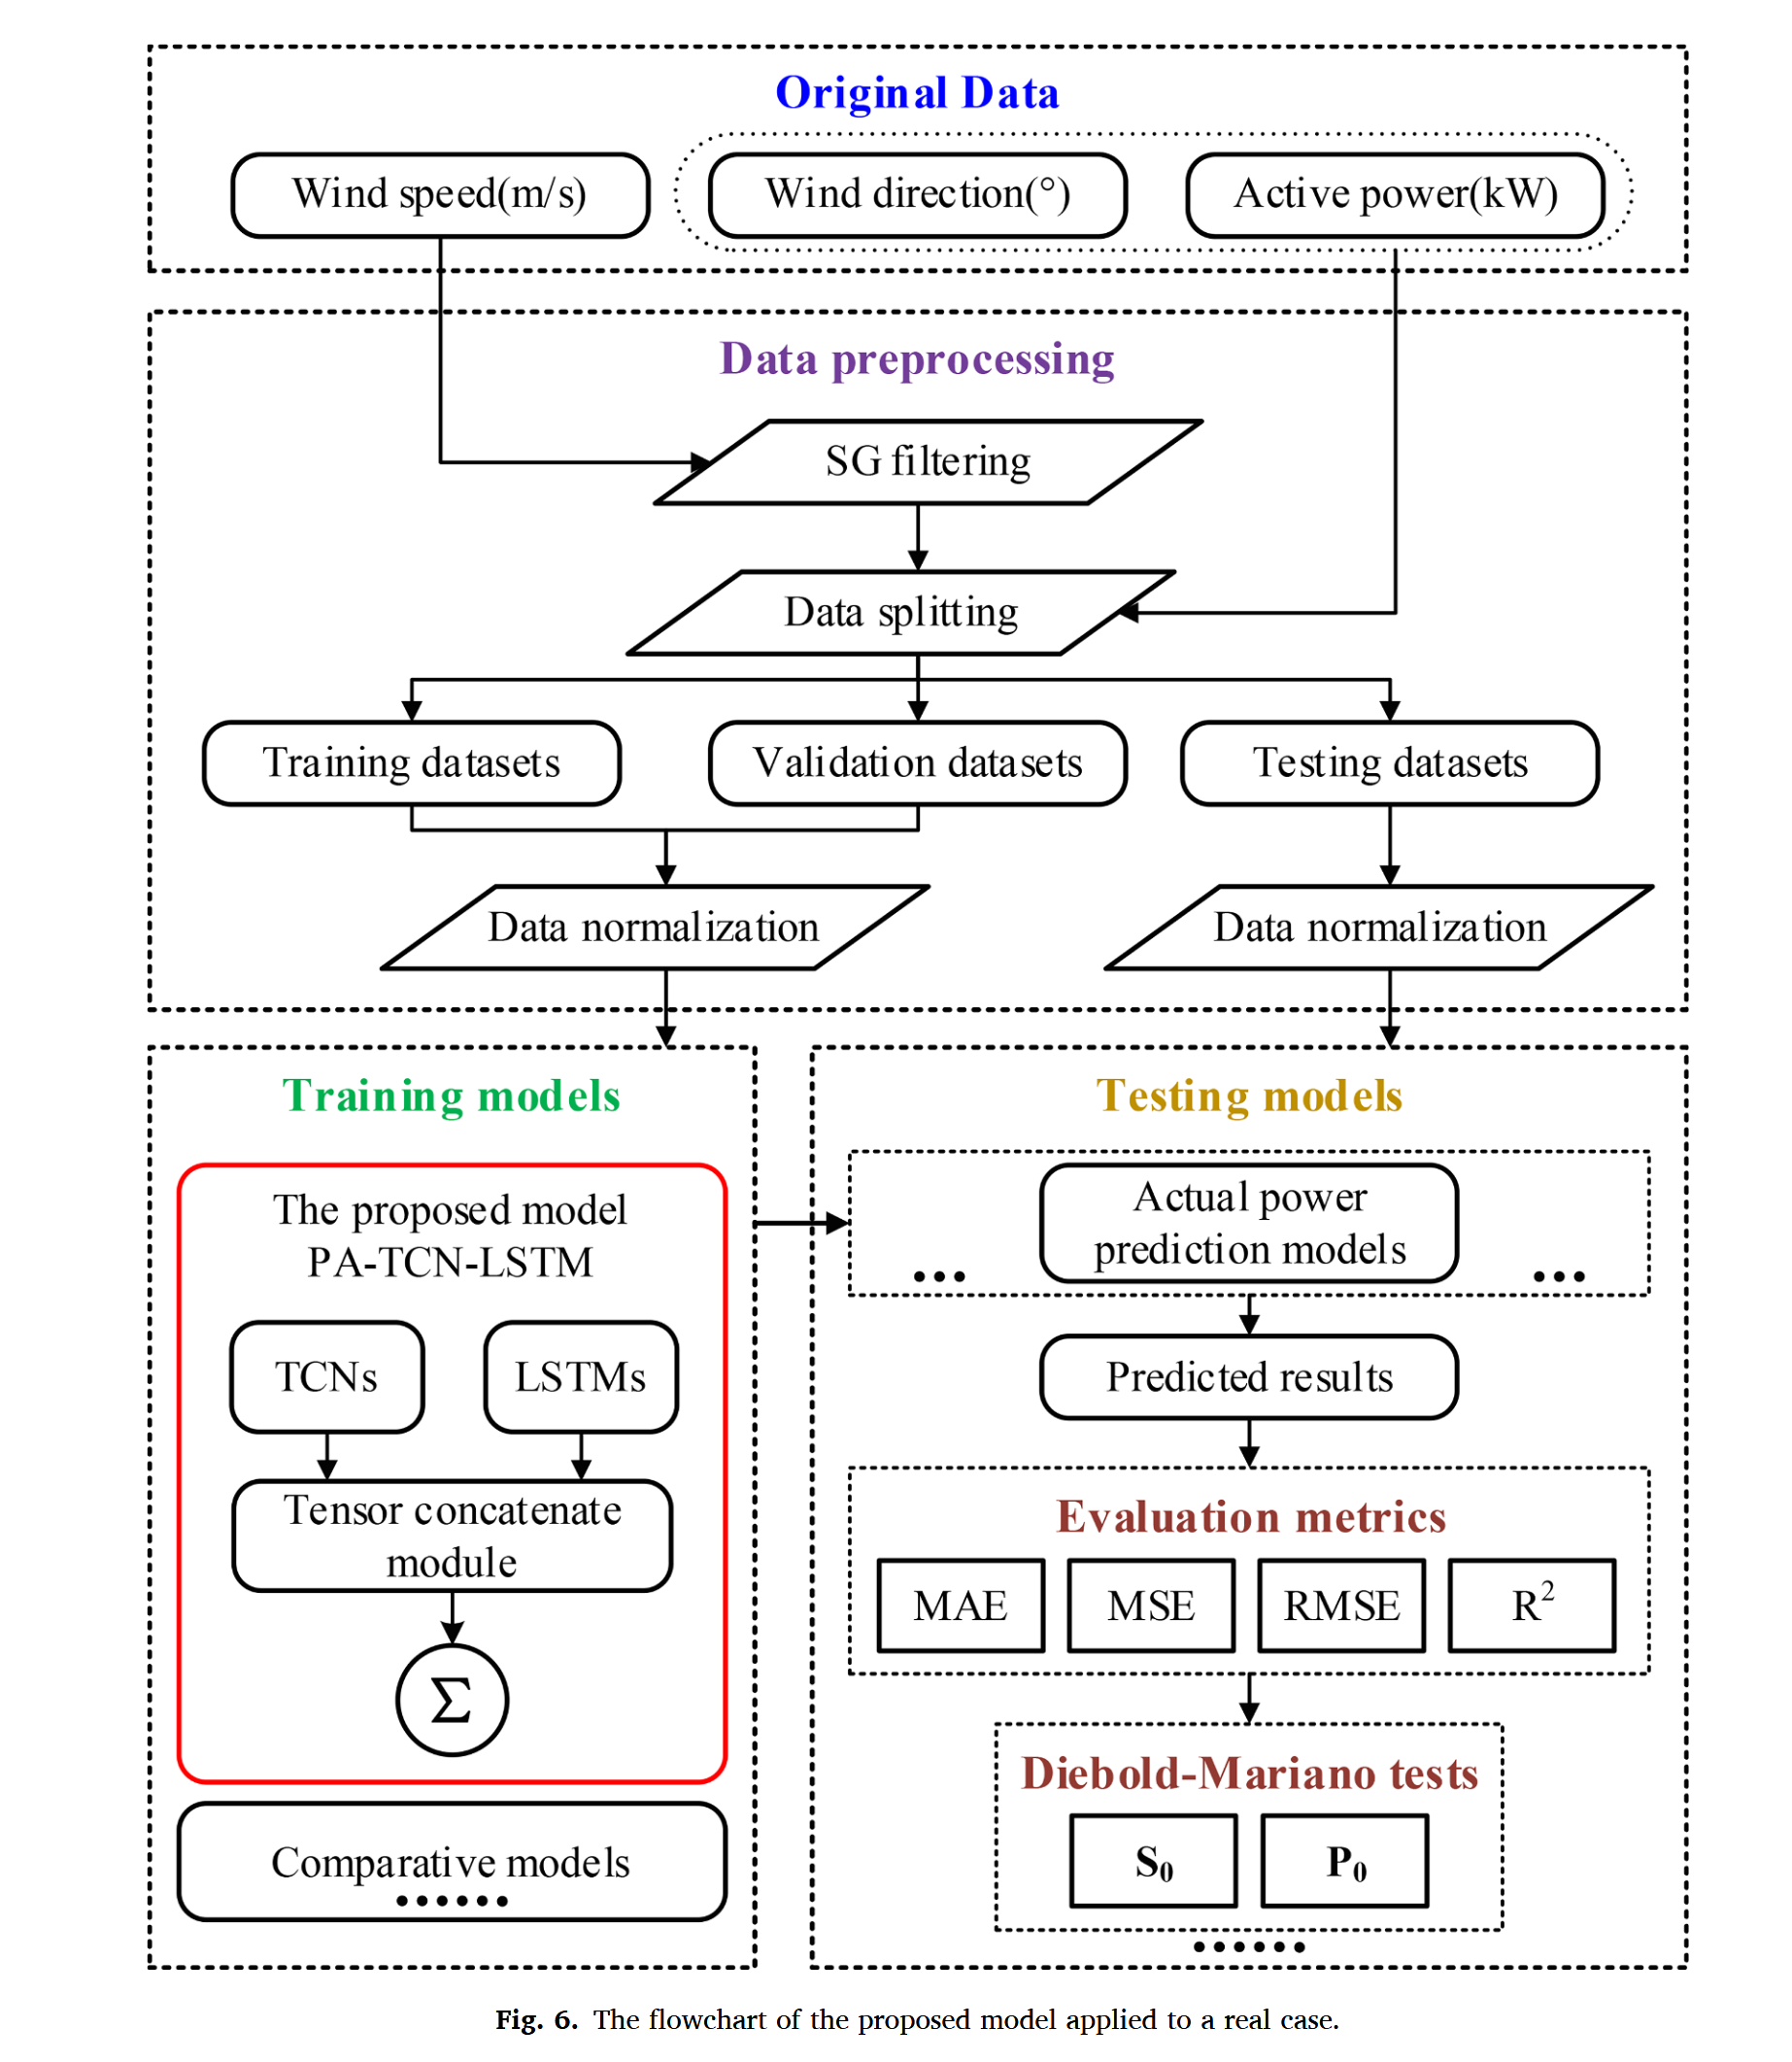
因此,本文提出一种融合TCN、LSTM、张量拼接模块和SG滤波器的混合预测模型,兼顾信号处理方法的优势与深度学习混合网络模型的高预测性能,同时降低模型复杂性和计算成本。在该模型中,SG滤波器用于平滑和去噪输入特征;TCN和LSTM分别独立运行,分别用于提取局部特征、长期依赖与上下文信息。TCN通过多层堆叠空洞因果卷积捕捉时间序列的长期依赖性,而LSTM通过门控单元保留序列全局信息。之后,模型通过张量拼接模块将两种网络的输出特征矩阵在特征维度上融合,并通过输出神经元生成预测值。
该方法的核心思想是并行架构 :即混合模型中的各个子模型在训练阶段彼此独立且并行地从原始时间序列中学习特征信息,模型深度由各个子模型自身深度决定,而非层层堆叠。张量拼接模块保证了每个子模型所学特征信息的完整保留。总而言之,本文所提出的混合模型具有与传统层叠混合网络相似的特征学习能力,但由于采用并行架构,其整体深度更浅,从而理论上在时间序列学习任务中实现更优的性能和效率。
本文的主要贡献如下:
- 提出一种独特架构的混合深度神经网络模型,用于从复杂风电时间序列中提取特征信息。该模型基于并行架构,具备较低复杂度,能更准确、高效地预测风电功率;
- 构建了一种混合模型并行架构,通过张量拼接模块在特征维度上融合TCN与LSTM网络的输出矩阵,完整保留各模型学习到的特征信息,提升模型的特征提取能力;
- 使用SG滤波器对输入风速序列进行平滑和去噪,进一步提高模型的预测性能。
文章结构如下:第二节详细介绍所提出的方法;第三节将该方法应用于实际案例并进行结果分析;第四节总结全文并展望未来的研究方向。
2. 方法
2.1 并行架构的混合深度学习模型
TCN 和 LSTM 各有优点,适用于不同的场景。TCN 通过多层堆叠的空洞因果卷积过程,专注于时间序列数据中的局部特征与长期依赖关系。而 LSTM 则通过门控单元来保留整个序列的全局感知能力,将历史信息存储在隐藏层中以传递上下文信息。将这两种模型结合起来,可以更全面、高效地捕捉局部与全局时间模式。因此,本文引入一种具有特殊架构的深度神经网络,将 TCN 与 LSTM 融合。
其网络结构如图 1 所示。从图中可以看出,该配置被称为并行架构 TCN-LSTM(Parallel Architecture TCN-LSTM,PA-TCN-LSTM) 。与经典的层级堆叠式混合模型(即前一层的输出作为下一层的输入,这里称为传统的 TCN-LSTM 模型)不同,本文提出的 PA-TCN-LSTM 由两个独立的模型和一个特殊的架构组成:一个是堆叠 n n n 层的 TCN 网络,另一个是堆叠 m m m 层的 LSTM 网络。
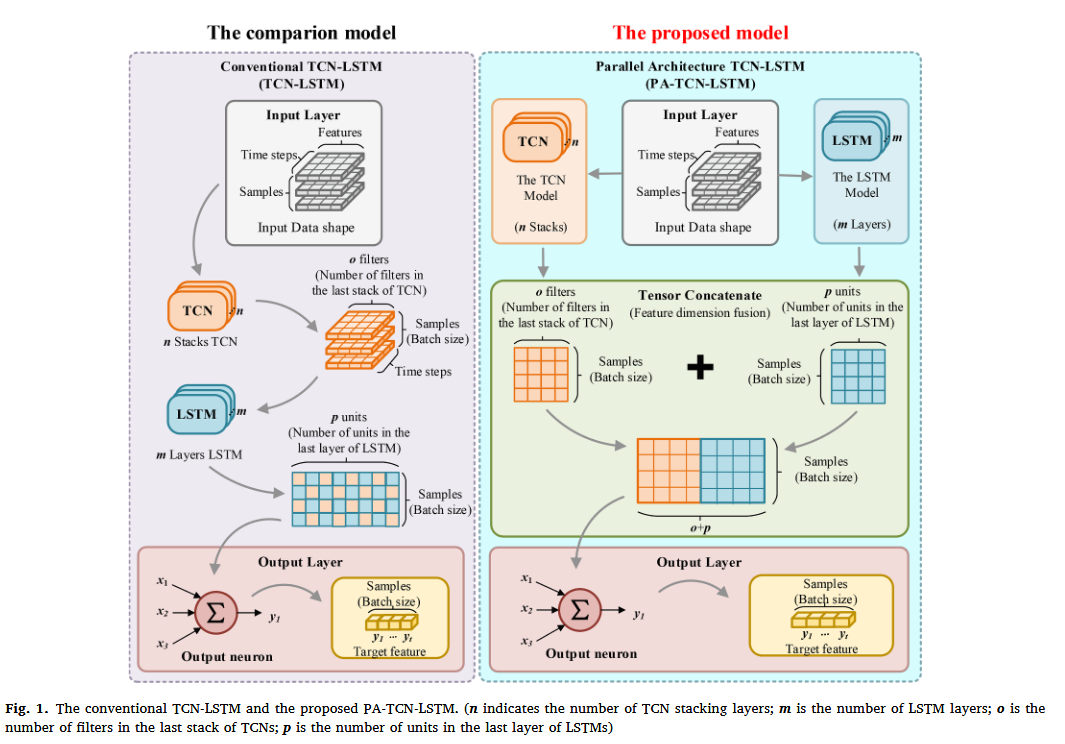
这两个多层网络共享相同的输入数据,彼此独立运行。随后,通过张量拼接模块(tensor concatenate module)将两个网络的输出在特征维度上连接,并通过输出层生成目标预测值。输出层的神经元激活函数采用线性激活函数,其原理如下所示:
y t = RELU ( w ∑ i = 1 N x i + b ) (1) y_t = \text{RELU} \left( w \sum_{i=1}^{N} x_i + b \right) \tag{1} yt=RELU(wi=1∑Nxi+b)(1)
其中, y t y_t yt 是输出的目标值, x i x_i xi 是第 i i i 个输入, w w w 是权重, b b b 是偏置, RELU \text{RELU} RELU 是修正线性单元函数, N N N 为输入数量。对于 TCN-LSTM 模型, N = p N = p N=p;对于 PA-TCN-LSTM 模型, N = o + p N = o + p N=o+p。
2.2 时序卷积网络(Temporal Convolutional Network, TCN)
TCN 是一种基于 CNN 架构设计的模型,专用于处理时间序列数据。当前已有大量研究表明,TCN 在交通估计、语音识别、机器翻译和人体动作识别等多个领域中具有广泛应用价值。然而,TCN 在风电预测中的应用仍相对较少 40。
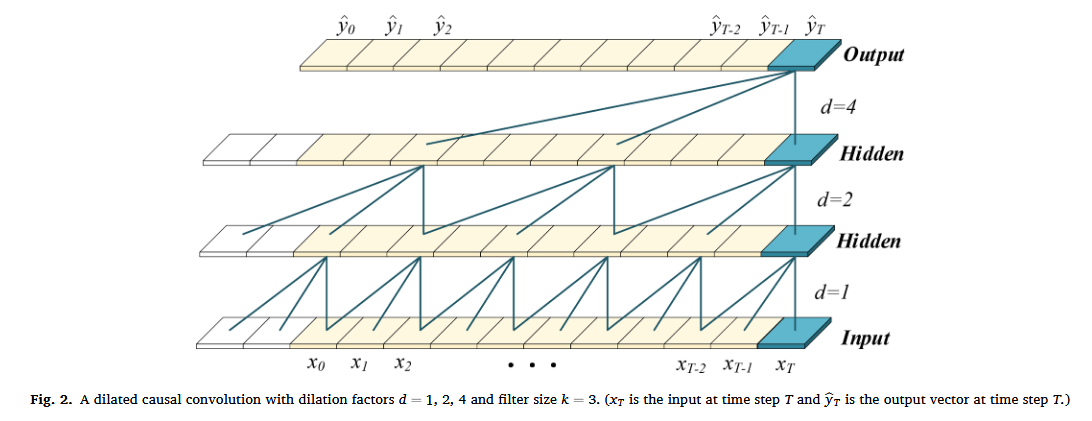
在本研究中,采用 TCN 网络对风电时间序列数据中各时间步的特征进行提取,通过训练学习特征与趋势,以实现未来功率输出的预测。TCN 主要包括以下三个基本特性:因果卷积、空洞卷积以及残差连接。
因果卷积 遵循严格的时间约束,仅依赖于当前时间 t t t 及其过去的值,不能获取未来的数据,呈单向结构,缺乏双向能力。其定义如下,假设 TCN 的滤波器为 F = ( f 1 , f 2 , f 3 , ⋯ , f k ) F = (f_1, f_2, f_3, \cdots, f_k) F=(f1,f2,f3,⋯,fk),序列 X = ( x 1 , x 2 , x 3 , ⋯ , x T ) X = (x_1, x_2, x_3, \cdots, x_T) X=(x1,x2,x3,⋯,xT) 在时间步 x t x_t xt 上的因果卷积为:
( F ∗ X ) ( x t ) = ∑ k = 1 K f k x t − K + k (2) (F * X)(x_t) = \sum_{k=1}^{K} f_k x_{t-K+k} \tag{2} (F∗X)(xt)=k=1∑Kfkxt−K+k(2)
空洞卷积 与传统卷积不同,它在卷积过程中以间隔方式采样输入,从而用更少的层数获得更大的感受野。这样可以避免添加池化层而导致信息丢失的问题。其在时间步 x t x_t xt 上的定义为:
F ( s ) = ( x ∗ d f ) ( s ) = ∑ i = 0 k f ( i ) ⋅ x s − d ⋅ i (3) F(s) = (x *d f)(s) = \sum{i=0}^{k} f(i) \cdot x_{s - d \cdot i} \tag{3} F(s)=(x∗df)(s)=i=0∑kf(i)⋅xs−d⋅i(3)
其中, d d d 为空洞率,通常随着网络层数增加按指数(如 2)增长; k k k 为卷积核的大小; s − d ⋅ i s - d \cdot i s−d⋅i 表示时间方向上的过去值。
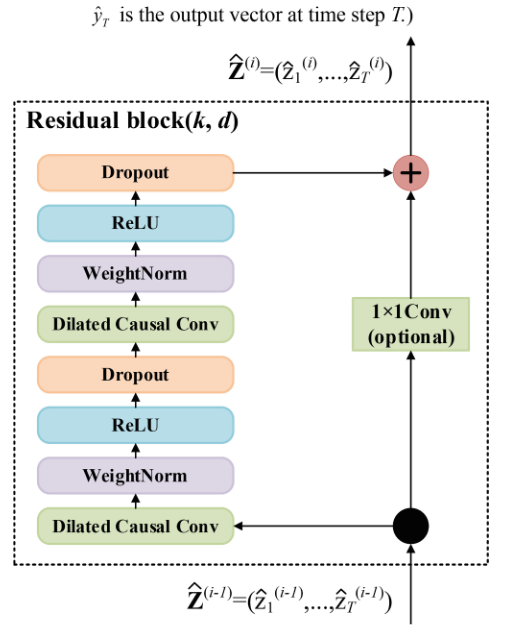
残差连接 已被证明在深度网络训练中具有良好效果,可实现跨层信息传递。一个残差块中包含一个分支,该分支执行一系列变换 F F F,并将其输出与输入 X X X 相加,计算公式如下:
o = Activation ( X + F ( X ) ) (4) o = \text{Activation}(X + F(X)) \tag{4} o=Activation(X+F(X))(4)
在原始文献 27 中,残差块用于替代卷积层。如图 3 所示,在一个残差块中,TCN 包含两层空洞因果卷积及非线性变换,激活函数采用 RELU \text{RELU} RELU。为了归一化,卷积核应用权重归一化。此外,在每一层空洞卷积之后还引入了空间 Dropout 进行正则化,即在每次训练中将整个通道置零。
2.3 长短期记忆神经网络(LSTM)
长短期记忆神经网络(LSTM)是一种优化后的循环神经网络(RNN)变体,旨在缓解传统神经网络中梯度消失或爆炸的问题,从而有效建模长期依赖关系。LSTM 架构经过多位学者不断完善,在多种时间序列问题中表现出色。
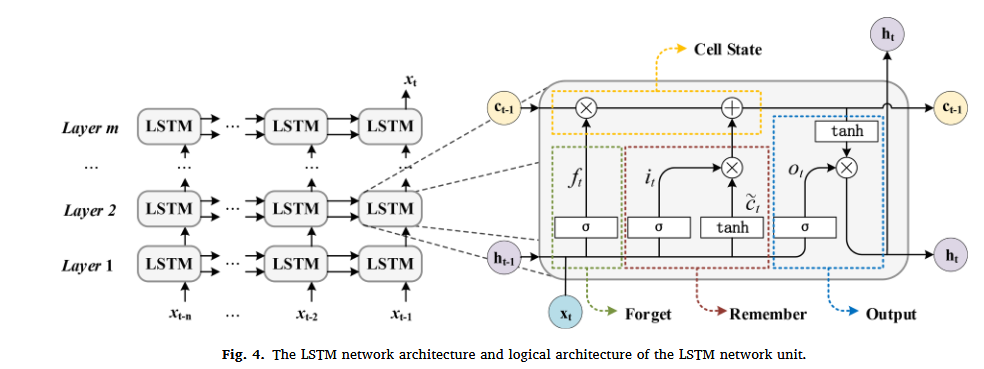
一个 LSTM 单元由三个门控组成:输入门、输出门与遗忘门 41。LSTM 基本单元及其网络结构如图 4 所示,其紧凑的数学表达如下:
f t = σ g ( W f x t + U f h t − 1 + b f ) (5) f_t = \sigma_g(W_f x_t + U_f h_{t-1} + b_f) \tag{5} ft=σg(Wfxt+Ufht−1+bf)(5)
i t = σ g ( W i x t + U i h t − 1 + b i ) (6) i_t = \sigma_g(W_i x_t + U_i h_{t-1} + b_i) \tag{6} it=σg(Wixt+Uiht−1+bi)(6)
o t = σ g ( W o x t + U o h t − 1 + b o ) (7) o_t = \sigma_g(W_o x_t + U_o h_{t-1} + b_o) \tag{7} ot=σg(Woxt+Uoht−1+bo)(7)
c ~ t = σ c ( W c x t + U c h t − 1 + b c ) (8) \tilde{c}t = \sigma_c(W_c x_t + U_c h{t-1} + b_c) \tag{8} c~t=σc(Wcxt+Ucht−1+bc)(8)
c t = f t ⊙ c t − 1 + i t ⊙ c ~ t (9) c_t = f_t \odot c_{t-1} + i_t \odot \tilde{c}_t \tag{9} ct=ft⊙ct−1+it⊙c~t(9)
h t = o t ⊙ σ h ( c t ) (10) h_t = o_t \odot \sigma_h(c_t) \tag{10} ht=ot⊙σh(ct)(10)
其中, x t x_t xt 是输入向量; f t f_t ft、 i t i_t it 和 o t o_t ot 分别为遗忘门、输入门与输出门的激活向量; c ~ t \tilde{c}_t c~t 为候选单元状态; c t c_t ct 为当前单元状态; σ \sigma σ 表示门控的激活函数; W W W、 U U U、 b b b 为需要训练学习的权重矩阵和偏置向量; h t h_t ht 为 LSTM 单元的隐藏状态向量(即输出向量),由 o t o_t ot 和 σ h ( c t ) \sigma_h(c_t) σh(ct) 的 Hadamard 乘积获得。
2.4 张量拼接模块(Tensor Concatenate Module)
张量拼接模块的作用是在指定的轴上拼接多个张量。TCN 最后一层和 LSTM 最后一层的输出均为二维张量结构,本模块用于将二者在特征维度 上拼接,保留两个模型学习到的综合特征信息。该模块的功能结构如图 5 所示。
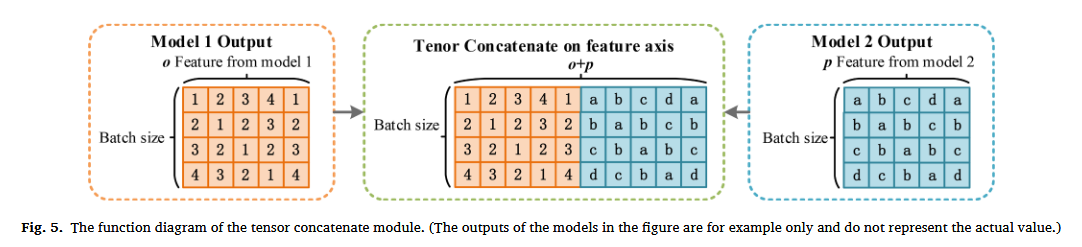
此模块的实现基于 TensorFlow 库中的 concatenate 层。需要注意的是,使用张量拼接模块时,拼接轴上的维度必须一致,否则会发生维度不匹配错误。在本研究中,特征轴所对应的维度为批次大小,因此可安全进行拼接操作。
3. 案例研究
本节将所提出的模型应用于真实风电数据集以测试其性能。具体工作流程图如图 6 所示。
3.1 数据说明
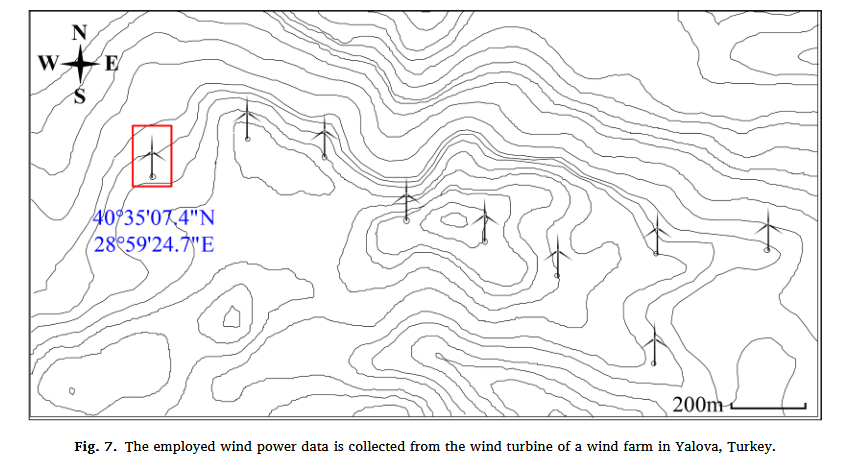
数据来自土耳其 Yalova 某风电场中一台风力发电机组于 2018 年 1 月 1 日至 12 月 31 日的实际运行监测记录。风电机组的地理坐标为 4 0 ∘ 35 ′ 7 ′′ N , 2 8 ∘ 59 ′ 25 ′′ E 40^\circ35′7′′\ \text{N},\ 28^\circ59′25′′\ \text{E} 40∘35′7′′ N, 28∘59′25′′ E,详细地理信息如图 7 所示。可以看出,该风电场位于植被覆盖稀少的丘陵地带,因此风力发电机组的输出功率主要受气象条件影响。
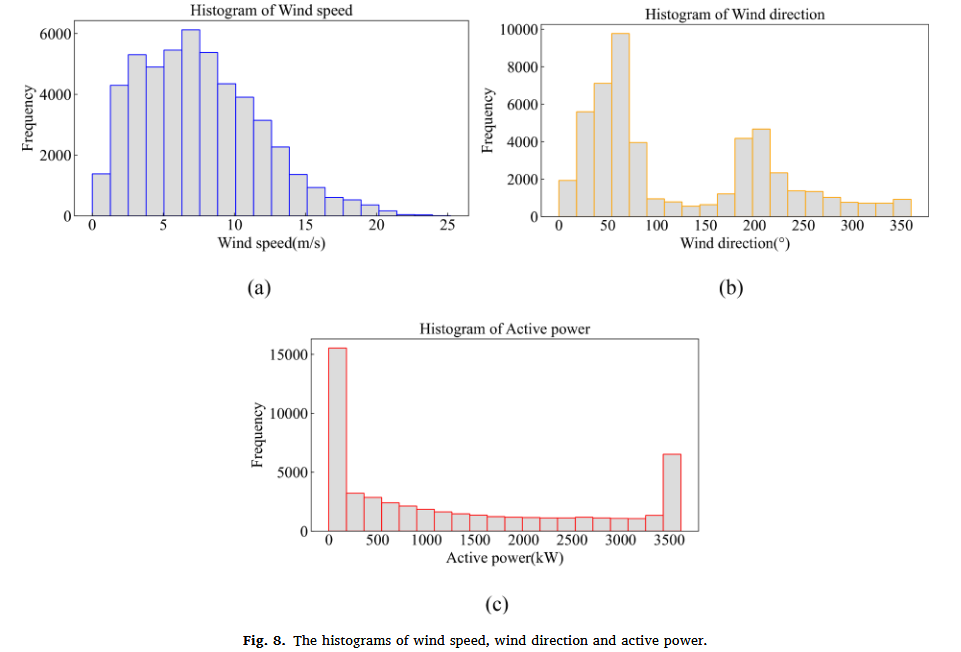
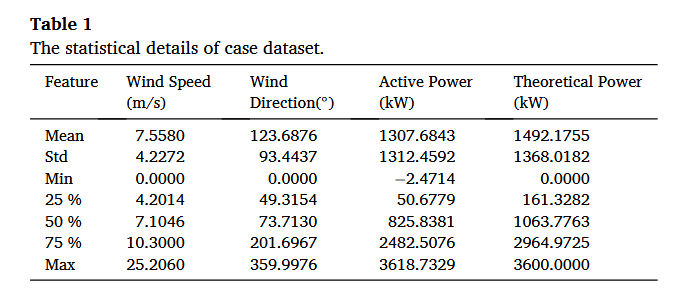
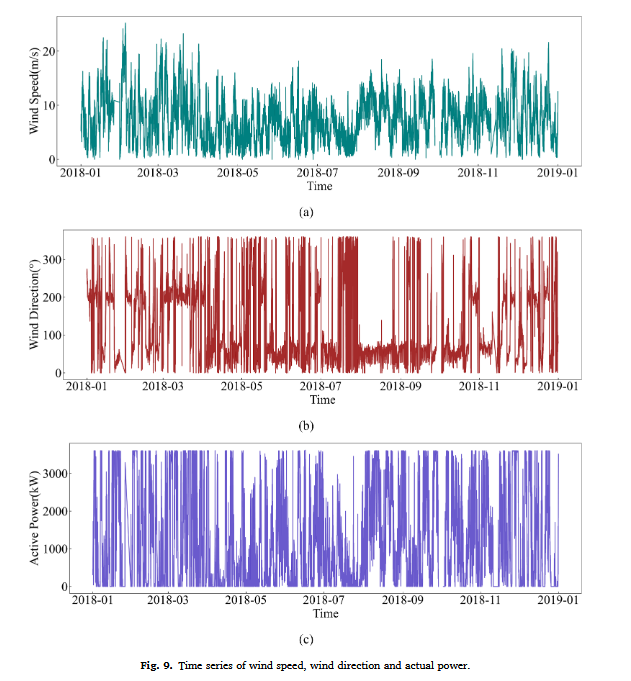
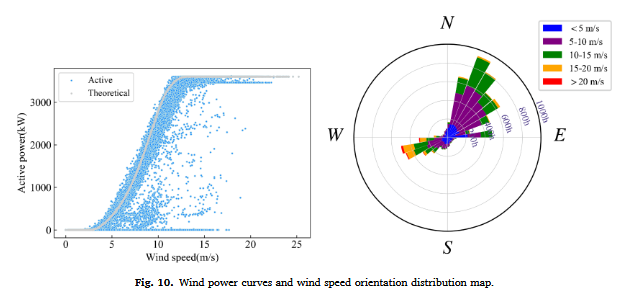
监控数据由 SCADA 系统每 10 分钟采集一次,主要记录每个时刻的风向、风速、理论功率和实际功率。总计采集了 50,530 条数据记录。数据集的详细统计信息见表 1。风速、风向和有功功率的统计直方图见图 8。风速主要分布在 0 m/s 到 15 m/s 之间,峰值频率集中在 6 m/s 到 7 m/s 之间。风向分布呈现出两个局部峰值,表明可能存在两个风群体。图 9 展示了时间序列图,图 10 展示了风功率曲线及风速方向分布图。
3.2 数据预处理
为了使数据便于深度学习网络理解,需对其进行一系列预处理,包括去噪、归一化和数据集划分。
3.2.1 SG 滤波去噪
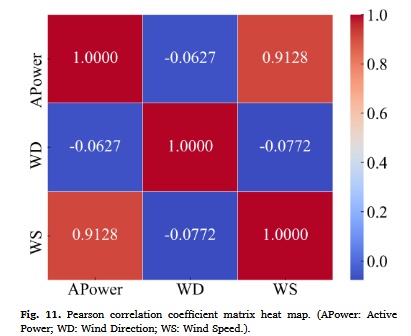
风电机组 SCADA 监控数据常受到故障、传感器老化、传输损耗等因素的影响而产生噪声。如果不对这些异常数据进行滤除,将会对模型预测精度造成不利影响。根据相关研究 37, 42,图 11 显示了本文数据中三种特征变量之间的 Pearson 相关系数矩阵,初步分析三者之间的线性关系强度,其中风速与有功功率之间的 Pearson 相关系数达到了 0.9128,为最强相关性。
Savitzky-Golay (SG) 滤波器由于其平滑特性强、参数调整少等优点,非常适用于数据去噪。因此,本文采用 SG 滤波器对与有功功率关系最强的风速序列进行平滑和去噪,并使用处理后的风速数据代替原始数据来训练深度学习模型。
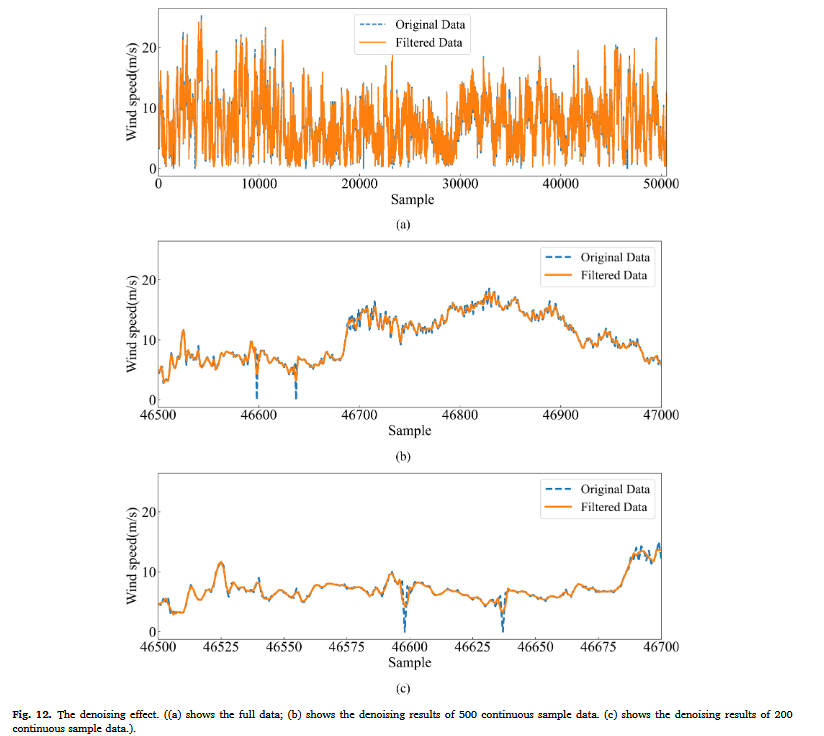
SG 滤波器具有两个可调节参数:数据帧长度和多项式阶数。本文采用的 SG 滤波器多项式阶数为 2,数据帧长度为 5,以减少风速数据噪声 35。去噪结果如图 12 所示,可以看出数据更平滑,去噪效果良好。
3.2.2 数据划分与归一化
将数据集按 7:1:2 的比例划分为训练集、验证集和测试集。归一化过程使用以下公式:
y norm = x − x min x max − x min (11) y_{\text{norm}} = \frac{x - x_{\min}}{x_{\max} - x_{\min}} \tag{11} ynorm=xmax−xminx−xmin(11)
其中, y norm y_{\text{norm}} ynorm 为归一化后的值, x x x 为原始数据, x max x_{\max} xmax 和 x min x_{\min} xmin 分别为最大值和最小值。
3.3 评估指标
本文采用归一化平均绝对误差(nMAE)、归一化均方误差(nMSE)、归一化均方根误差(nRMSE)和 R 2 R^2 R2 值作为评估模型预测性能的指标。训练过程中以 nMSE 作为精度评估标准。
nMAE = 1 N ∑ i = 1 N ∣ y i − y ^ i ∣ (12) \text{nMAE} = \frac{1}{N} \sum_{i=1}^{N} \left| y_i - \hat{y}_i \right| \tag{12} nMAE=N1i=1∑N∣yi−y^i∣(12)
nMSE = 1 N ∑ i = 1 N ( y i − y ^ i ) 2 (13) \text{nMSE} = \frac{1}{N} \sum_{i=1}^{N} \left( y_i - \hat{y}_i \right)^2 \tag{13} nMSE=N1i=1∑N(yi−y^i)2(13)
nRMSE = 1 N ∑ i = 1 N ( y i − y ^ i ) 2 (14) \text{nRMSE} = \sqrt{ \frac{1}{N} \sum_{i=1}^{N} \left( y_i - \hat{y}_i \right)^2 } \tag{14} nRMSE=N1i=1∑N(yi−y^i)2 (14)
R 2 = 1 − ∑ i = 1 N ( y i − y ^ i ) 2 ∑ i = 1 N ( y i − y ˉ ) 2 (15) R^2 = 1 - \frac{ \sum_{i=1}^{N} \left( y_i - \hat{y}i \right)^2 }{ \sum{i=1}^{N} \left( y_i - \bar{y} \right)^2 } \tag{15} R2=1−∑i=1N(yi−yˉ)2∑i=1N(yi−y^i)2(15)
其中, y i y_i yi 为实际值, y ^ i \hat{y}_i y^i 为预测值, N N N 为样本总数。
3.4 实验结果与分析
本节通过以下实验验证所提出的 PA-TCN-LSTM 模型在风功率预测中的优越性能:
- 实验 I :通过使用 SG 滤波器对风速序列进行去噪和平滑处理来提升各模型的预测性能,并初步验证所提出模型的预测效果。
- 实验 II :通过超参数优化进一步提升预测性能。
- 实验 III :对所提模型与对比模型的预测性能与效率进行综合分析与评估,并引入 Diebold-Mariano 检验进行进一步分析。
所有实验均在相同的计算机环境下进行:Intel® Core™ i5-11400 处理器(2.6 GHz 主频)与 24.0 GB 内存。为保证公平性与结果稳定性,每个模型运行三次,最终结果取平均值。
3.4.1 实验 I
首先构建一个初步的深度学习网络,其为并行结构,包含两个卷积堆叠的 TCN 层与三层 LSTM。其次,引入一个使用相同超参数的传统 TCN-LSTM(两个 TCN 层后接三层 LSTM),并引入单独的 TCN 与 LSTM 模型作为对比,以全面验证数据滤波的益处以及所提出模型的可行性与优越性。详细模型结构见表 2。
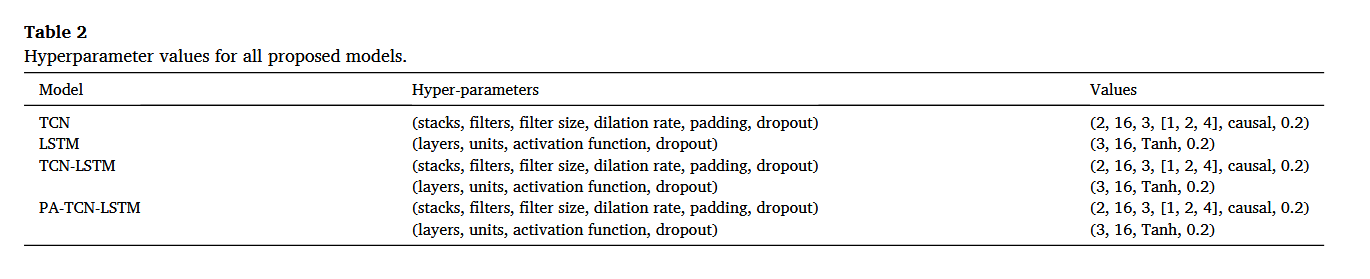
表 2 各提出模型的超参数取值
| 模型 | 超参数项 | 取值 |
|---|---|---|
| TCN | 堆叠层数 (stacks) | 2 |
| 滤波器数量 (filters) | 16 | |
| 滤波器大小 (filter size) | 3 | |
| 扩张率 (dilation rate) | 1, 2, 4 | |
| 填充方式 (padding) | causal | |
| Dropout 比例 | 0.2 | |
| LSTM | 层数 (layers) | 3 |
| 单元数 (units) | 16 | |
| 激活函数 (activation function) | Tanh | |
| Dropout 比例 | 0.2 | |
| TCN-LSTM | TCN 部分 | (2, 16, 3, 1, 2, 4, causal, 0.2) |
| LSTM 部分 | (3, 16, Tanh, 0.2) | |
| PA-TCN-LSTM | TCN 部分 | (2, 16, 3, 1, 2, 4, causal, 0.2) |
| LSTM 部分 | (3, 16, Tanh, 0.2) |
上述模型分别在原始数据与去噪后的数据上进行测试。最终将时间步设置为 12,训练时使用 Adam 优化器,损失函数为 MSE,批量大小设为 64,训练轮数为 150。
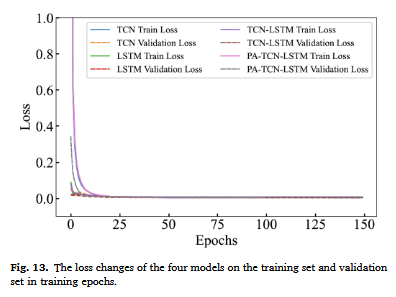
图 13 显示了四种模型在训练过程中损失随 epoch 增加的变化趋势,在训练集与验证集上均未出现过拟合现象。图 14 展示了四种模型在原始测试集与去噪测试集下的预测结果。表 3 给出了四种模型在两类测试集上的评估指标结果,图 15 展示了各模型在原始与滤波数据下预测性能的雷达图。
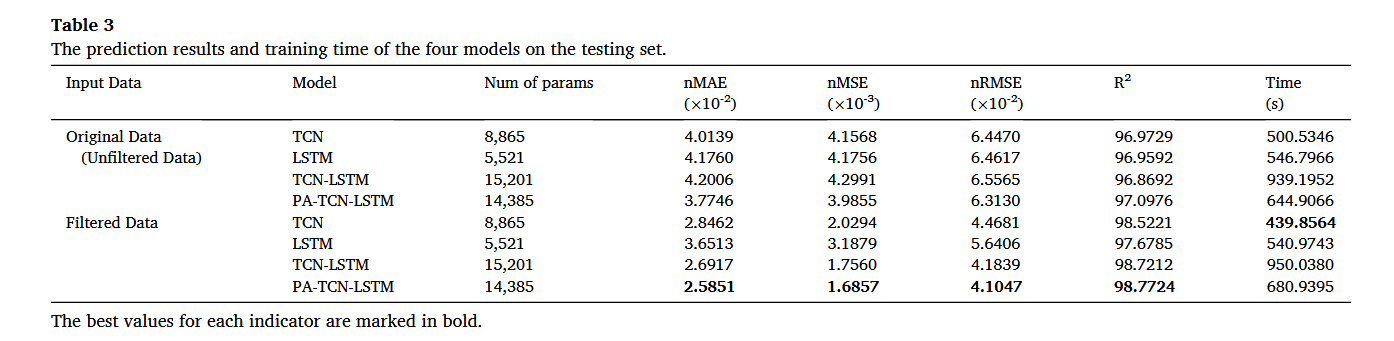
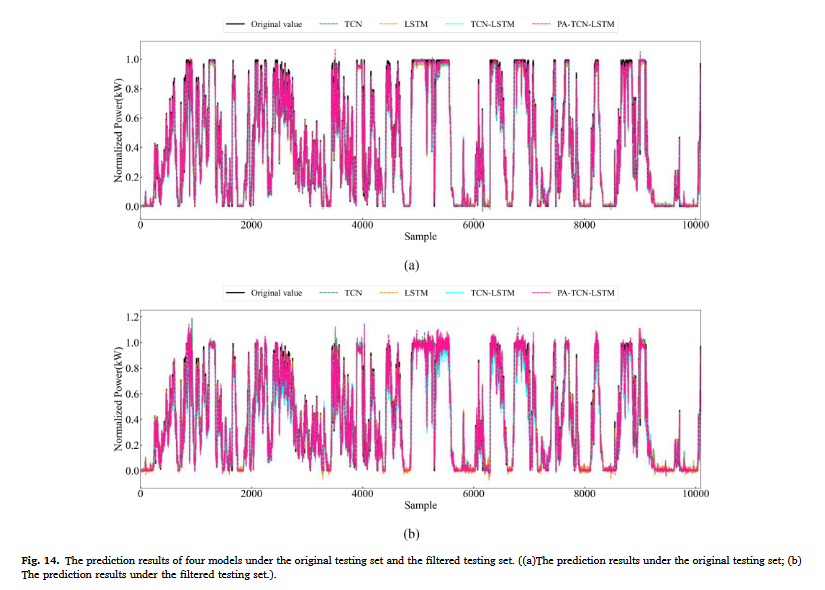
结果显示,SG 滤波后模型的预测性能均有提升:
- 对于 TCN,nMAE、nMSE 与 nRMSE 分别降低了 29.09%、51.18%、30.69%, R 2 R^2 R2 增加了 1.55%;
- 对于 LSTM,nMAE、nMSE 与 nRMSE 分别降低了 12.56%、23.65%、12.71%, R 2 R^2 R2 增加了 0.72%;
- 对于 TCN-LSTM,nMAE、nMSE 与 nRMSE 分别降低了 35.92%、59.15%、36.19%, R 2 R^2 R2 增加了 1.85%;
- 对于 PA-TCN-LSTM,nMAE、nMSE 与 nRMSE 分别降低了 31.51%、57.70%、34.98%, R 2 R^2 R2 增加了 1.67%。
此外,与 TCN-LSTM 相比,在使用相同超参数设定时,PA-TCN-LSTM 模型训练参数数量减少了 816,计算时间分别减少了 31.33% 和 28.33%,而预测性能不降反升,显示出显著的研究价值。
3.4.2 实验二
本节旨在通过超参数优化,进一步探索和提升所提出模型的预测性能。优化过程分为三个步骤进行:
首先,确定最优的 TCN 滤波器数量与 LSTM 单元数量的组合;
接着,在第一步确定的最优配置基础上,选择最佳的 TCN 滤波器大小;
最后,在前两步优化结果的基础上,选择最适合的 LSTM 激活函数、优化器及训练批量大小。
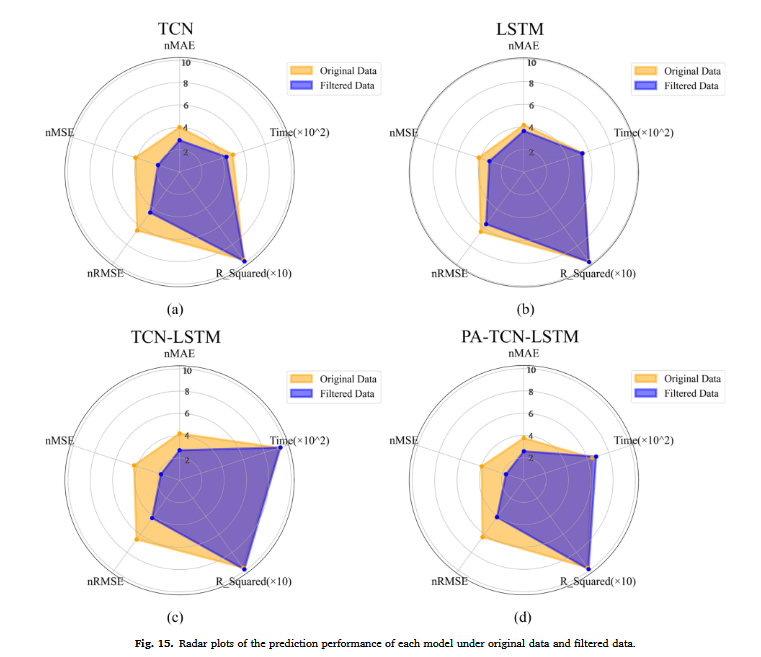
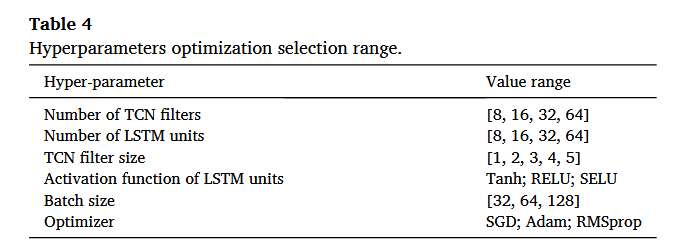
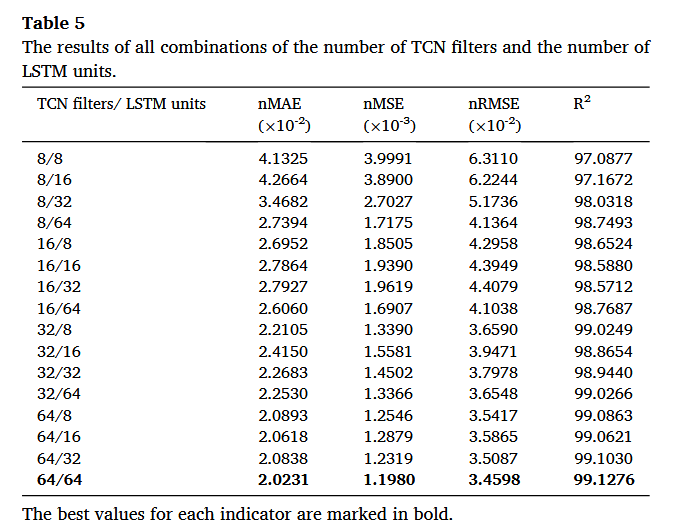
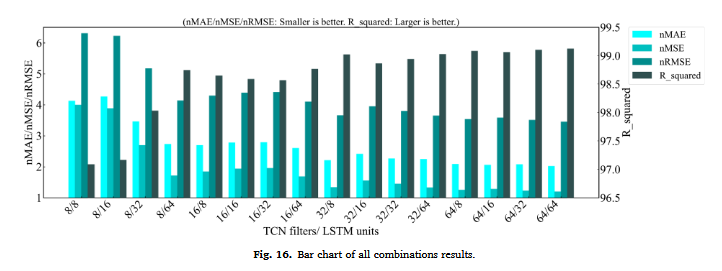
表 4 给出了具体的超参数优化选取范围。表 5 和图 16 展示了不同 TCN 滤波器数量与 LSTM 单元数量组合下的模型结果。可观察到,随着滤波器数量和单元数的增加,模型性能逐步提升。最终,在 TCN 滤波器数量为 64 且 LSTM 单元数为 64 的配置下,模型性能最佳。
选择合适的滤波器大小对提升模型性能尤为关键。在确定 TCN 滤波器数量和 LSTM 单元最优组合的前提下,图 17 展示了当 TCN 滤波器大小分别设置为 1、2、3、4 和 5 时模型的表现。结果表明,当滤波器大小设置为 3 时,各项评估指标均达到最优,模型性能最强。
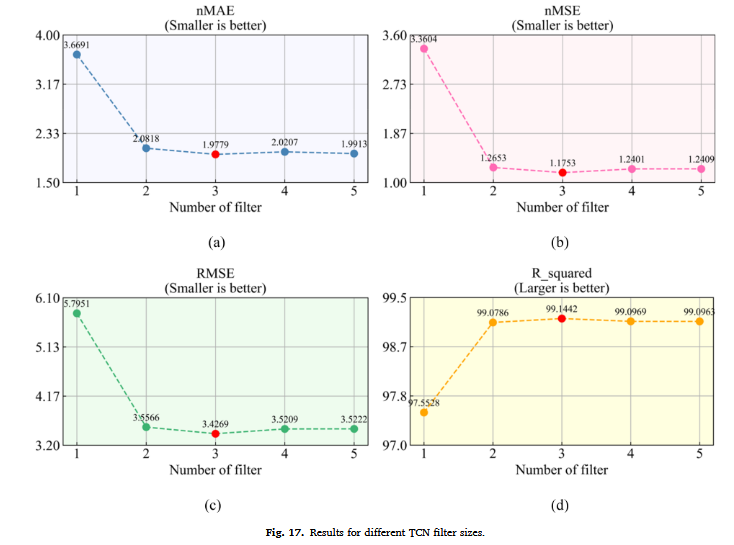
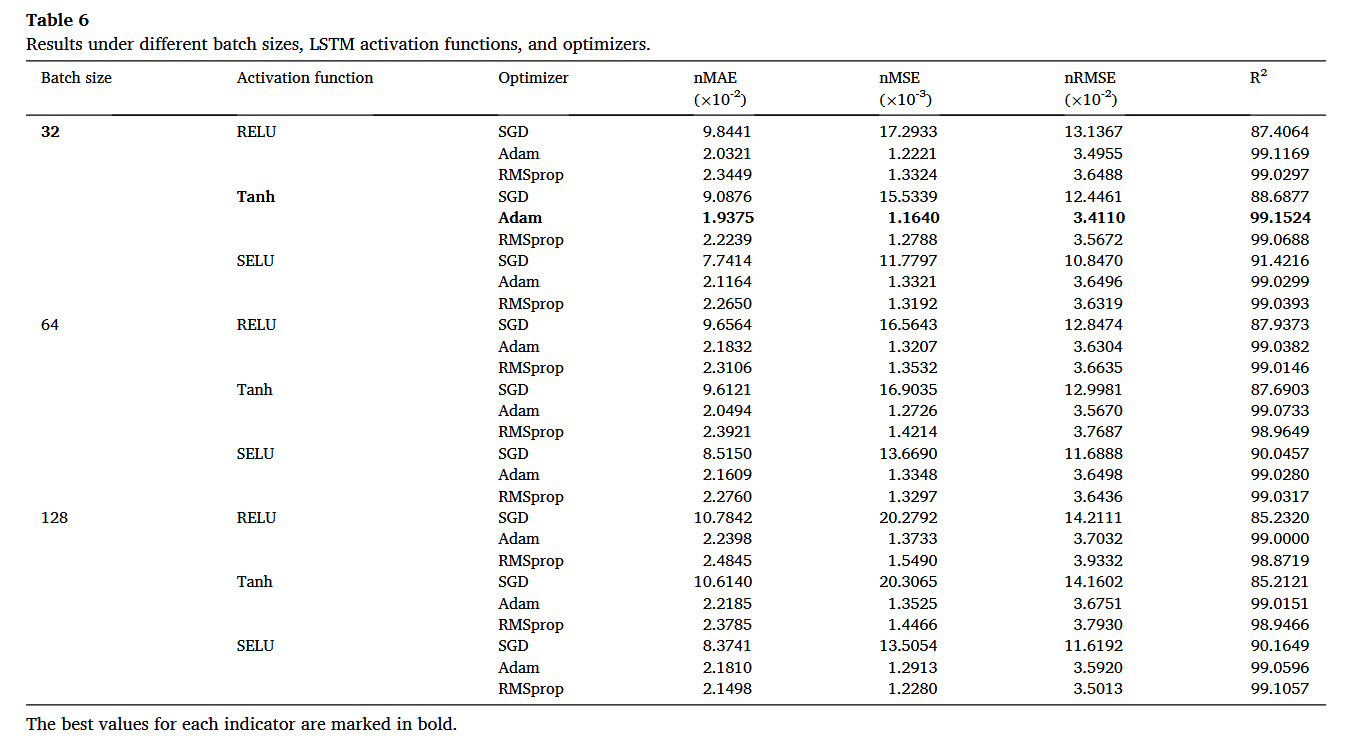
表 6 显示了不同批量大小、LSTM 激活函数及优化器组合下的模型表现。最终确定的最优批量大小为 32,激活函数为 Tanh,优化器为 Adam。
3.4.3 实验三
本节引入若干单一模型及传统混合模型作为对比模型,以验证所提出模型的预测性能优势。单一模型包括:KNN、SVR、XGBoost、RF、多层感知器(MLP)、RNN、LSTM、CNN 和 TCN;传统混合模型包括当前广泛应用的 CNN-LSTM 及常规 TCN-LSTM。需要注意的是,RNN 和 LSTM 模型均构建为三层网络,其它超参数与所提出模型保持一致。MLP 模型同样为三层结构,其它超参数通过网格搜索与交叉验证确定。CNN 模型设置为两层卷积层并连接一个展平层,其余超参数与提出模型中的 TCN 模块相同;CNN-LSTM 模型包含两层 CNN 与三层 LSTM,TCN-LSTM 模型的所有超参数也与所提模型保持一致。所提模型使用的是实验二中超参数优化后的最终模型。
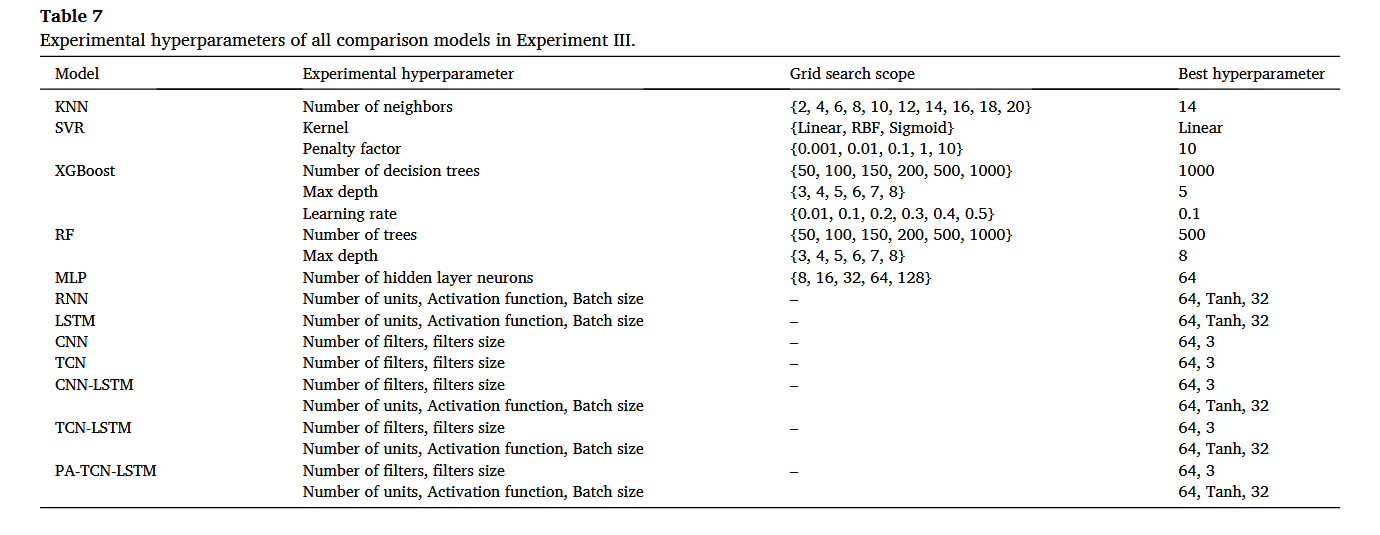
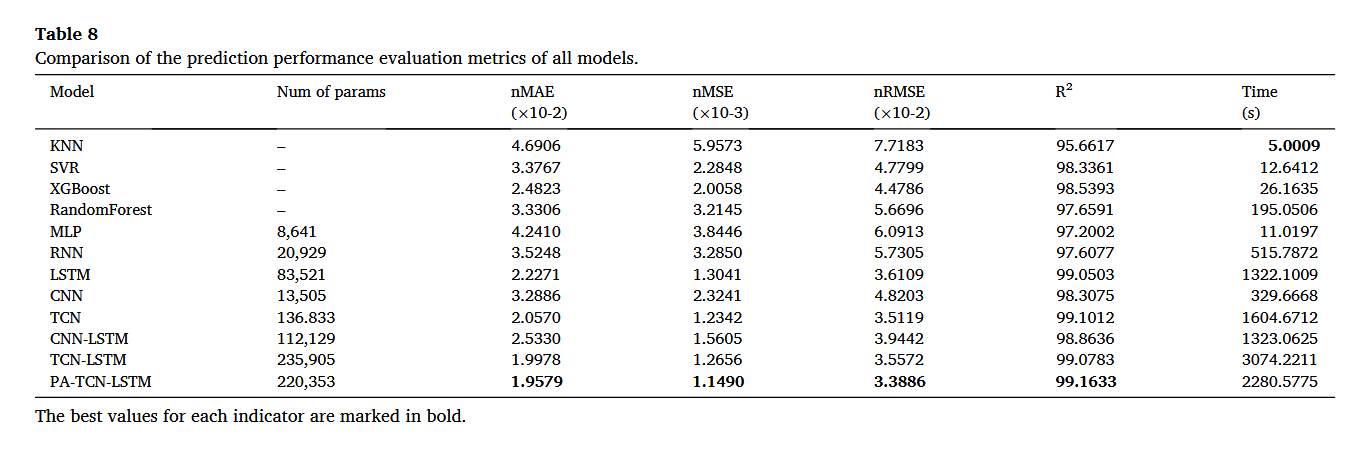
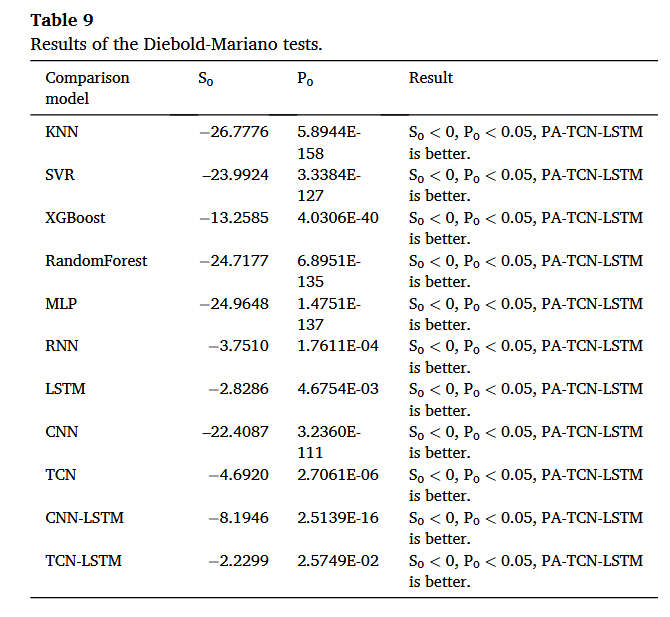
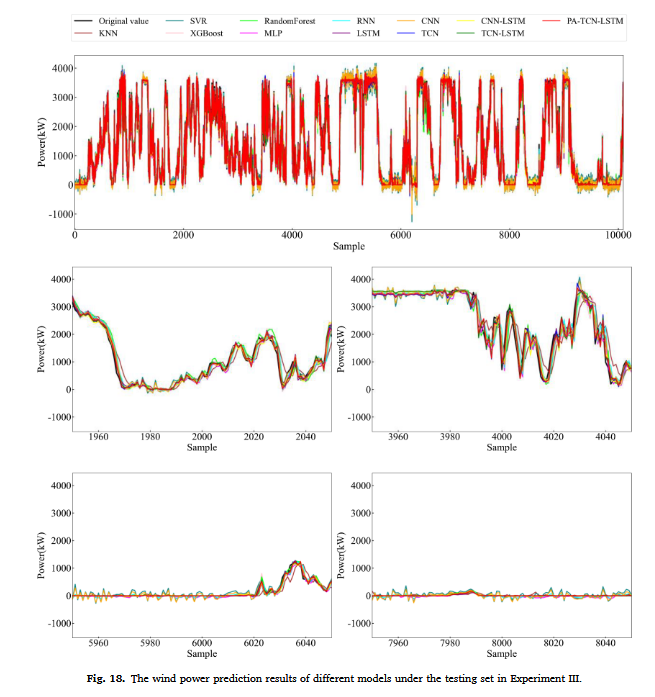
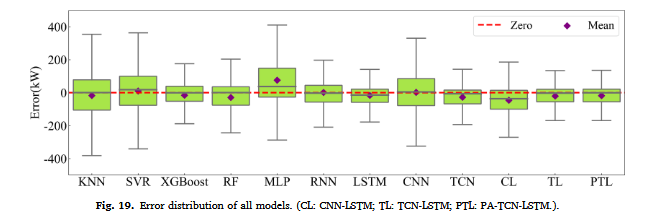
表 7 详细列出了各模型的网格搜索范围与参数配置。图 18 展示了各模型在测试集上的风电预测结果;图 19 显示了各模型预测误差的分布;图 20 为各模型预测值的散点图;图 21 与表 8 给出了各模型的预测性能评估指标。
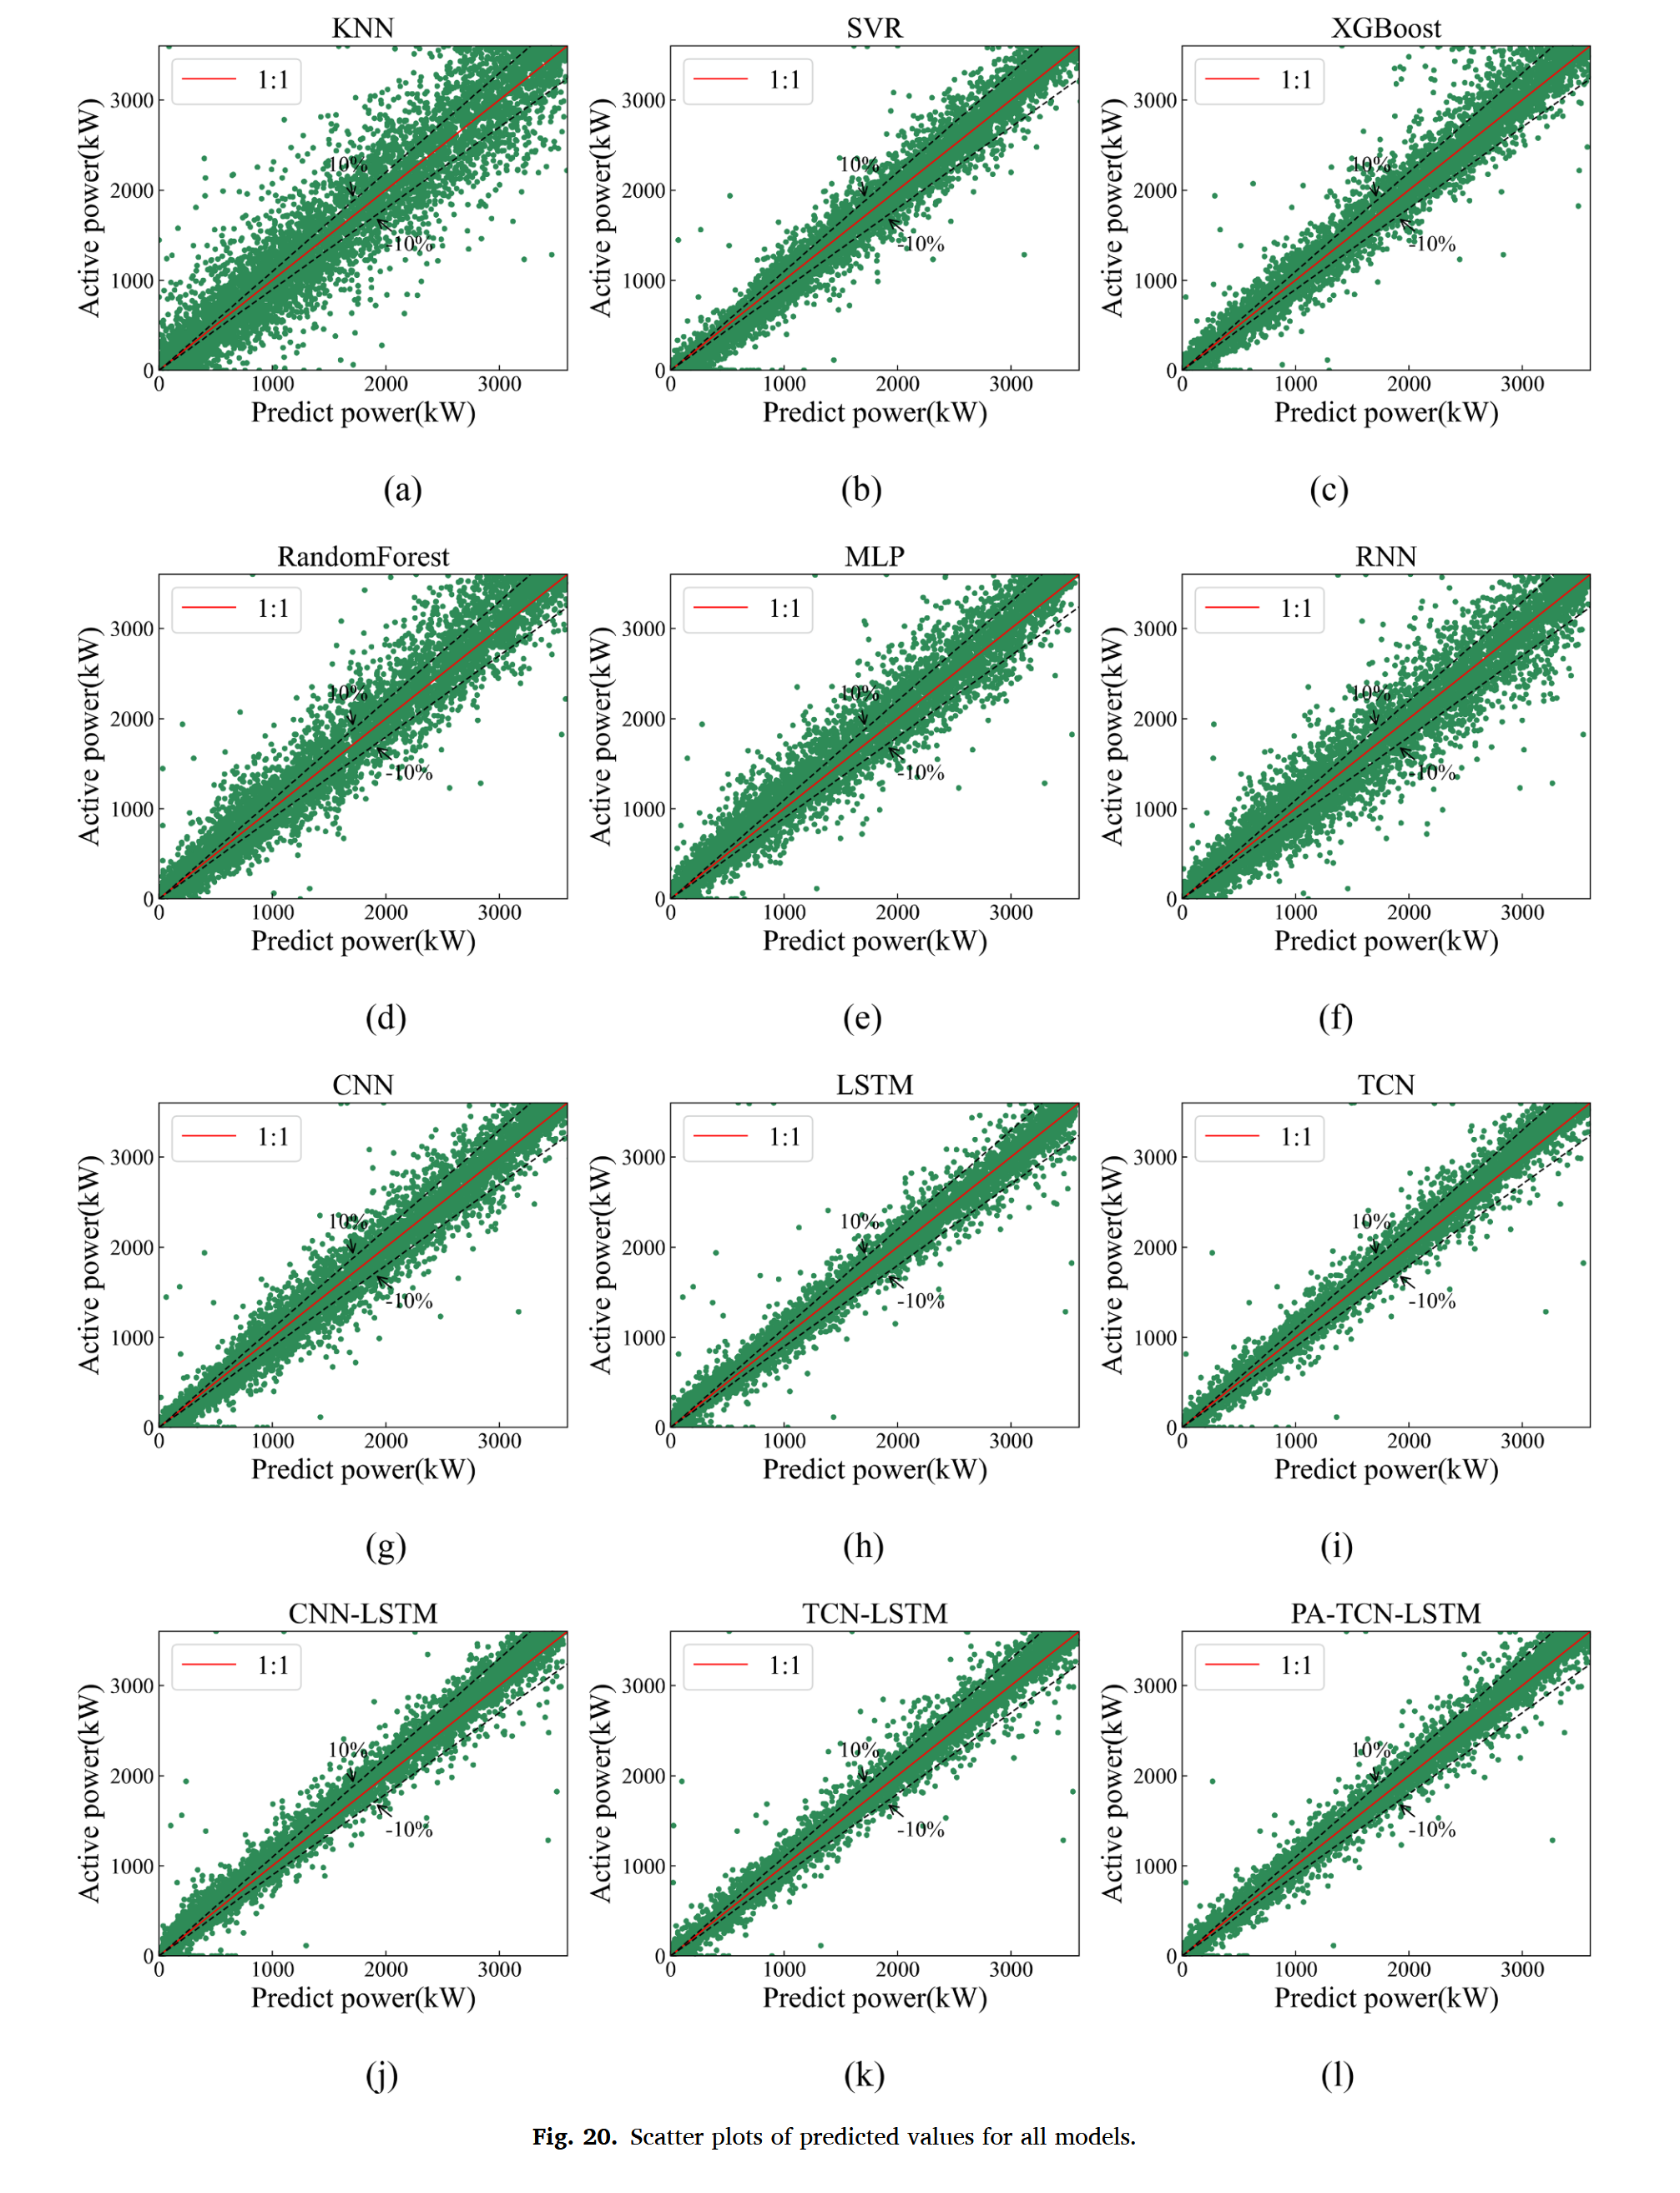
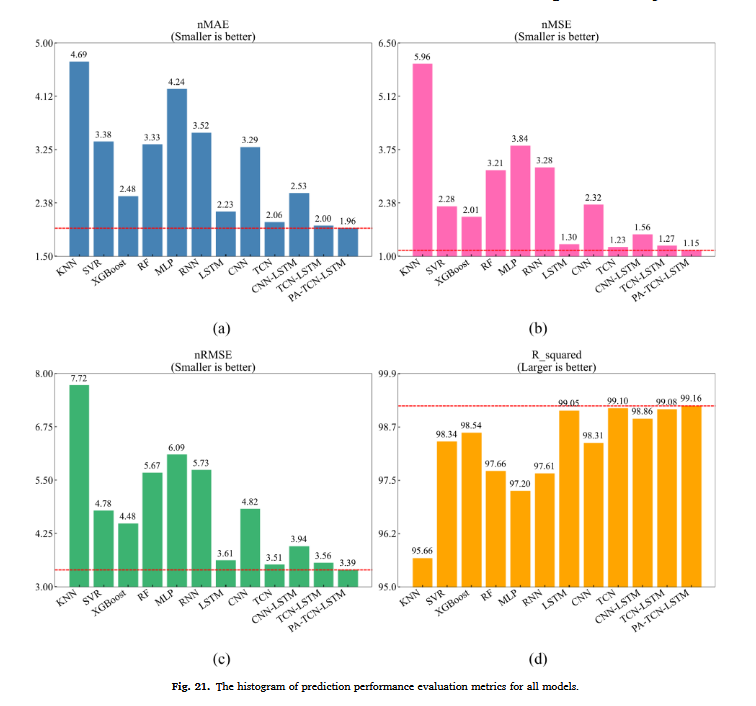
在预测性能方面,所提出模型优于所有单一模型。与四个单一机器学习模型(KNN、SVR、XGBoost、RF)相比,最大 nMAE 降幅为 58.26%,nMSE 最大降幅为 80.71%,nRMSE 最大降幅为 56.10%, R 2 R^2 R2 最大提升为 3.50%。与 MLP、RNN、LSTM、CNN、TCN 等单一深度学习模型相比,最大 nMAE 降幅为 53.83%,nMSE 降幅为 70.11%,nRMSE 降幅为 44.37%, R 2 R^2 R2 最大提升为 1.96%。
此外,所提出模型兼顾了在保持优异预测性能的同时,降低现有深度学习混合模型因高复杂度与高计算成本带来的低预测效率问题。与广泛应用的 CNN-LSTM 混合模型相比,所提出的 PA-CNN-LSTM 混合模型在 nMAE 上减少了 22.70%,nMSE 减少了 26.37%,nRMSE 降低了 14.09%,且预测精度更高。与参数设置一致的传统 TCN-LSTM 模型相比,训练参数数量减少了 15552(降低 6.59%),计算时间减少了 793.64 秒(降低 25.82%),nMAE 降低了 2.00%,nMSE 降低了 9.21%,nRMSE 降低了 4.74%,说明模型的预测性能得到进一步提升,预测效率更高。
从上述评估结果可以看出,本文提出的模型在整体性能上优于对比模型。然而,传统的预测误差评价指标(如 MAE、MSE)在实际应用中存在一定局限性 43,因此引入了现代评价标准------Diebold-Mariano 检验进行进一步验证。根据文献 44,以 MSE 为损失函数,设 S 0 S_0 S0 与 P 0 P_0 P0 分别为 Diebold-Mariano 检验的统计量与 P 值,置信度设为 95%。若 P 0 > 0.05 P_0 > 0.05 P0>0.05,表示差异不显著;若 P 0 < 0.05 P_0 < 0.05 P0<0.05 且 S 0 < 0 S_0 < 0 S0<0,则说明所提模型性能优于对比模型;否则,则为对比模型优越。表 9 给出了所提出模型与各对比模型之间的 Diebold-Mariano 检验统计值与 P 值。结果显示,所有实验中 S 0 S_0 S0 均为负值, P 0 P_0 P0 均小于 0.05,表明所提模型在所有对比实验中预测性能最优。
4. 结论
本文提出了一种基于 TCN-LSTM 并行架构并融合 SG 滤波器的全新混合深度学习模型。TCN 采用多层空洞因果卷积以提取时间序列的局部特征与长期依赖信息,而 LSTM 则利用门控单元实现对序列整体的全局建模;二者通过张量拼接模块构建并行结构,融合各自学习到的特征信息,以更充分地挖掘数据的时序关联性。在模型训练阶段,使用 SG 滤波器对风速时间序列进行降噪与平滑处理,使得数据的时间特征更加显著,降低模型特征学习的复杂度。基于土耳其某风电场风机的 SCADA 数据,进行了三组不同对比实验,从超参数优化与模型性能评估两个角度验证了模型的有效性与优越性,主要结论如下:
-
SG 滤波器能有效去除风速时间序列中的噪声、提升输入数据质量,并降低模型特征学习复杂度。在相同超参数配置下,使用 SG 滤波器后的数据作为输入与原始数据相比:TCN 模型的 nMAE、nMSE、nRMSE 分别下降 29.09%、51.18%、30.69%, R 2 R^2 R2 提升 1.55%;LSTM 分别下降 12.56%、23.65%、12.71%, R 2 R^2 R2 提升 0.72%;CNN-LSTM 分别下降 35.92%、59.15%、36.19%, R 2 R^2 R2 提升 1.85%;PA-CN-LSTM 分别下降 31.51%、57.70%、34.98%, R 2 R^2 R2 提升 1.67%。SG 滤波器的引入显著提升了模型预测性能。
-
多项超参数对所提混合模型性能有显著影响,包括 TCN 滤波器数量与大小、LSTM 单元数、LSTM 激活函数、训练批量大小及优化器。在参数配置为 TCN 滤波器数为 64、LSTM 单元数为 64、TCN 滤波器大小为 3、激活函数为 Tanh、批量大小为 32、优化器为 Adam 时,模型预测性能最优。
-
就预测性能而言,所提混合模型优于 KNN、SVR、XGBoost、RandomForest、MLP、RNN、LSTM、CNN、TCN 等九种单一模型。其中 nMAE 最大降低 58.26%(KNN),最小降低 4.82%(TCN);nMSE 最大降低 80.71%(KNN),最小降低 6.90%(TCN);nRMSE 最大降低 56.10%(KNN),最小降低 3.51%(TCN); R 2 R^2 R2 最大提升 3.50%(KNN),最小提升 0.06%(TCN)。
-
与常用 CNN-LSTM 混合模型相比,PA-TCN-LSTM 的 nMAE、nMSE、nRMSE 分别降低 22.70%、26.37%、14.09%;与超参数相同的传统 TCN-LSTM 模型相比,训练参数减少 6.59%、计算时间减少 25.82%、nMAE 降低 2.00%、nMSE 降低 9.21%、nRMSE 降低 4.74%。在维持良好预测精度的同时,所提模型具有更低的复杂度与计算成本,以及更高的预测效率。
-
在 PA-TCN-LSTM 与各对比模型的 Diebold-Mariano 检验中,统计值 S 0 S_0 S0 均为负,P 值 P 0 P_0 P0 均小于 0.05,最大 S 0 S_0 S0 为 -2.2299,最大 P 0 P_0 P0 为 2.5749 × 1 0 − 2 2.5749 \times 10^{-2} 2.5749×10⁻²,进一步验证了所提模型的卓越预测性能。
尽管本文所构建的 TCN-LSTM 并行混合模型在风电预测方面表现优异,但所使用的数据特征较少,仅包含风速、风向与输出功率。未来将引入更丰富特征与更大体量的数据集,进一步验证模型在特征信息提取方面的能力。同时,所提并行架构基于张量拼接模块构建,未来可拓展更多模型融合,提高模型泛化能力与预测准确性。