Apache Hive作为Hadoop生态系统中的重要组件,为大数据分析提供了强大的SQL-like查询能力。Hive不仅支持丰富的内置函数,还允许用户开发自定义函数(UDF)以满足特定需求。本文将深入探讨Hive的内置函数(包括数学函数、字符串函数、日期函数)的使用方法,并详细介绍如何开发与注册自定义UDF(Java/Python),同时通过流程图和架构图帮助读者更好地理解其工作原理。
1 Hive内置函数
Hive内置函数是Hive提供的一系列预定义函数,用于处理数据查询中的常见操作。这些函数可以分为以下几类:
1.1 数学函数
数学函数用于对数值型数据进行计算。以下是一些常用的数学函数:
- ABS(x):返回x的绝对值
- ROUND(x, d):将x四舍五入到d位小数
-
POW(x, y):返回x的y次方
-
示例:
SELECT ABS(-10), ROUND(3.14159, 2), POW(2, 3);
1.2 字符串函数
字符串函数用于处理文本数据。以下是一些常用的字符串函数:
- CONCAT(str1, str2):将str1和str2连接起来
- SUBSTR(str, start, length):从str中提取子字符串
-
LOWER(str):将str转换为小写
-
示例:
SELECT CONCAT('Hello', 'World'), SUBSTR('HelloWorld', 6, 5), LOWER('HelloWorld');
1.3 日期函数
日期函数用于处理日期和时间数据。以下是一些常用的日期函数:
- CURRENT_DATE():返回当前日期
- DATE_ADD(date, days):在date上增加指定天数
-
DATEDIFF(date1, date2):返回date1和date2之间的天数差
-
示例:
SELECT CURRENT_DATE(), DATE_ADD('2023-10-01', 7), DATEDIFF('2023-10-01', '2023-09-01');
1.4 Hive内置函数的执行流程
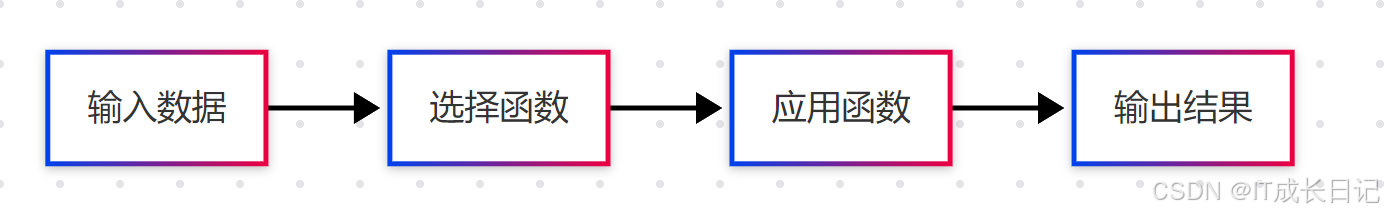
- 输入数据:从表或查询中获取数据
- 选择函数:根据需求选择合适的Hive内置函数
- 应用函数:对输入数据应用函数进行计算或转换
- 输出结果:返回函数处理后的结果
2 自定义UDF开发与注册
当Hive内置函数无法满足需求时,可以通过开发自定义函数(UDF)来实现特定功能。UDF支持多种编程语言开发,如Java和Python。
2.1 Java UDF开发
以下是开发Java UDF的步骤:
- 创建Java类 :继承org.apache.hadoop.hive.ql.exec.UDF类,并实现evaluate方法
- 打包JAR文件:将Java类打包为JAR文件
-
注册UDF:在Hive中注册JAR文件并创建函数
-
示例:
import org.apache.hadoop.hive.ql.exec.UDF;
import org.apache.hadoop.io.Text;public class ToUpperUDF extends UDF {
public Text evaluate(Text input) {
if (input == null) return null;
return new Text(input.toString().toUpperCase());
}
} -
注册UDF:
ADD JAR /path/udf.jar;
CREATE TEMPORARY FUNCTION to_upper AS 'com.example.ToUpperUDF';
2.2 Python UDF开发
以下是开发Python UDF的步骤:
- 编写Python脚本:实现自定义逻辑
-
注册UDF:在Hive中注册Python脚本并创建函数
-
示例:
def to_upper(s):
return s.upper() -
注册UDF:
ADD FILE /path/udf.py;
CREATE TEMPORARY FUNCTION to_upper AS 'to_upper' USING PYTHON;
2.3 UDF的开发与注册流程

- 编写UDF代码:使用Java或Python实现自定义逻辑
- 打包为JAR或Python文件:将代码打包为可执行文件
- 上传文件到Hive:将文件上传到Hive的分布式文件系统
- 注册UDF:在Hive中注册文件并创建函数
- 在查询中使用UDF:在SQL查询中调用自定义函数
3 案例:使用UDF处理数据
假设我们需要将表中的所有字符串字段转换为大写,可以使用以下步骤:
- 开发UDF :编写Java或Python代码实现to_upper函数。
- 注册UDF:在Hive中注册函数。
-
应用UDF:在查询中使用函数。
-
示例查询:
SELECT to_upper(name) FROM employees;
4 总结
Hive内置函数为常见的数据处理任务提供了强大的支持,而自定义UDF则进一步扩展了Hive的功能。在实际项目中,合理使用内置函数和UDF可以显著提高数据处理的效率和灵活性。