🔥个人主页: 中草药
🔥专栏:【中间件】企业级中间件剖析
一、哨兵机制
Redis的主从复制模式下,一旦主节点由于故障不能提供服务,需要人工的进行主从切换,同时需要大量的客户端需要被通知切换到了新的主节点之上,不适用于大规模的应用,因此这里用到了哨兵机制
基本概念
Redis的哨兵(Sentinel)机制是一种高可用性解决方案,旨在自动管理 主从复制 架构中的故障恢复。
| 名词 | 逻辑结构 | 物理结构 |
|---|---|---|
| 主节点 | Redis 主服务 | 一个独立的 redis-server 进程 |
| 从节点 | Redis 从服务 | 一个独立的 redis-server 进程 |
| Redis 数据节点 | 主从节点 | 主节点和从节点的进程 |
| 哨兵节点 | 监控 Redis 数据节点的节点 | 一个独立的 redis-sentinel 进程 |
| 哨兵节点集合 | 若干哨兵节点的抽象组合 | 若干 redis-sentinel 进程 |
| Redis 哨兵(Sentinel) | Redis 提供的高可用方案 | 哨兵节点集合 和 Redis 主从节点 |
| 应用方 | 泛指一个多多个客户端 | 一个或多个连接 Redis 的进程 |
哨兵模式的配置文件
sentinel.conf
bash
sentinel monitor 主节点名 主节点ip 主节点端口 法定票数
bash
bind 0.0.0.0
port 26379
sentinel monitor redis-master redis-master 6379 2
sentinel down-after-milliseconds redis-master 1000
法定票数涉及到后续的主观下线到客观下线
核心流程
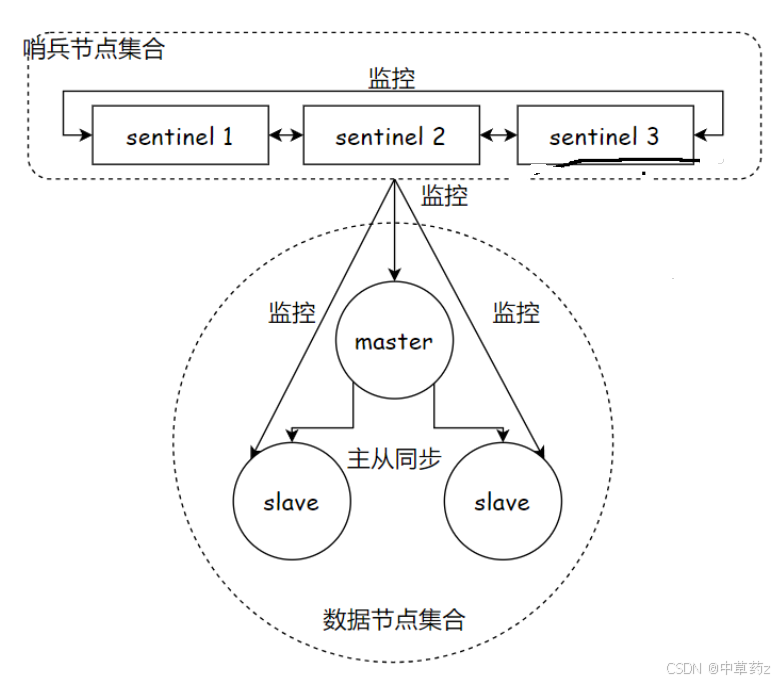
监控
哨兵节点会以一定的频率向 Redis 集群中的所有主节点和从节点发送 PING 命令(心跳包),通过节点的响应来判断节点是否正常运行。每个哨兵节点都会维护一个关于主节点和从节点的状态信息列表,记录节点的存活状态、角色、连接信息等。
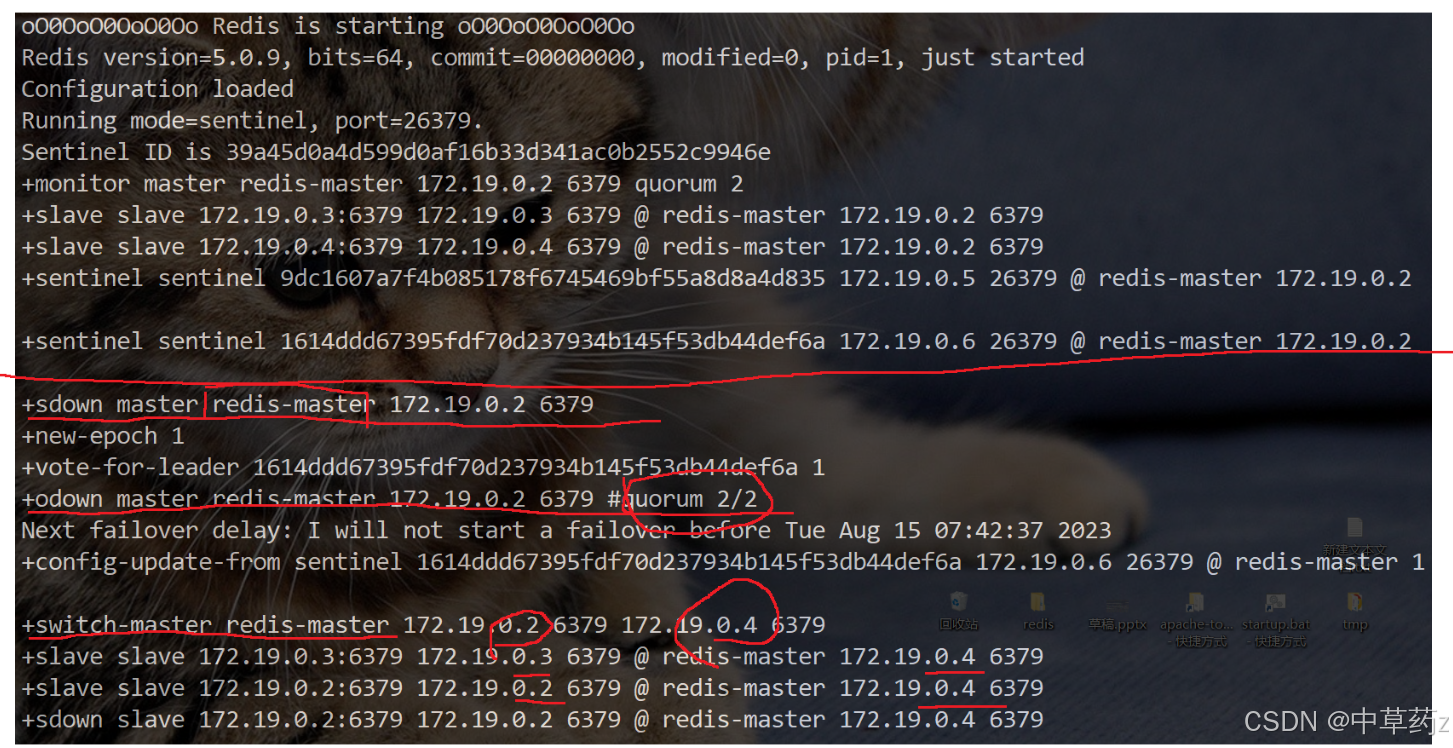
例如,当一个哨兵节点向主节点发送 PING 命令后,如果在规定的时间内(通常称为 down-after-milliseconds)没有收到响应,哨兵节点就会将该主节点标记为 "主观下线"(Subjectively Down,简称 SDOWN),即认为该节点可能出现了故障。
主观下线和客观下线
"主观下线" 只是单个哨兵节点的判断,为了避免误判,哨兵机制引入了 "客观下线"(Objectively Down,简称 ODOWN)的概念。当一个哨兵节点将主节点标记为 SDOWN 后,它会向其他哨兵节点发送 SENTINEL is-master-down-by-addr 命令,告知其他哨兵自己对该主节点的判断。当有足够数量(超过配置的 quorum 值)的哨兵节点都认为该主节点处于 SDOWN 状态时,这个主节点就会被标记为 ODOWN,即被认为是真正的故障。
例如,假设集群中有 5 个哨兵节点,quorum 设置为 3。当其中一个哨兵节点发现主节点无响应并标记其为 SDOWN 后,它会向其他 4 个哨兵节点发送通知。如果有另外 2 个哨兵节点也认为该主节点 SDOWN,此时满足 quorum 条件,主节点就会被判定为 ODOWN,进入故障转移流程。
故障转移和通知
一旦主节点被判定为 ODOWN,哨兵机制就会触发故障转移流程。具体步骤如下:
*1)选举领头哨兵:在所有哨兵节点中,通过 Raft 算法选举出一个领头哨兵(Leader Sentinel),由它来负责执行故障转移操作。选举过程中,每个哨兵节点都会向其他节点发送投票请求,获得超过半数投票的哨兵节点将成为领头哨兵。
*2)选择新主节点:领头哨兵从当前存活的从节点列表中,按照一定的规则选择一个从节点作为新的主节点。选择规则通常基于从节点的优先级(slave-priority 配置项,数值越小优先级越高)、复制偏移量(优先选择复制偏移量最大,即数据最完整的从节点)以及运行 ID(随机选择)。
3)提升新主节点:领头哨兵向选中的从节点发送 SLAVEOF no one 命令,将其提升为新的主节点。此时,新主节点开始接受客户端的写入请求。
4)重新配置其他从节点:领头哨兵向其他从节点发送 SLAVEOF 命令,让它们指向新的主节点,开始从新主节点进行数据复制。
5)通知客户端:领头哨兵通过发布与订阅机制,向所有连接到 Redis 集群的客户端发送新主节点的地址信息,以便客户端能够重新连接到新的主节点。
注意
1)哨兵节点数量不能为单一,避免其故障影响系统可用性。
2)哨兵节点宜为奇数个,利于选举 leader 。
3)哨兵节点不承担数据存储任务,由 Redis 主从节点负责存储。
4)哨兵 + 主从复制可提高系统可用性,但无法解决极端情况下数据写丢失问题 。
5)哨兵 + 主从复制不能提升数据存储容量,面对接近或超 机器物理内存的数据量时存在局限。
二、集群Cluster
这里的集群指的是实现的是拓展内存空间
Redis Cluster 是 Redis 官方提供的分布式解决方案,旨在解决单机 Redis 的性能瓶颈、数据容量限制和高可用性问题,他通过引入多组的Master/Slave,每一组的Master/Slave存储数据全量的一部分,从而构成一个更大的整体,称为Redis集群(Cluster).
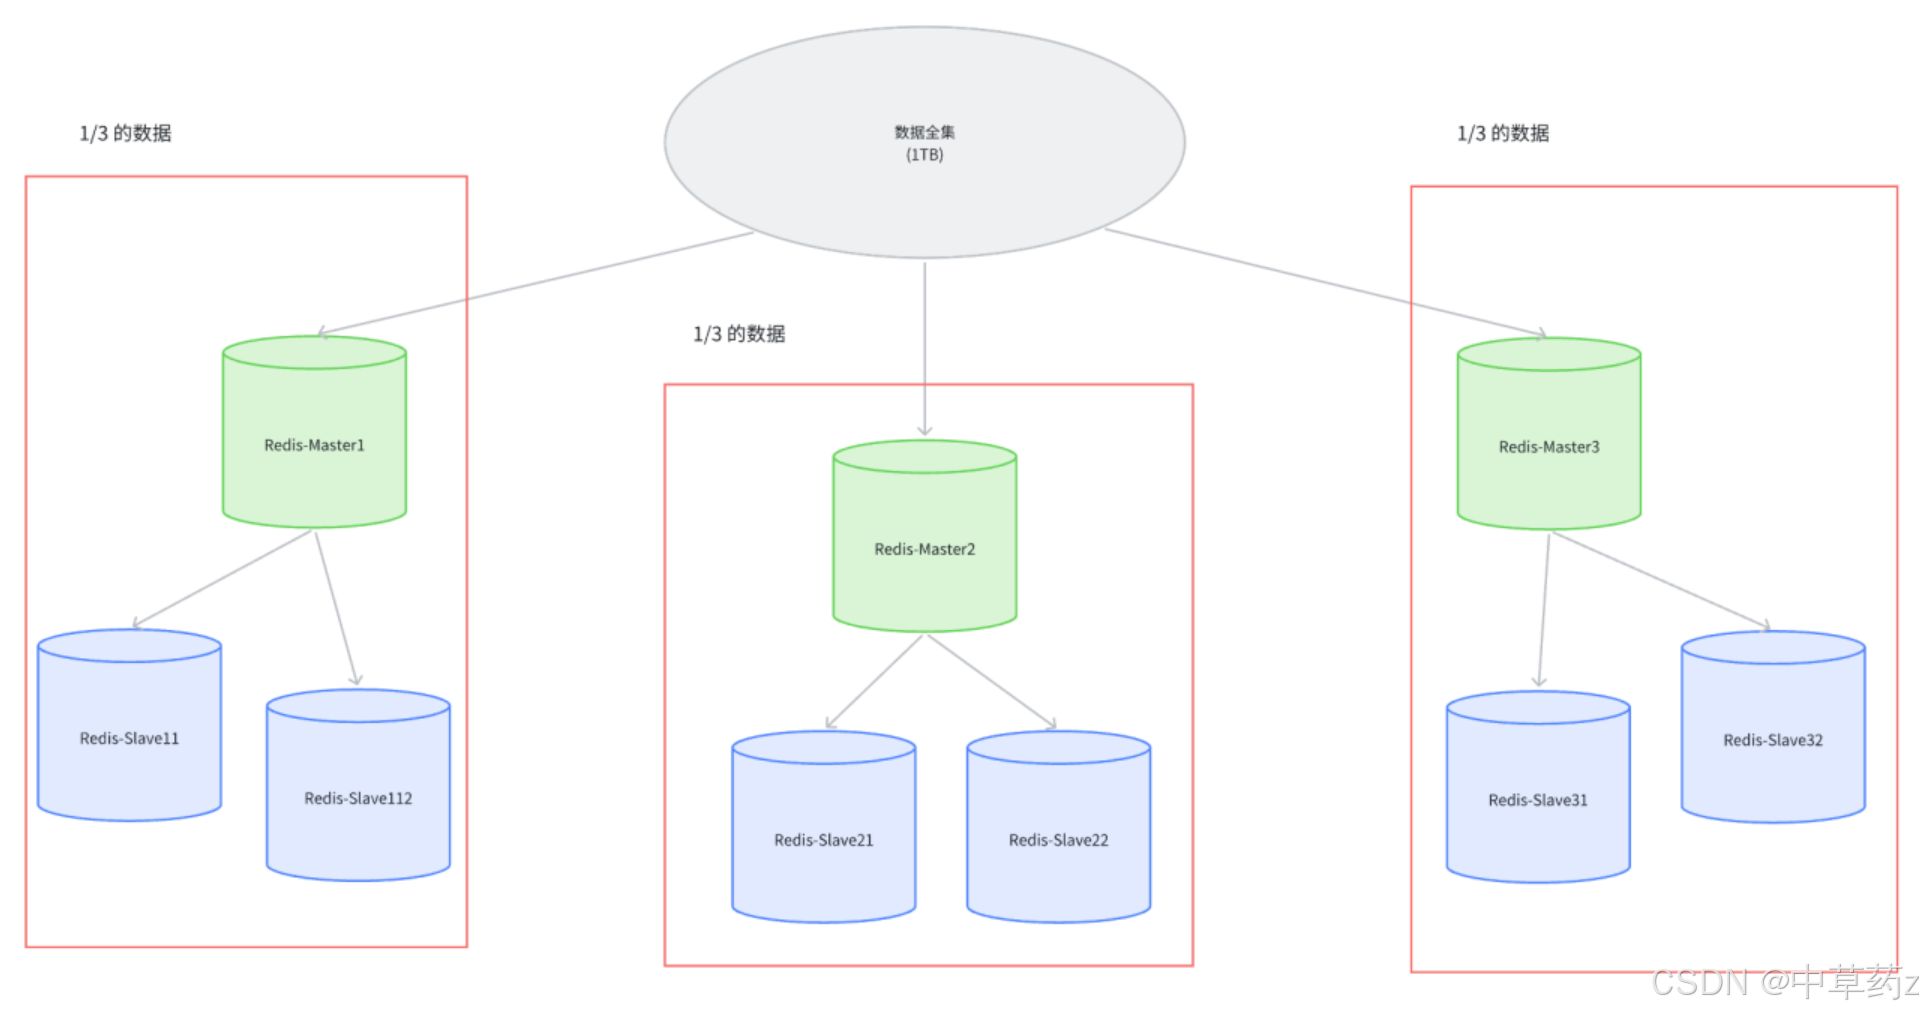
每一个红框部分被称为是一个分片(Sharding)
数据分片算法
1、哈希求余算法
也叫除法取余哈希 ,是一种简单的哈希算法。将输入数据Key(比如使用Md5算法)通过除法运算后取余数,得到特定范围内的哈希值。比如对于整数,用整数除以N取余,余数就是哈希值。
MD5算法是广泛使用的哈希算法,他的主要特点有:
1、计算的结果是定长的
可处理任意长度数据,输出始终是 128 位二进制数(转换为十六进制是 32 个字符 )。
2、计算结果是发散的
两个字符串即使只有细小差别,计算出的结果差别也是很大
2、计算结果不可逆
在一些哈希表实现中,先计算键值的 hashCode 值,再对数组长度取余(有时用位运算实现 ),得到的余数作为存储下标 。例如有数据 [10, 20, 30] ,设定除数为 7 ,则 10 % 7 = 3 、20 % 7 = 6 、30 % 7 = 2 ,3、6、2 就是对应哈希值。
优点:简单高效,数据分配均匀
缺点 :一旦需要扩容,N改变了,原有的映射规则改变,需要让节点之间的数据相互传输,重新排列,满足新的映射规则,此时需要搬运的数据量是比较大的,开销较大
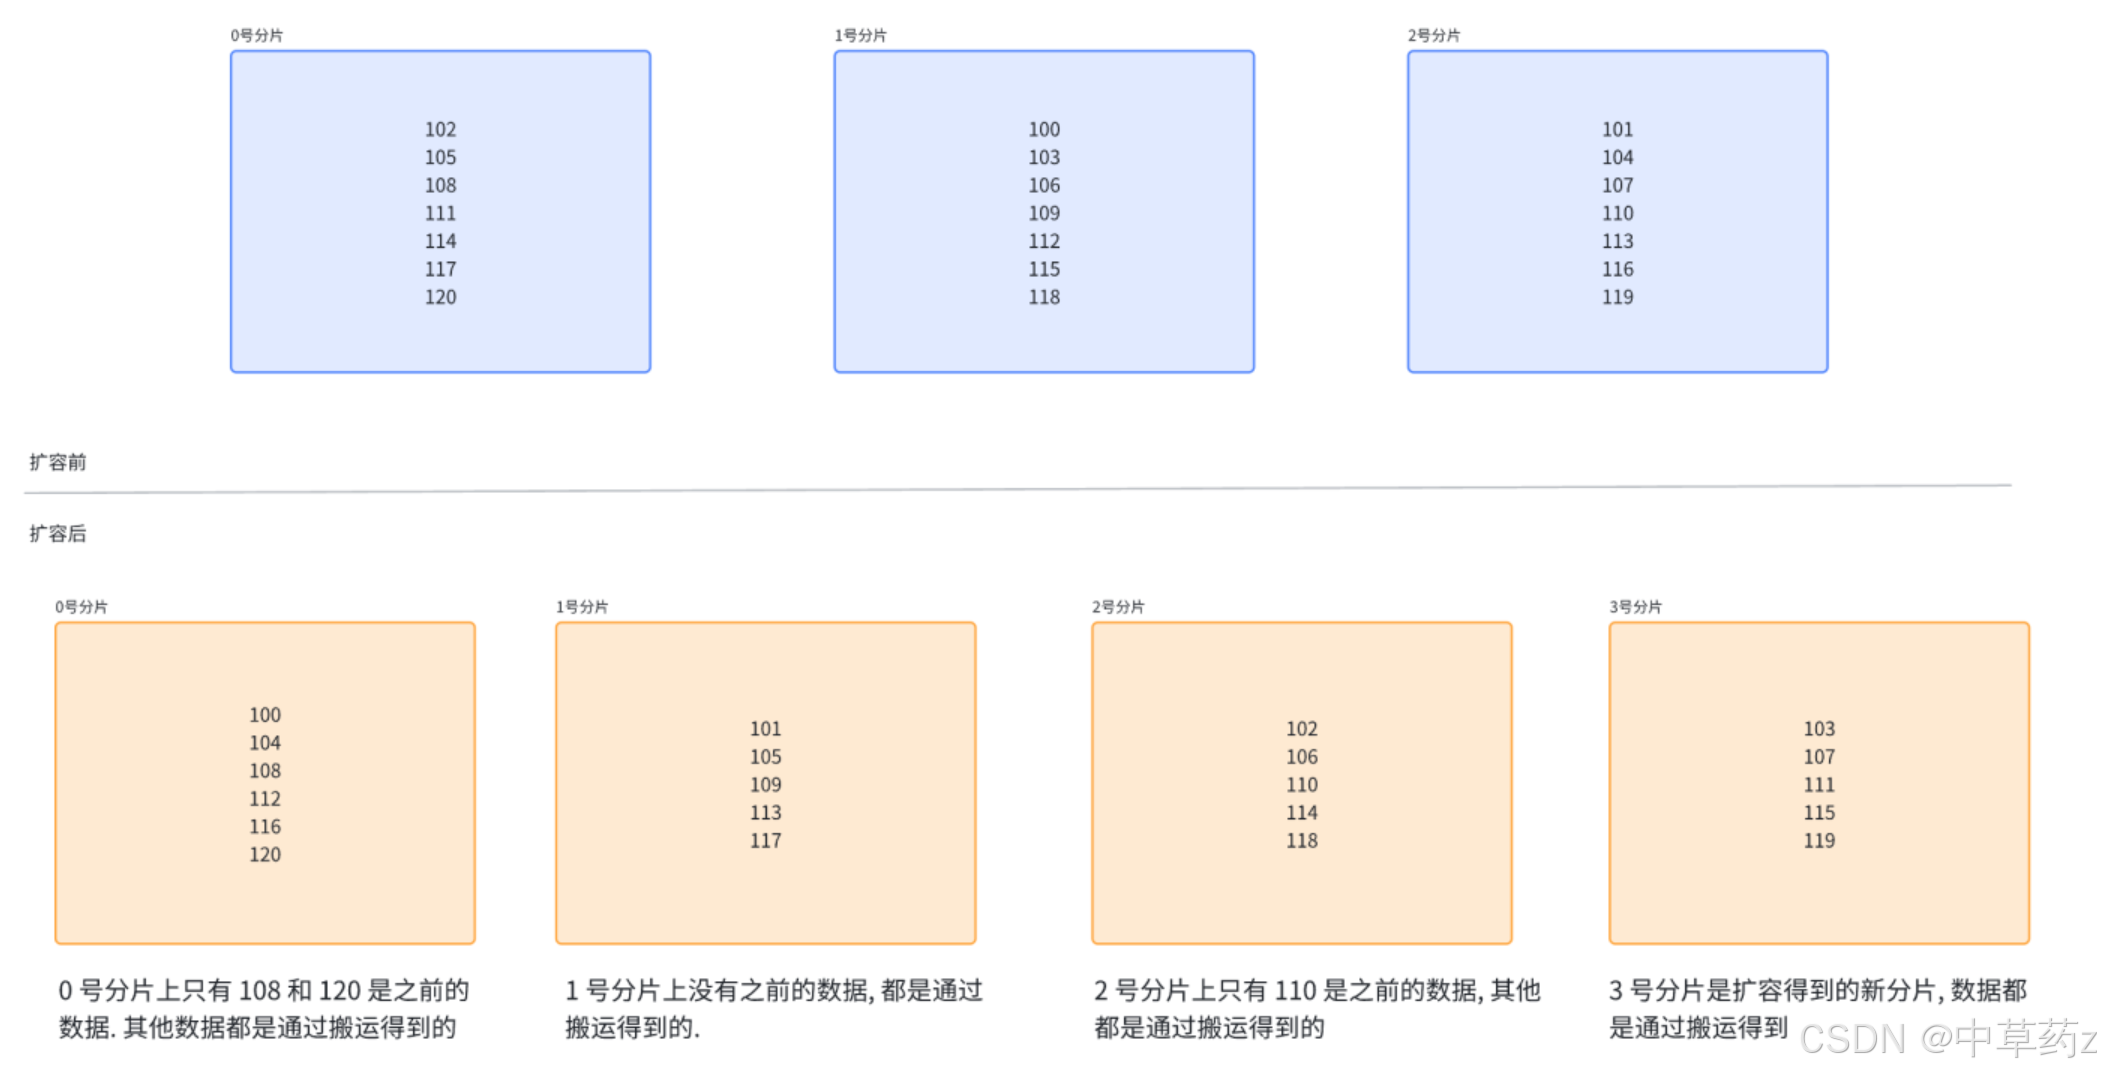
如上图一共有21个key,仅仅只有3个key是没有经过搬运的
2、一致性哈希算法
构建一个逻辑上的环形结构,是 0 到 2^32-1(或其他取值范围 )的哈希值空间,数据按照顺时针方向增长。每个节点(物理节点或虚拟节点 )通过哈希算法映射到环上某个位置 。
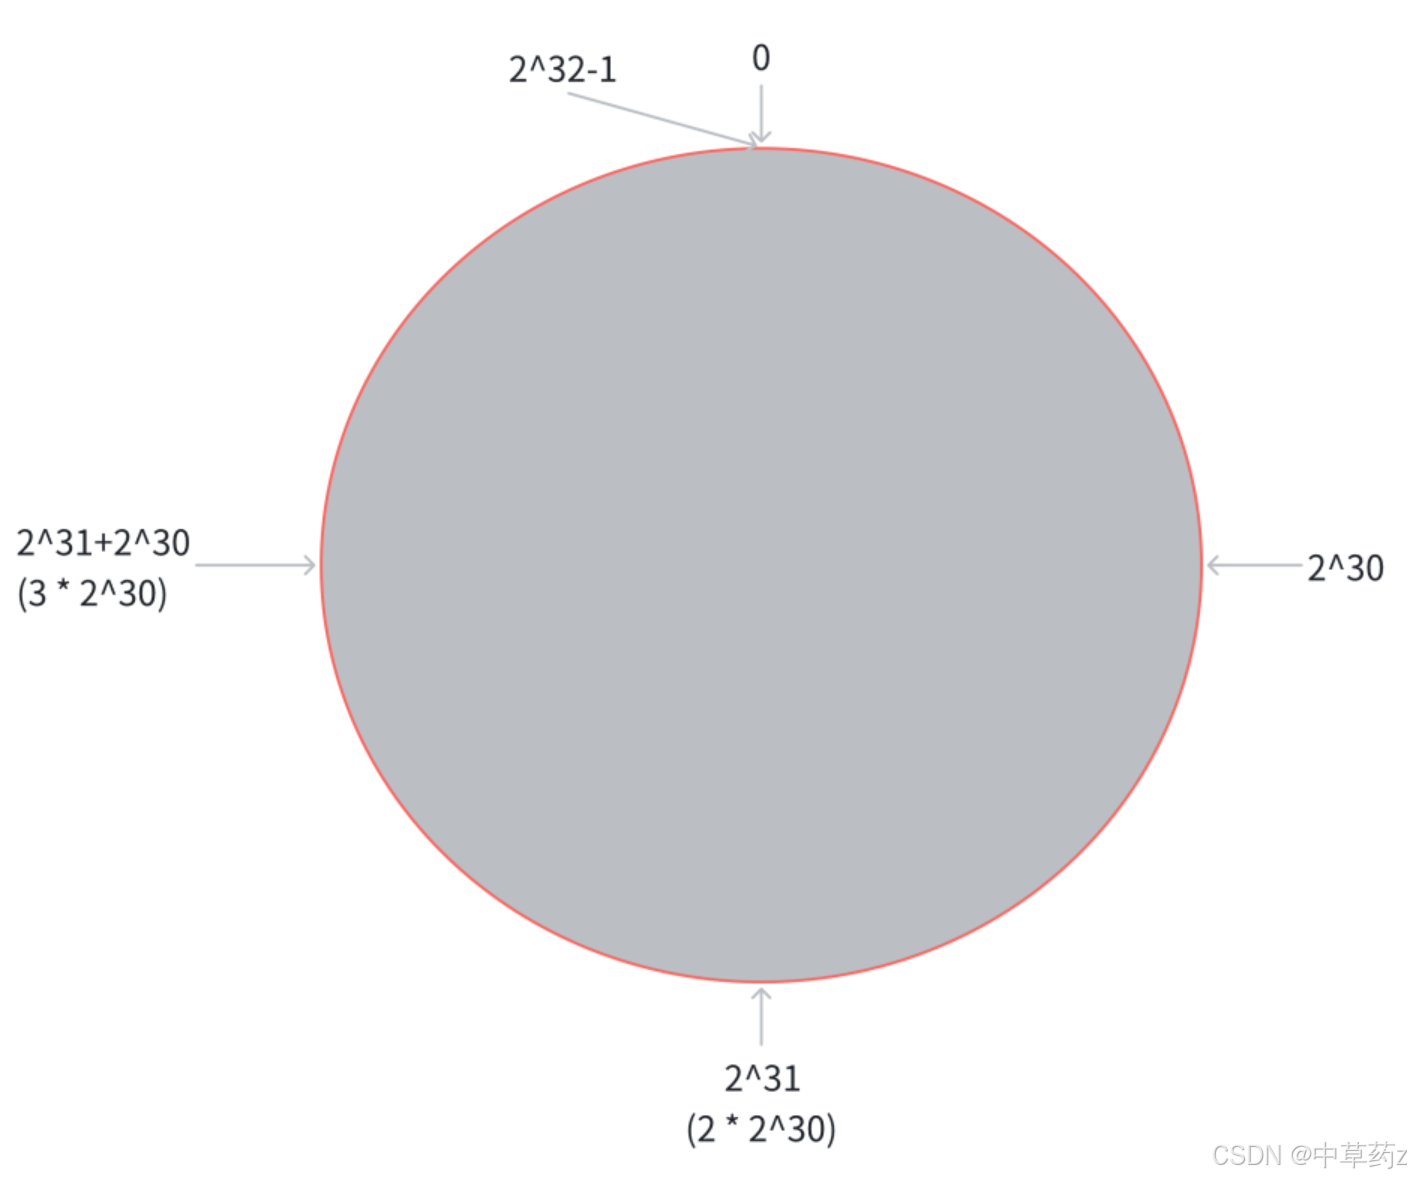
数据经哈希算法映射到环上位置,存储在顺时针方向第一个遇到的节点上 。比如有服务器节点 A、B、C 映射在环上,数据 D 经哈希后落在环上某点,按顺时针找,第一个遇到节点 B,D 就存储在 B 。
优点:大大降低了扩容时数据搬运的规模,提高了扩容操作的效率
缺点 :会出现数据分配不均匀,即数据倾斜
3、哈希槽分区算法(Redis使用)
集群通过哈希槽(Hash Slot)实现数据分片,共 16384 个哈希槽。键经 CRC16 算法计算哈希值并对 16384 取模,确定所属哈希槽,哈希槽分配到不同主节点 ,每个主节点管理部分哈希槽及对应数据。
hash_slot = crc16(key) % 16384其中 crc16 也是一种hash算法
16384实际上就是16*1024 也就是 2^14
该算法的本质相当于是哈希求余和一致性哈希的一种结合,解决了数据倾斜和数据搬运成本高的问题
这里的分片规则是很灵活的.每个分片持有的槽位也不一定连续.。
每个分片的节点使用 位图 来表示自己持有哪些槽位.对于16384个槽位来说,需要2048个字节(2KB)大小的内存空间表示.
常见问题
1、Redis集群最多有16384个分片吗
如果一个分片一个槽位的话反而会出现数据分布不均匀的情况,实际上Redis作者建议集群分布数不应该超过1000
2、为什么是16384个槽位
官方回答:github.com
翻译过来大概意思是:
节点之间通过心跳包通信。心跳包中包含了该节点持有哪些 slots. 这个是使用位图这样的数据结构表示的。表示 16384 (16k) 个 slots, 需要的位图大小是 2KB. 如果给定的 slots 数更多了,比如 65536 个了,此时就需要消耗更多的空间,8 KB 位图表示了.。8 KB, 对于内存来说不算什么,但是在频繁的网络心跳包中,还是一个不小的开销.
另一方面,Redis 集群一般不建议超过 1000 个分片。所以 16k 对于最大 1000 个分片来说是足够用的,同时也会使对应的槽位配置位图体积不至于很大.
故障处理
主节点宕机
我们可以在docker中模拟建造一个集群关系
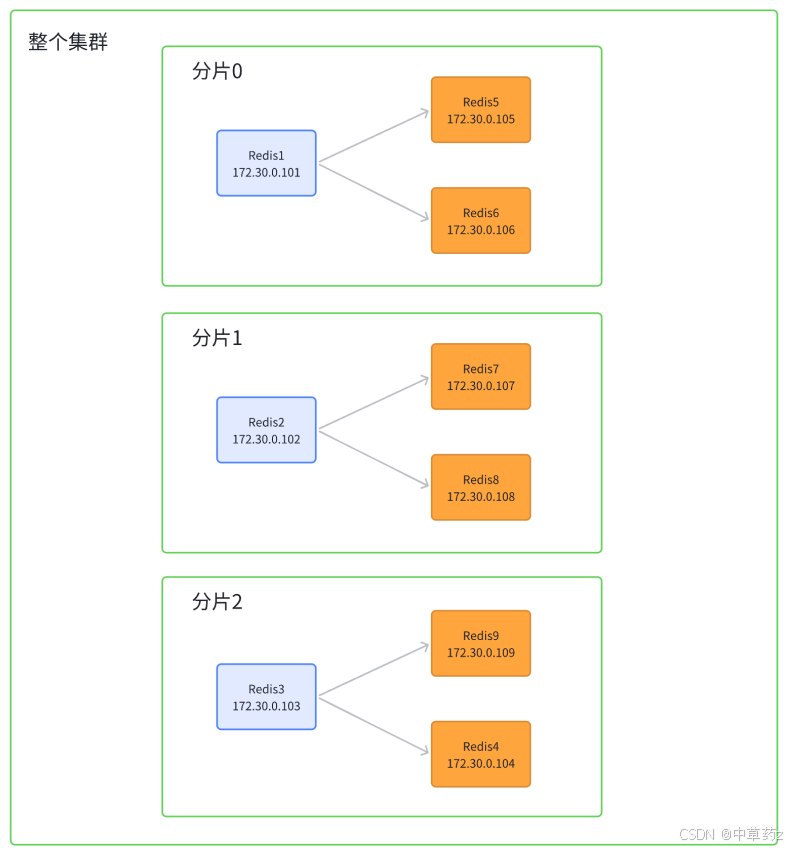
在上述的集群关系之中挑一个随便停掉
docker stop redis1连上redis2
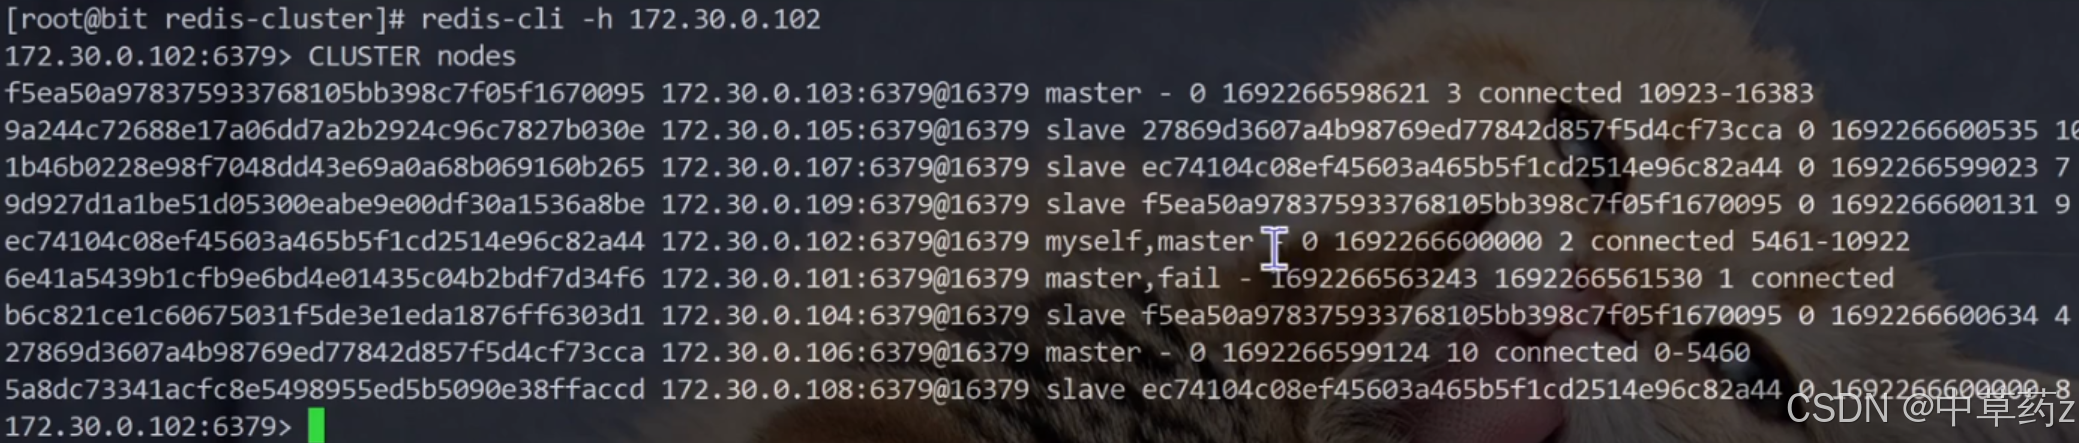
可以看到ip地址101的节点已经提示fail,然后原本是从节点的105成了新的主节点
此时重新启动redis1
bash
docker start redis1再进行观察
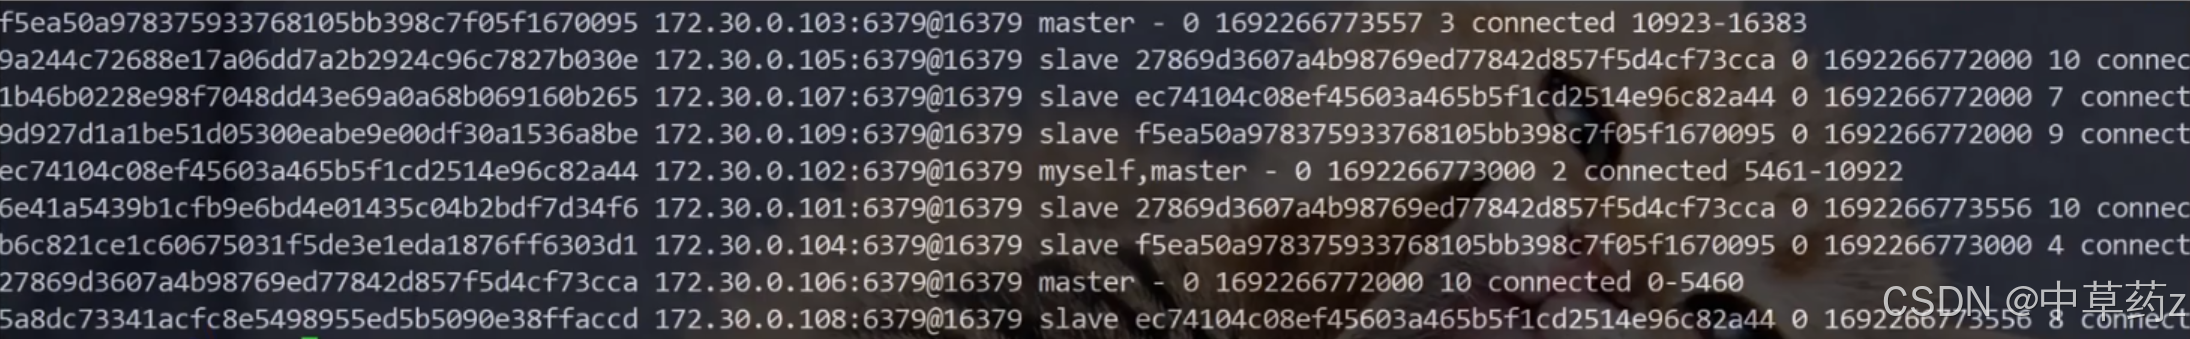
此时的101重新加入到集群之中但是是作为从节点
可以登陆到101客户端执行cluster failover进行集群恢复,也就是把101重新设为master
处理流程
故障判定
集群中的所有节点,都会周期性的使用心跳包进行通信.
1)节点 A 给节点 B 发送 ping 包,B 就会给 A 返回一个 pong 包. ping 和 pong 除了 message type 属性之外,其他部分都是一样的。这里包含了集群的配置信息 (该节点的 id, 该节点从属于哪个分片,是主节点还是从节点,从属于谁,持有哪些 slots 的位图...).
2)每个节点,每秒钟,都会给一些随机的节点发起 ping 包,而不是全发一遍。这样设定是为了避免在节点很多的时候,心跳包也非常多 (比如有 9 个节点,如果全发,就是 9 * 8 有 72 组心跳了,而且这是按照 N^2 这样的级别增长的).
3)当节点 A 给节点 B 发起 ping 包,B 不能如期回应的时候,此时 A 就会尝试重置和 B 的 tcp 连接,看能否连接成功。如果仍然连接失败,A 就会把 B 设为 PFAIL 状态 (相当于主观下线).
4)A 判定 B 为 PFAIL 之后,会通过 redis 内置的 Gossip 协议,和其他节点进行沟通,向其他节点确认 B 的状态. (每个节点都会维护一个自己的 "下线列表", 由于视角不同,每个节点的下线列表也不一定相同).
5)此时 A 发现其他很多节点,也认为 B 为 PFAIL, 并且数目超过总集群个数的一半 ,那么 A 就会把 B 标记成 FAIL (相当于客观下线), 并且把这个消息同步给其他节点 (其他节点收到之后,也会把 B 标记成 FAIL).
至此,B 就彻底被判定为故障节点了.
某个或者某些节点宕机,有的时候会引起整个集群都宕机 (称为 fail 状态).
以下三种情况会出现集群宕机:
- 某个分片,所有的主节点和从节点都挂了,该分片无法提供服务
- 某个分片,主节点挂了,但是没有从节点.
- 超过半数的 master 节点都挂了.
核心原则是保证每个slots都能够正常工作
故障迁移
上述例子中,B 故障,并且 A 把 B FAIL 的消息告知集群中的其他节点.
- 如果 B 是从节点,那么不需要进行故障迁移.
- 如果 B 是主节点,那么就会由 B 的从节点 (比如 C 和 D) 触发故障迁移了.
所谓故障迁移,就是指把从节点提拔成主节点 ,继续给整个 redis 集群提供支持.
具体流程如下:
1)从节点判定自己是否具有参选资格。如果从节点和主节点已经太久没通信 (此时认为从节点的数据和主节点差异太大了), 时间超过阈值,就失去竞选资格.
2)具有资格的节点,比如 C 和 D, 就会先休眠一定时间。休眠时间 = 500ms 基础时间 + 0,500ms 随机时间 + 排名 * 1000ms.offset 的值越大,则排名越靠前 (越小).
3)比如 C 的休眠时间到了,C 就会给其他所有集群中的节点,进行拉票操作。但是只有主节点才有投票资格.
4)主节点就会把自己的票投给 C (每个主节点只有 1 票). 当 C 收到的票数超过主节点数目的一半,C 就会晋升成主节点.(C 自己负责执行 slaveof no one, 并且让 D 执行 slaveof C).
5)同时,C 还会把自己成为主节点的消息,同步给其他集群的节点。大家也都会更新自己保存的集群结构
集群扩容
集群扩容本身是一件风险较高,成本比较大的操作
1)把新的主节点加入到集群
bash
redis-cli --cluster add-node 172.30.0.110:6379 172.30.0.101:6379前一个ip是被新增的节点,后一个ip表示集群上的任意一个节点
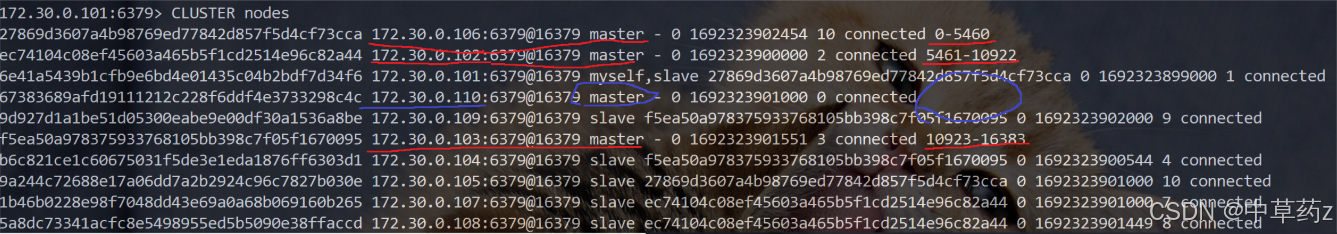
此时可以注意到该节点已被加入到集群但是还未分配slots
2)重新分配slots
bash
redis-cli --cluster reshard 172.30.0.101:6379reshard 后的地址是集群中的任意节点地址.
另外,注意单词拼写,是 reshard (重新切分), 不是 reshared (重新分享), 不要多写个 e
此时会询问多少个slots要进行shard
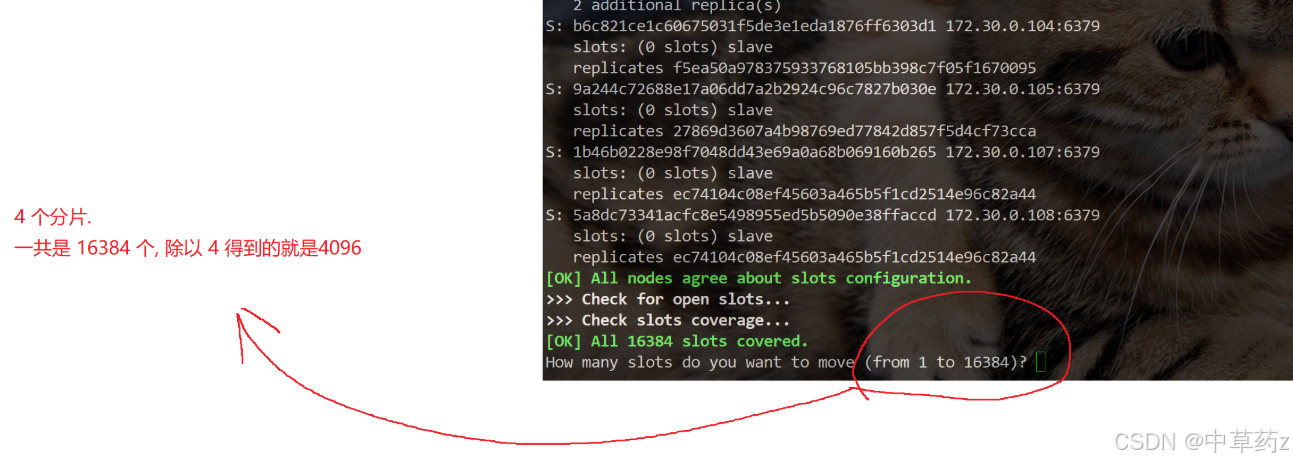
那些节点来接受这些slots,此处应该是我们新加入的节点
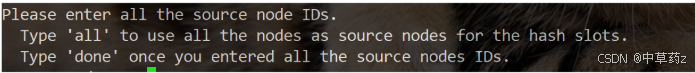
这些节点从哪里搬过来

all, 表示从其他每个持有 slots 的 master 都拿过来点.
手动指定,从某一个或者某几个节点来移动 slots (以 done 为结尾)
之后会先给出搬运的计划,并未实施真正的搬运操作,当输入yes之后,才会开始真正的搬运过程,不仅仅是slots的重新分配,也是数据的搬移,因此是一个比较重量的操作

3)为该主节点添加新的从节点
redis-cli --cluster add-node 172.30.0.111:6379 172.30.0.101:6379 --cluster-slave --cluster-master-id 172.30.1.110 节点的 nodeId
此时集群扩容才算是真正完成
在搬运slots/数据的时候,客户端能否正常访问集群?
大部分未搬运的 key 对应的业务可以正常访问。例如客户端访问某 key,经集群分片算法判定该 key 所在分片未进行相关数据搬运,就能正常重定向到对应节点并操作 。
而针对需要进行搬运的key会存在访问错误的情况,若客户端访问的 key 正好处于搬运过程中,比如已从原节点搬走但还未完全在新节点就绪,此时访问会失败 。例如客户端请求某 key,集群按算法重定向到对应节点,却发现该 key 已被迁移走,就无法正常响应 。
因此,针对生产环境的扩容,可以在流量小的情况下进行,把损失降到最低。
很明显,要想追求更高的可用性,让扩容对于用户影响更小,就需要搞一组新的机器,重新搭建集群,并且把数据导入过来,使用新集群代替旧日集群.(成本最高的)。
自信与骄傲有异:信者常沉着,而骄傲者常浮扬。 ------梁启超
🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀🍀
以上,就是本期的全部内容啦,若有错误疏忽希望各位大佬及时指出💐
制作不易,希望能对各位提供微小的帮助,可否留下你免费的赞呢🌸