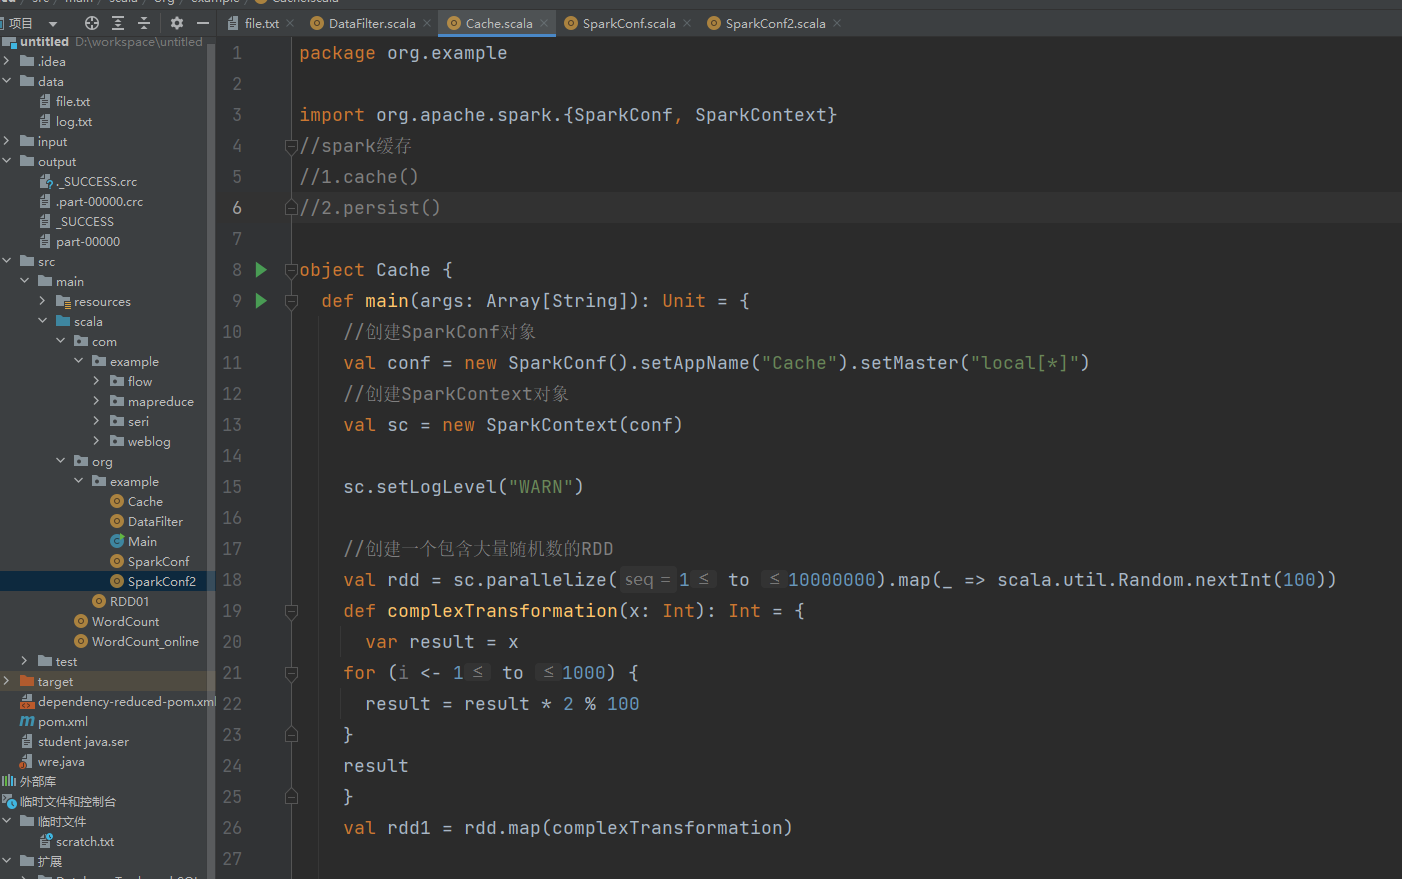
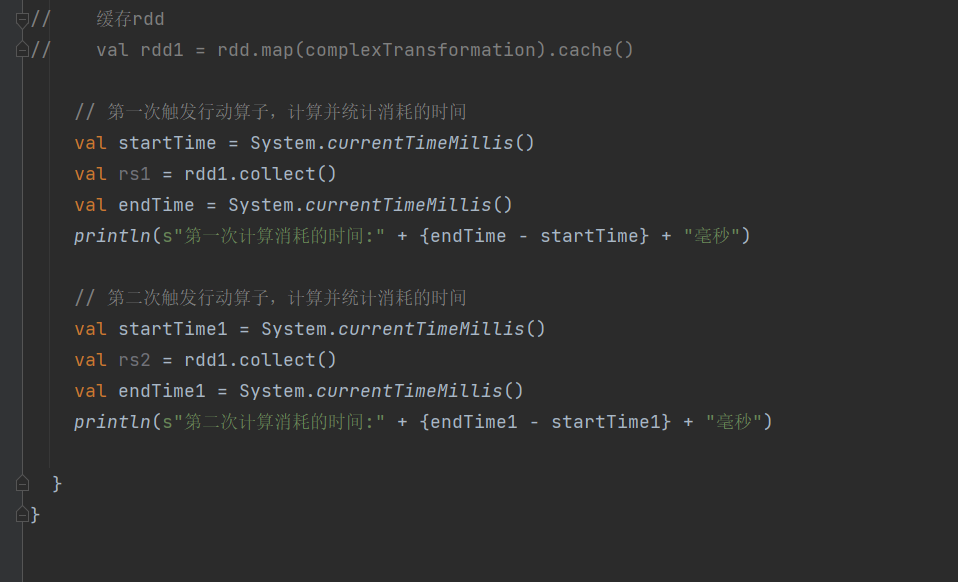
Spark缓存-cache

一、RDD持久化

1.什么时候该使用持久化(缓存)

  1. RDD cache & persist 缓存

  2. RDD CheckPoint 检查点

  3. cache & persist & checkpoint 的特点和区别

特点

区别

二、cache & persist 的持久化级别及策略选择

Spark的几种持久化级别:

1.MEMORY_ONLY

2.MEMORY_AND_DISK

3.MEMORY_ONLY_SER

4.MEMORY_AND_DISK_SER

5.DISK_ONLY

6.MEMORY_ONLY_2, MEMORY_AND_DISK_2, 等等

策略选择


版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。

原文链接:https://blog.csdn.net/2401_83378805/article/details/147915471

相关推荐
见闻小天地2 分钟前
空调机房赛莱默B&G冷冻泵/冷却泵的核心技术特性分析
大数据·运维·数据库
JWASX23 分钟前
【agent 开发】Agent 智能体
大数据·人工智能·python
copilot中国版1 小时前
从关账到报表,Copilot 帮财务搭建标准化管理体系
大数据
T06205141 小时前
【数据集】地级市市场分割指数和市场一体化指数数据(2001-2024年)
大数据
FPGA信号处理1 小时前
【电磁大数据理论与算法】第四课:电磁感知
大数据
问商十三载12 小时前
AI引擎生成式优化实践:刑事辩护律师团队IP构建
大数据·人工智能
会议咨询13 小时前
2026年大数据、信息系统与智能通信国际会议(BDIIC 2026)
大数据·信息系统·智能通信
Raas10013 小时前
MAI Gateway(魔芋企业级AI网关)能力解析:AI网关能做故障转移吗?AI网关核心功能详解
大数据·人工智能·网关·ai·gateway·mai gateway
IT研究所14 小时前
AI-ITR平台如何减少客户问题反复升级?
大数据·运维·人工智能·低代码·自然语言处理·安全架构·企微
回眸&啤酒鸭14 小时前
【回眸】OpenSwarm 多智能体协作系统实战指南
大数据·前端·人工智能