FunASR 是达摩院开源的综合性语音处理工具包,提供语音识别(ASR)、语音活动检测(VAD)、标点恢复(PUNC)等全流程功能,支持多种主流模型(如 Paraformer、Whisper、SenseVoice)的推理、微调和部署。
1. funasr安装
sh
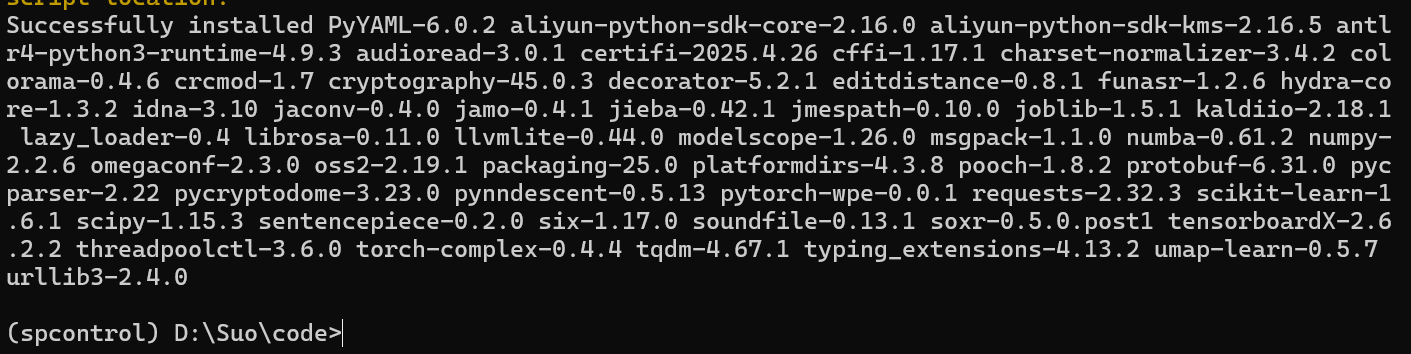
pip install funasr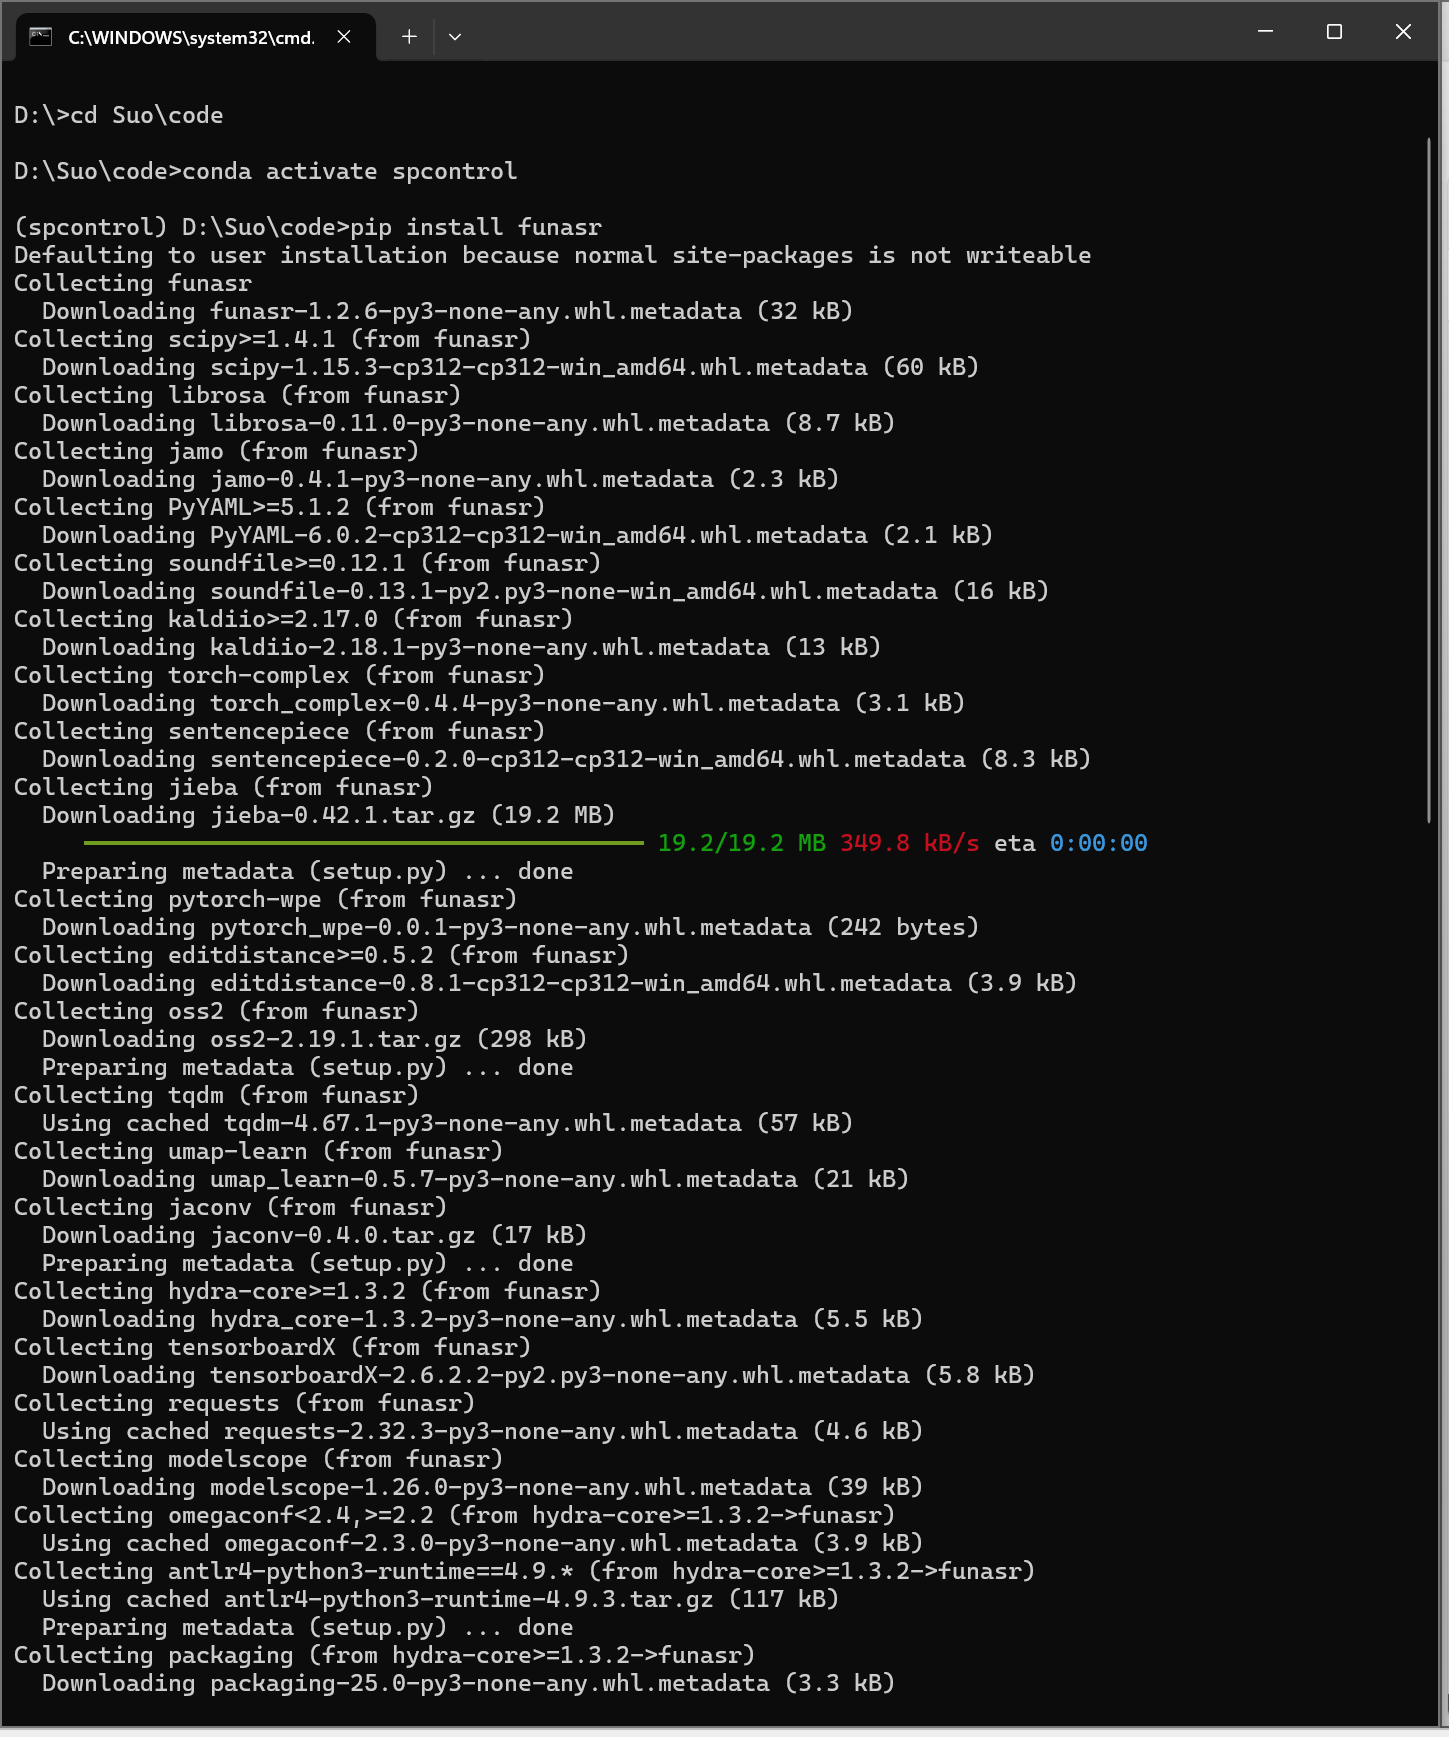
2. 模型下载
sh
pip install modelscope
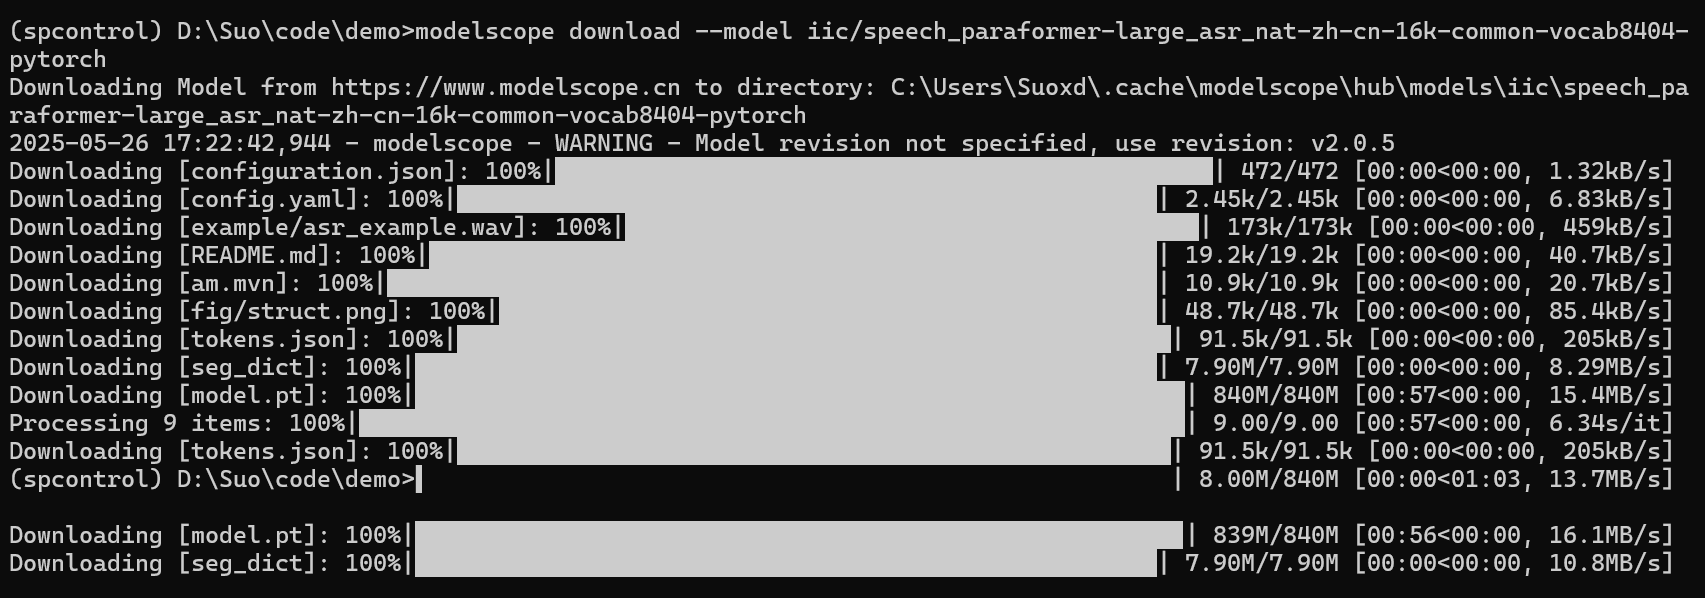
modelscope download --model iic/speech_paraformer-large_asr_nat-zh-cn-16k-common-vocab8404-pytorch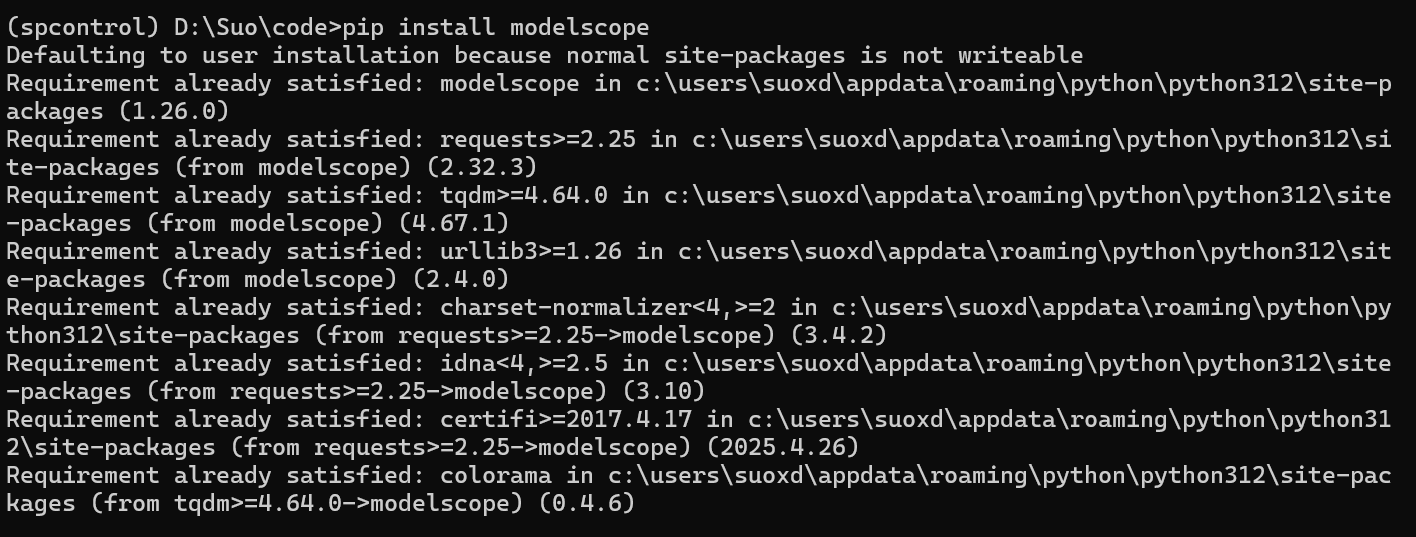
3. 依赖库安装
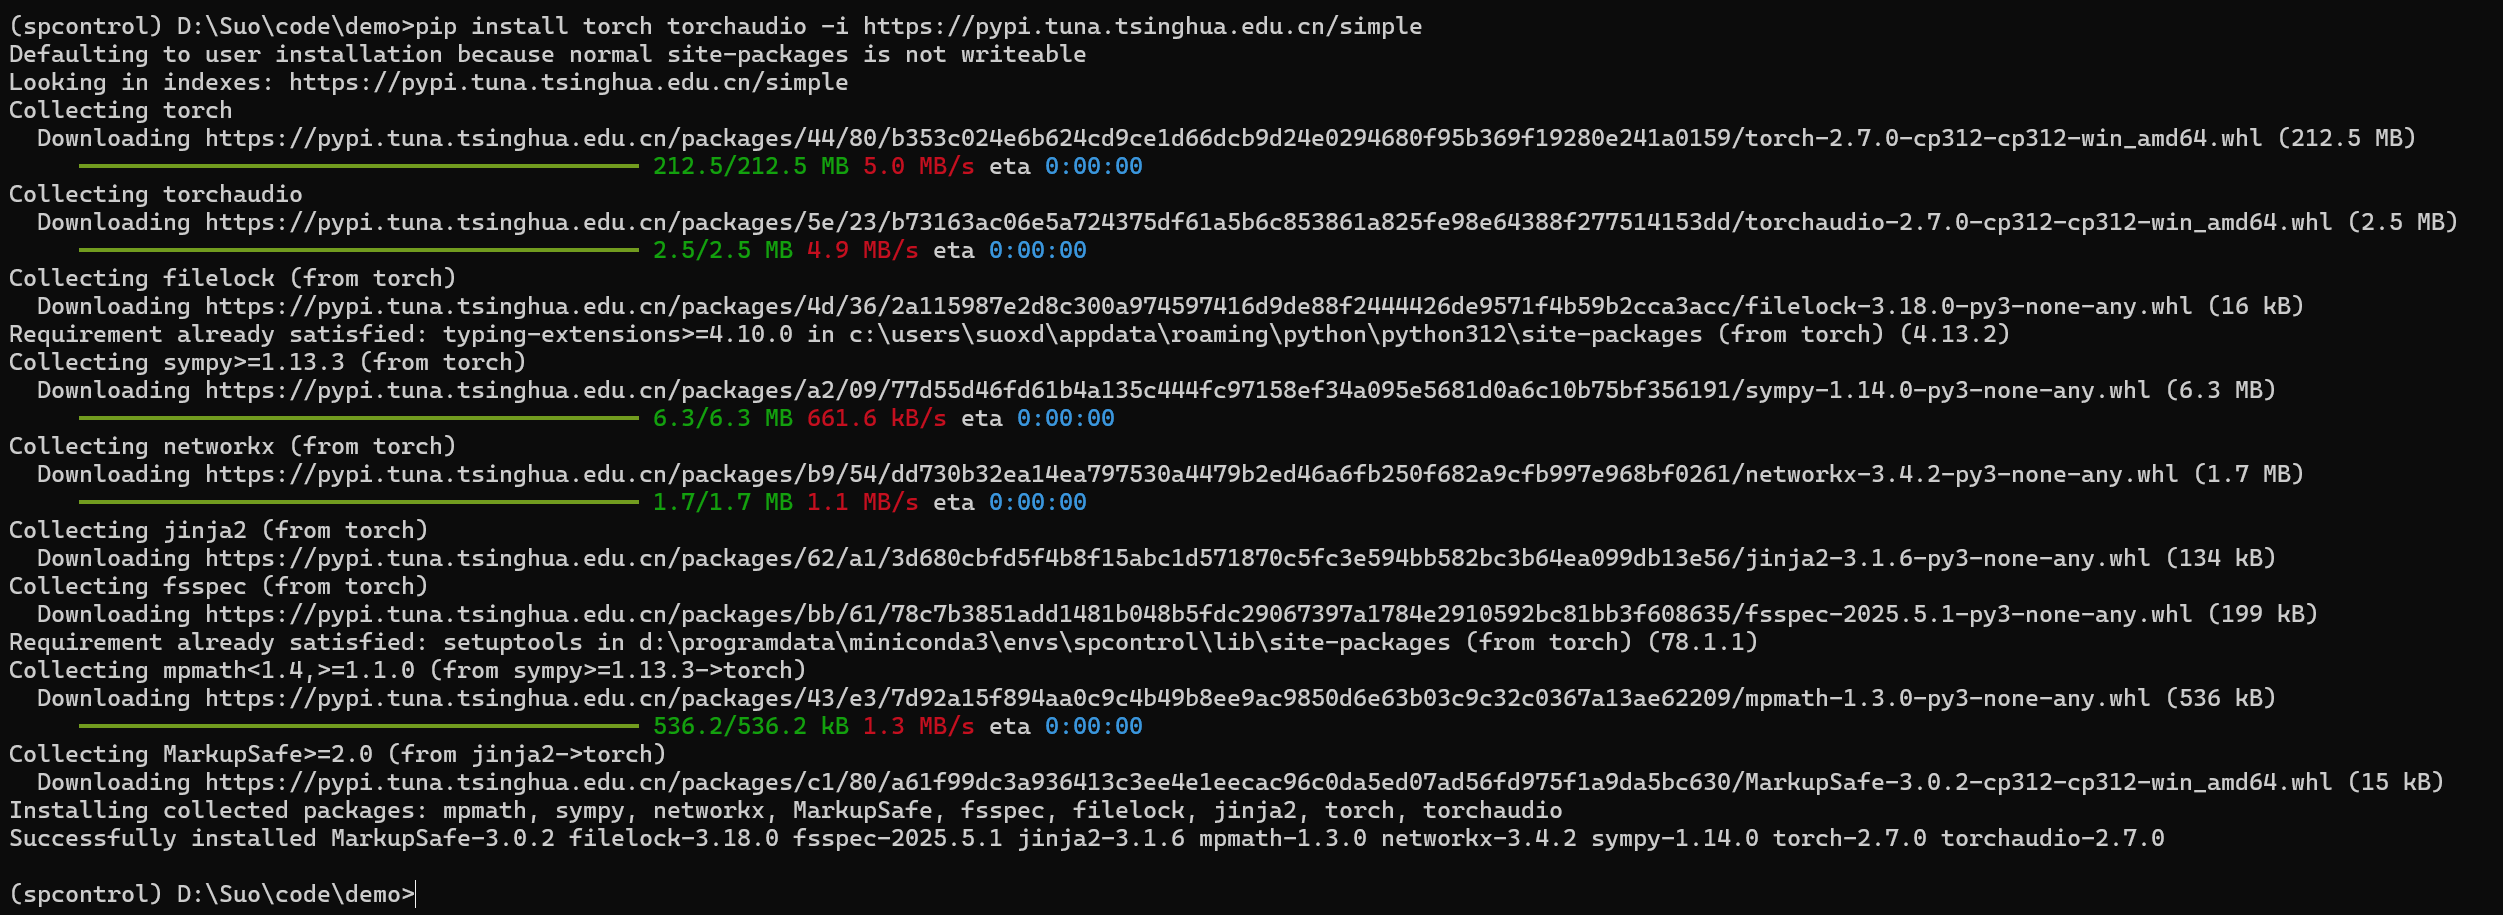
pip install torch torchaudio -i https://pypi.tuna.tsinghua.edu.cn/simple
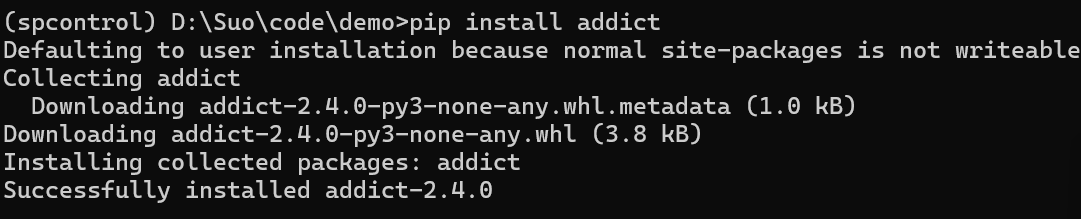
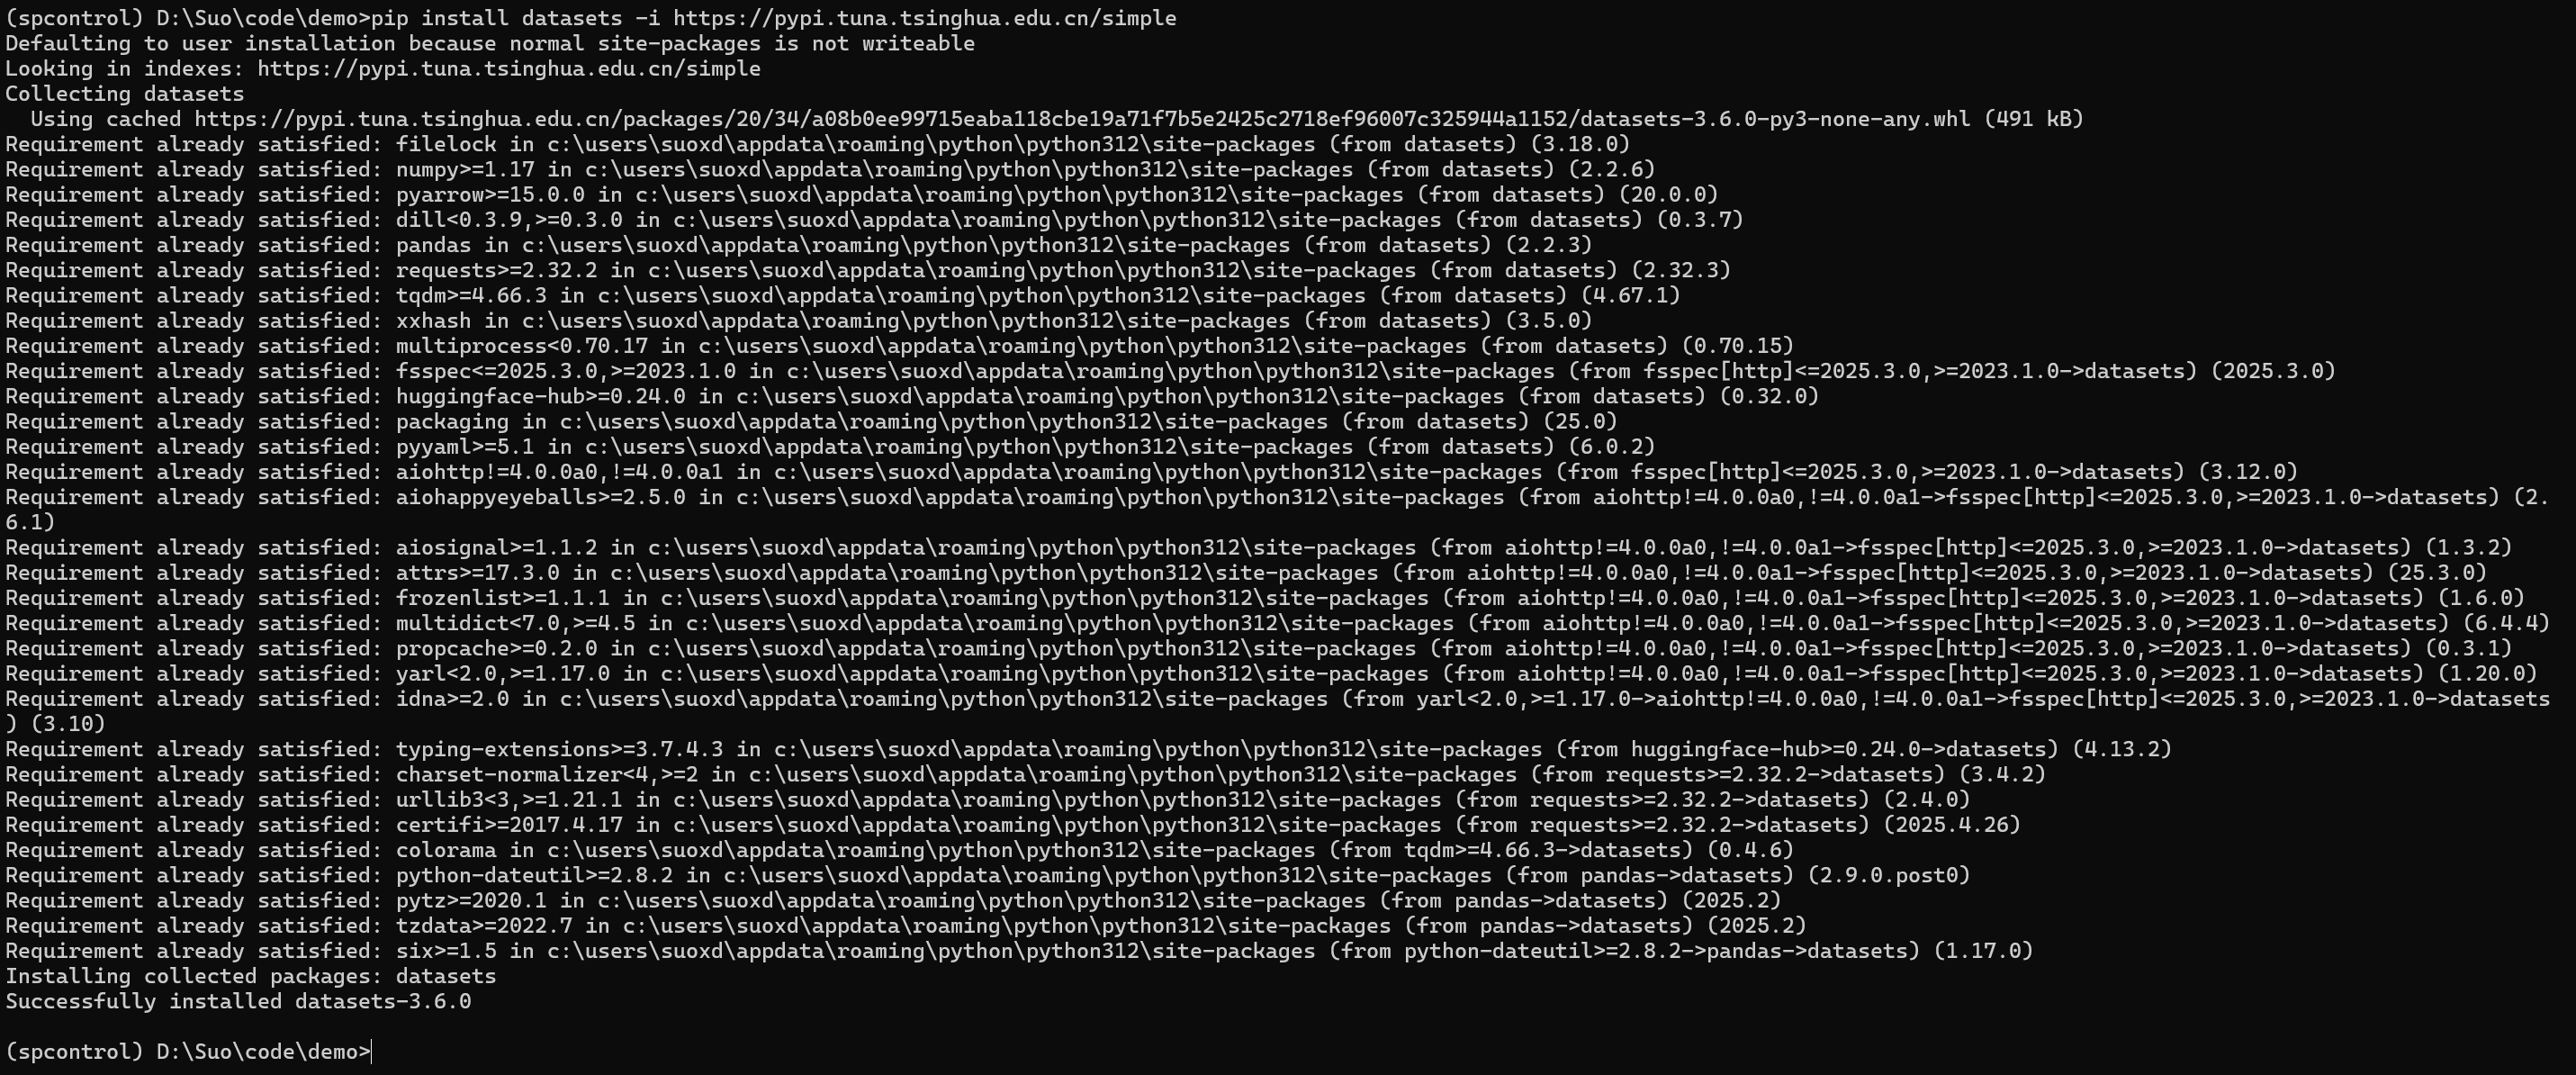
pip install addict, datasets -i https://pypi.tuna.tsinghua.edu.cn/simple
4. 模式一:使用本地模型
4.1 程序编码(本地模型)
python
from funasr import AutoModel

model = AutoModel(
    model="./speech_paraformer-large_asr_nat-zh-cn-16k-common-vocab8404-pytorch",
    disable_update=True,
    device="cpu"  # 或 "cuda" 如果有GPU
)
res = model.inference(input="asr_example.wav")
print("识别结果:", res[0]["text"])
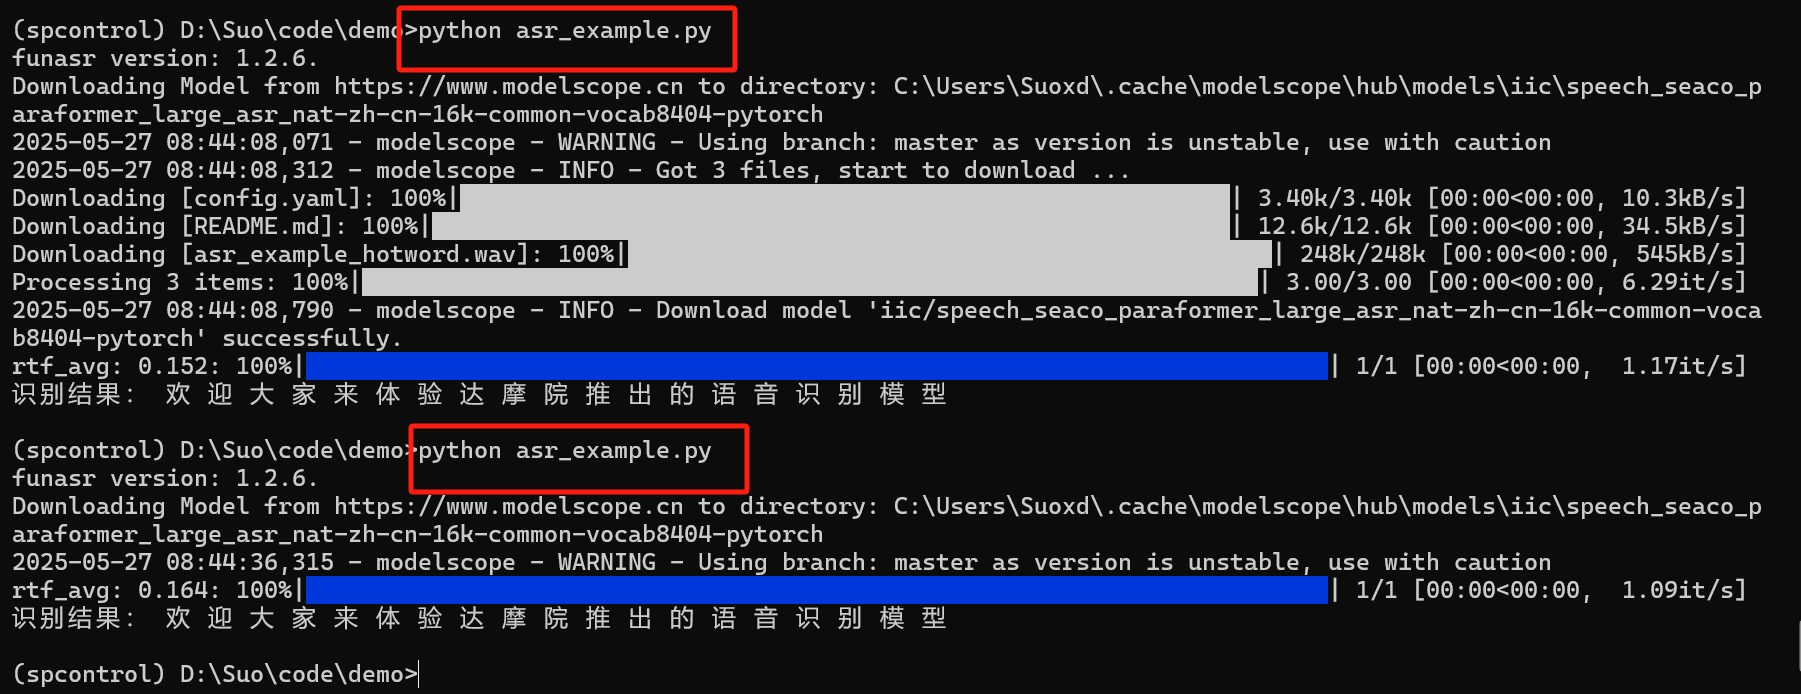
4.2. 运行测试(本地模型)

5. 模式二:运行时自动下载模型
5.1 程序编码(运行时下载模型)
python
from funasr import AutoModel

model = AutoModel(
    model="paraformer-zh",
    disable_update=True,
    device="cpu"  # 或 "cuda" 如果有GPU
)
res = model.inference(input="asr_example.wav")
print("识别结果:", res[0]["text"])
5.2 运行测试(运行时下载模型)
下载后,第二次执行则不再下载,但程序启动会检查。
6. 模式三:指定vad等子模型
6.1 程序编码(指定子模型)
python
from funasr import AutoModel

model = AutoModel(
    model="paraformer-zh",
    model_revision="v2.0.4",
    vad_model="fsmn-vad",
    punc_model="ct-punc",
    disable_update=True,
    device="cpu"  # 或 "cuda" 如果有GPU
)
res = model.inference(input="asr_example.wav")
print("识别结果:", res[0]["text"])
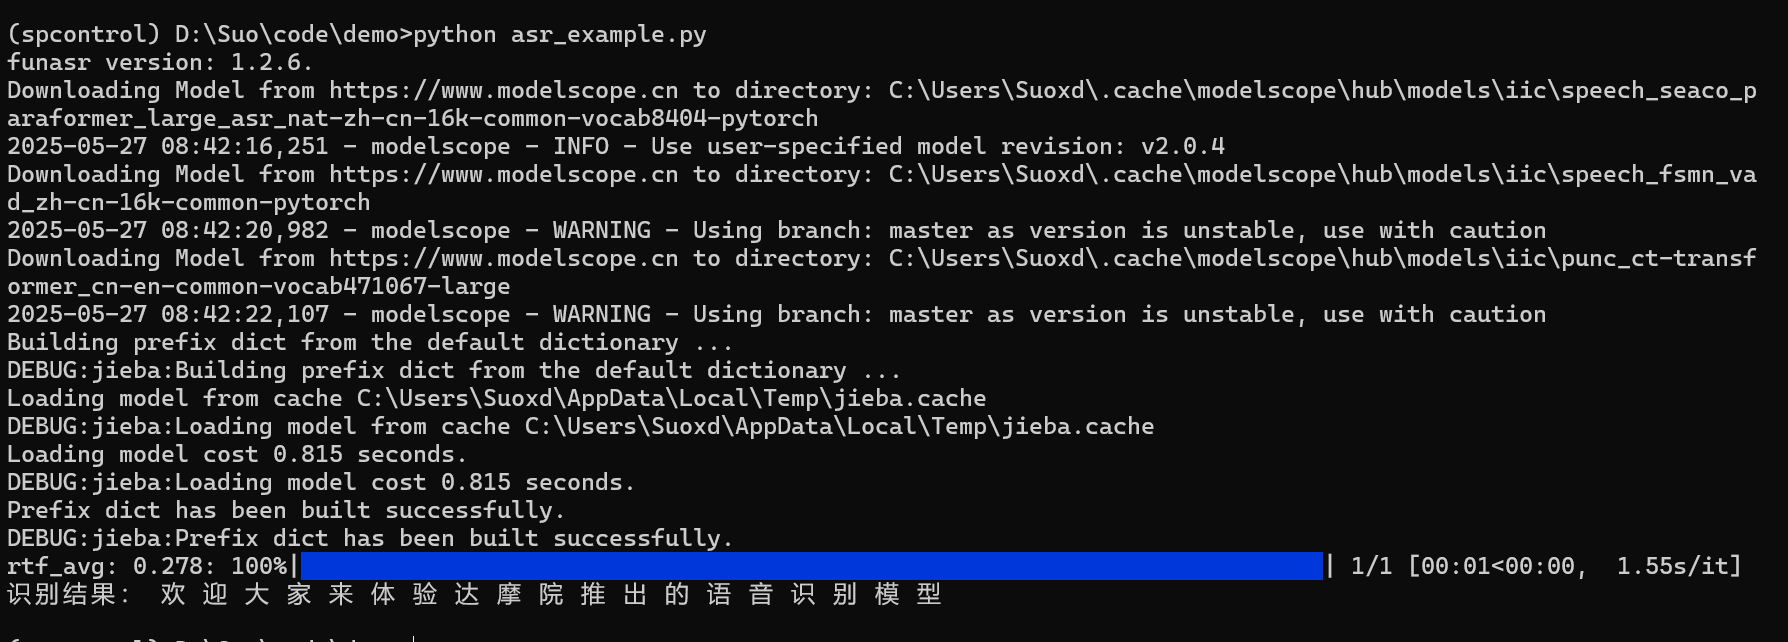
6.2 运行测试(指定子模型)
7. 模式四:使用generate
7.1 程序编码(使用generate)
python
from funasr import AutoModel
import soundfile as sf

model = AutoModel(
    model="paraformer-zh",
    model_revision="v2.0.4",
    vad_model="fsmn-vad",
    punc_model="ct-punc",
    disable_update=True,
    device="cpu"  # 或 "cuda" 如果有GPU
)
waveform, _ = sf.read("asr_example.wav")

result = model.generate(input=waveform)
print("识别结果:", result[0]["text"])
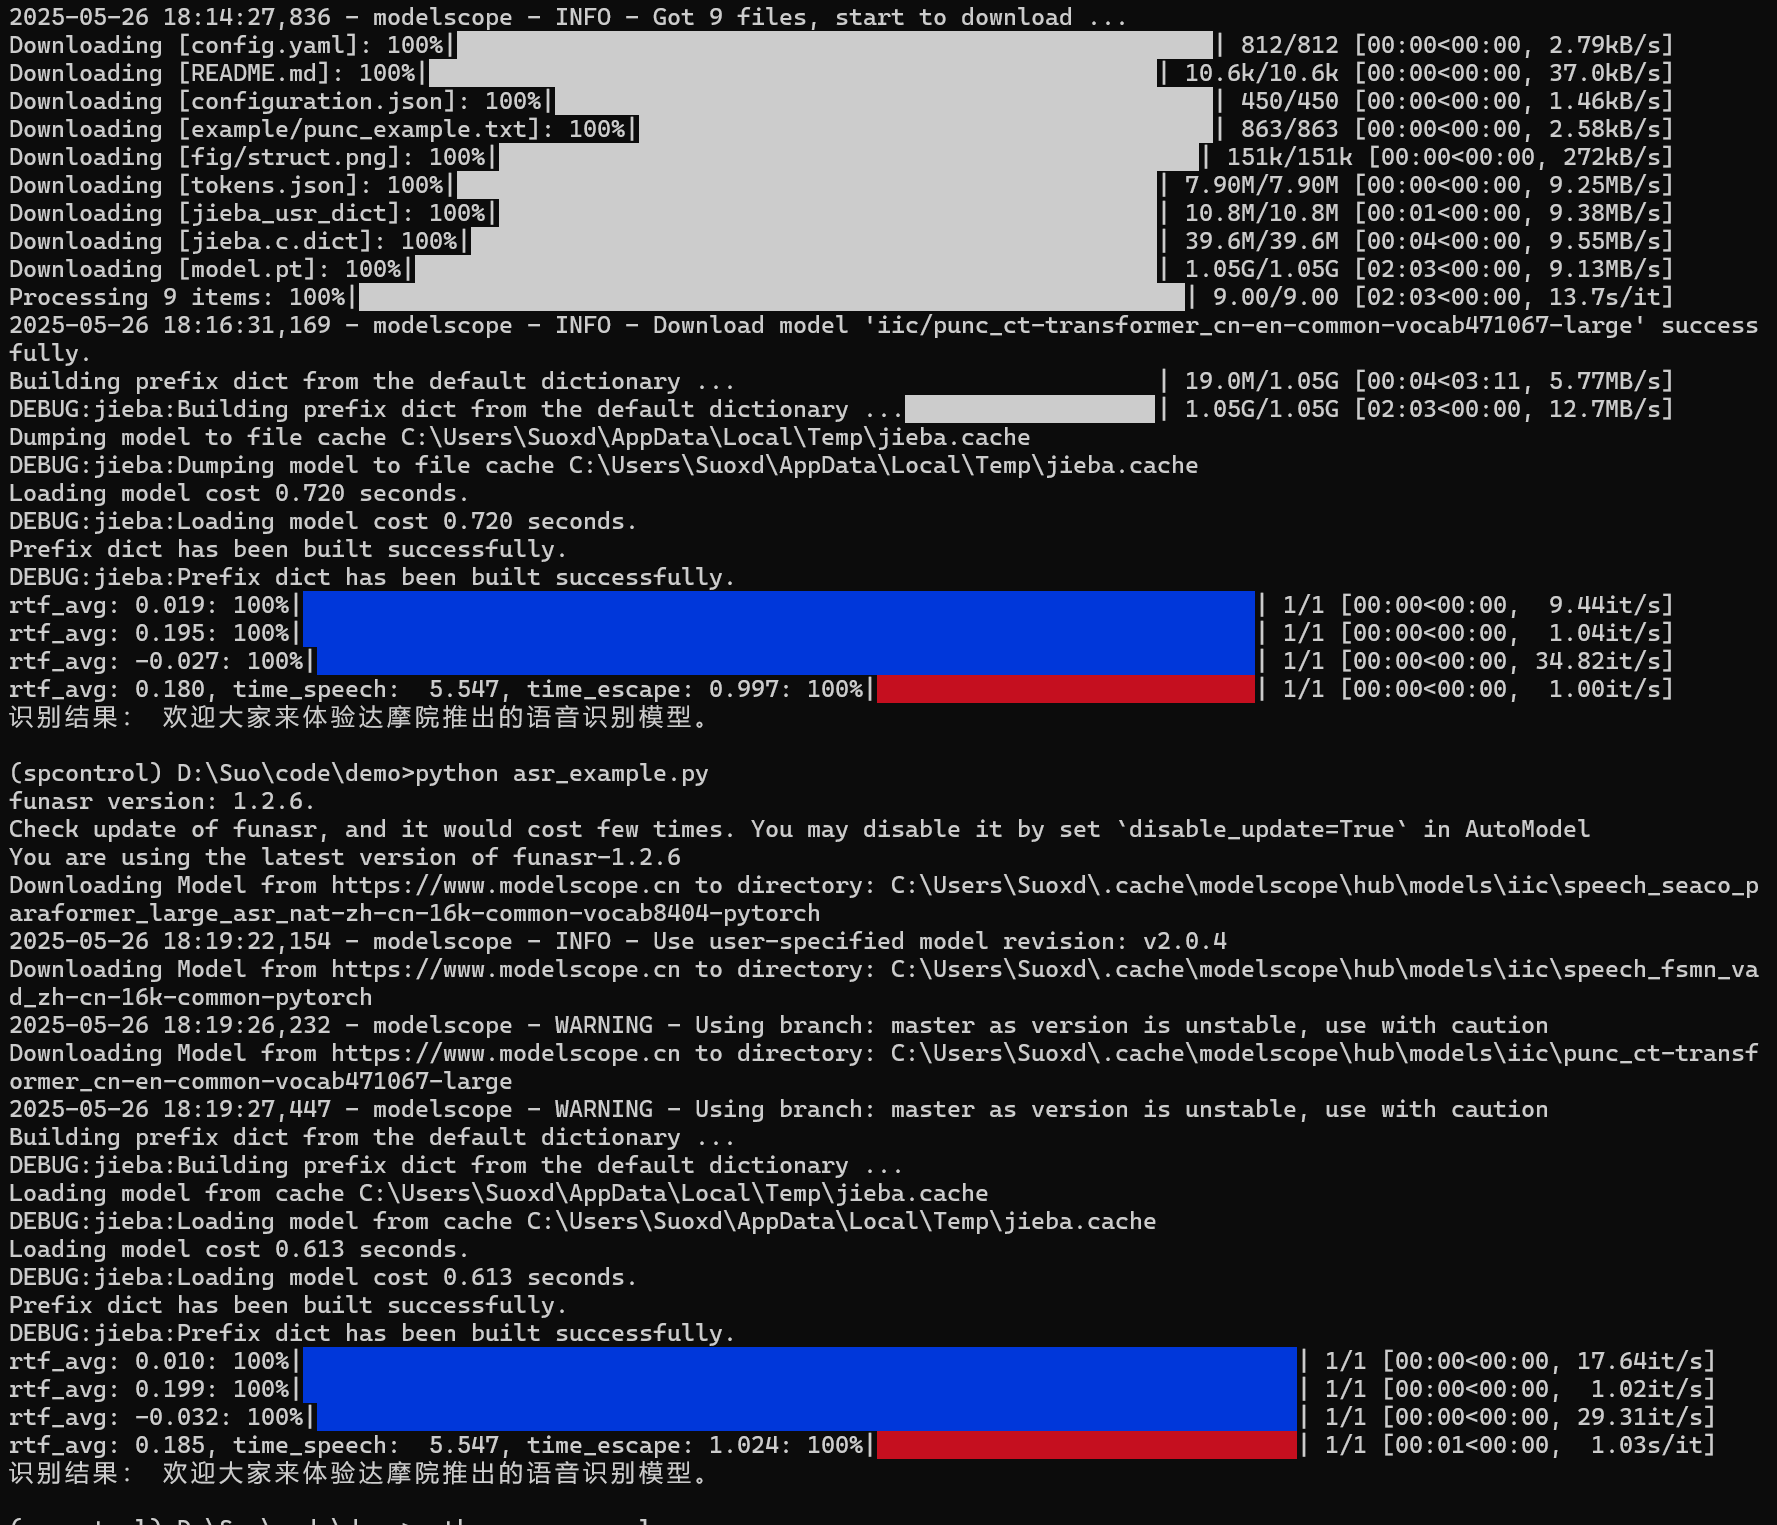
7.2 运行测试(使用generate)
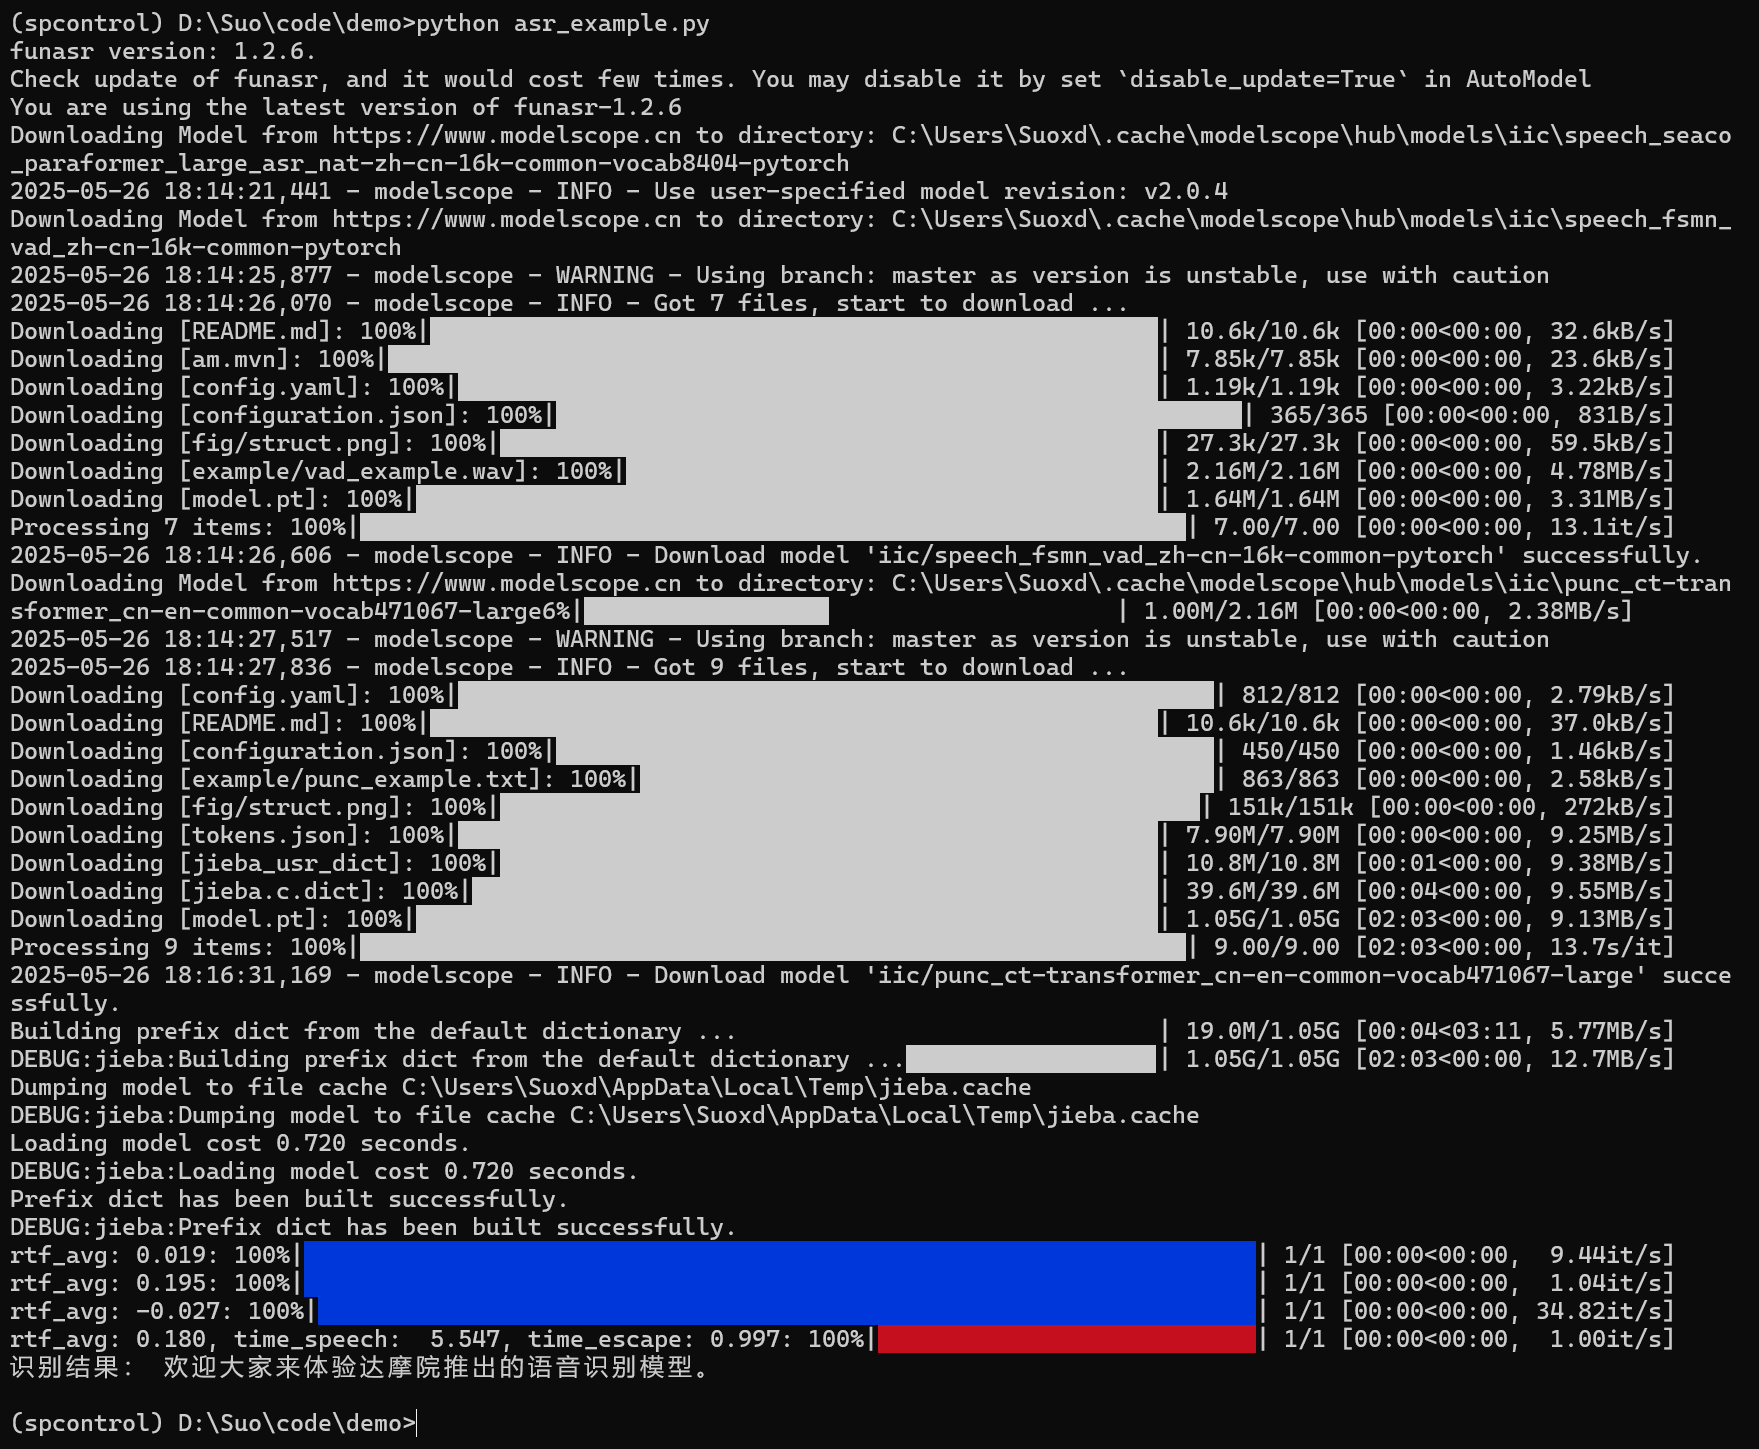
第二次运行不会下载模型。
sh
# 创建虚拟环境
python -m venv sensevoice_env
source sensevoice_env/bin/activate  # Linux/macOS
sensevoice_env\Scripts\activate     # Windows

# 安装 SenseVoice 依赖
pip install torch torchaudio numpy