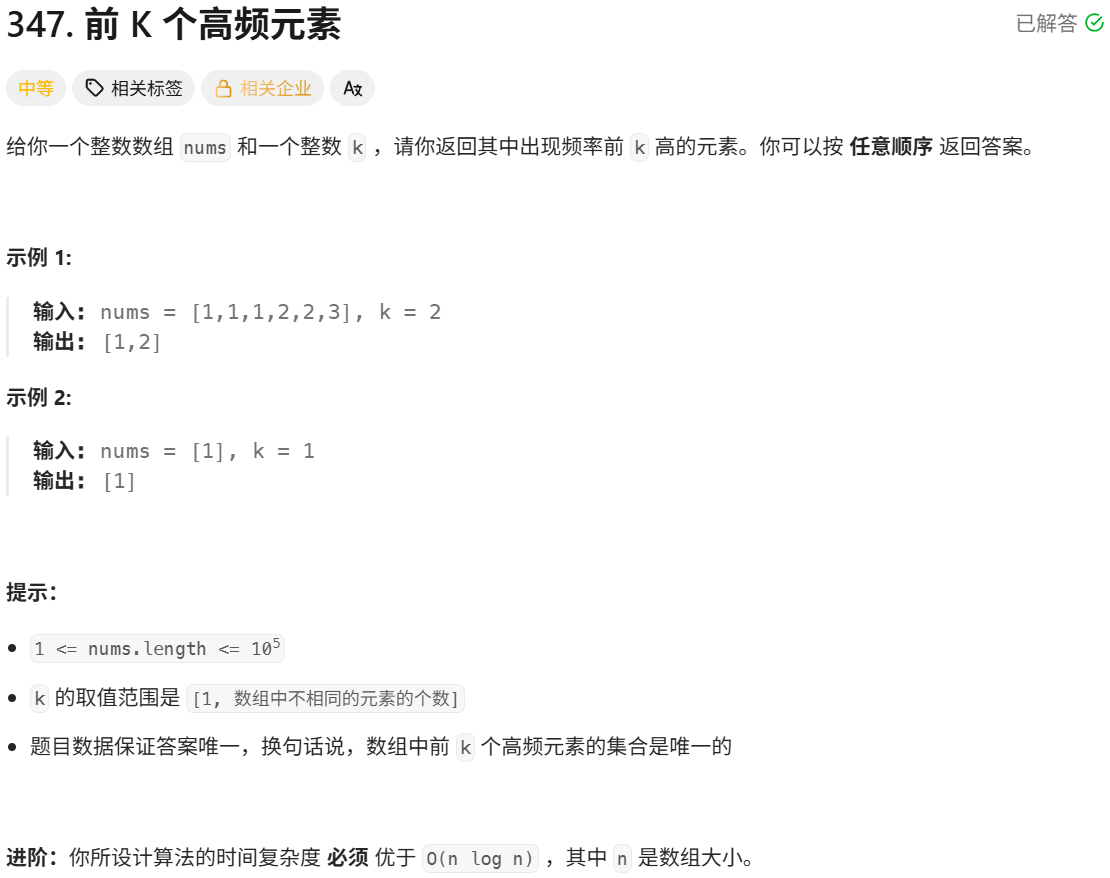
这道题如果不要求时间复杂度的话其实随便怎么做都行,但是这里有个时间复杂度的限制,还是要好好想想怎么做耗时最短。看了一下灵神的题解,我觉得他提到的桶排序方法还是很通俗易懂的。下面讲一下主要的思路。
我们首先定义一个哈希表,为了保证插入操作的耗时不会过长,这里我们使用unordered_map来实现,我们先遍历数组nums,统计每个元素出现的频次,将键值对存储在hash中,然后我们定义一个二维数组buckets,其中每一个一维数组中存放的元素出现频次相同,我们定义:在nums出现了i次的元素将存入buckets[i]中,我们遍历一遍哈希表,将对应的元素添加到对应的桶子里,最后,我们从后向前遍历buckets,如果遇到长度不为0的一维数组(桶子),则将桶中的所有元素添加到结果result中,并同时将k减去桶中的元素个数,当k <= 0时,说明已经查找完毕,我们直接结束遍历,将result返回即可。
cpp
class Solution {
public:
    vector<int> topKFrequent(vector<int>& nums, int k) {
        unordered_map<int, int> hash;  //用于存放数组元素和对应的出现频次
        vector<vector<int>> buckets(nums.size() + 1);   //其中的每一个一维数组用于存放出现频次相同的元素
        vector<int> result;  //用于存储结果
        //统计各个元素的出现频次
        for(int& i : nums)
            hash[i]++;
        //将出现次数相同的元素放到同一个桶中
        for(auto& i : hash)
            buckets[i.second].emplace_back(i.first);
        for(int i = buckets.size() - 1; i > 0; i--){
            if(!buckets[i].empty()){
                result.insert(result.end(), buckets[i].begin(), buckets[i].end());
                k -= buckets[i].size();
                if(k <= 0) break;  //收集完毕,直接退出循环
            }
        }
        return result;
    }
};