工具介绍
阿里云漏洞库爬虫 (AliyunCVE_Crawler),一个高效的阿里云漏洞库爬虫工具,用于自动化爬取和处理CVE(Common Vulnerabilities and Exposures)数据。
🚀 功能特性
- 批量爬取: 支持批量爬取阿里云漏洞库的CVE数据
- 增量更新: 支持增量爬取,只获取指定日期后的新漏洞
- 详细信息: 提取完整的CVE详情,包括描述、解决方案、CVSS评分等
- 数据标准化: 自动转换为标准CVEInfo格式,便于后续处理
- 并发处理: 支持异步并发爬取,提高效率
- 智能重试: 内置错误处理和重试机制
- 数据持久化: 自动保存爬取结果到JSON文件
- 性能监控: 提供详细的爬取统计和性能指标
- 🎨 现代GUI: 基于ttkbootstrap的现代化图形界面
- 📊 数据可视化: 实时统计和结果展示
- ⚙️ 可视化配置: 直观的参数设置和管理
- ⏹️ 安全停止: 支持爬取过程中的安全中断和停止
🛠️ 安装
1. 克隆项目
bash
git clone https://github.com/vistaminc/AliyunCVE_Crawler.git
cd AliyunCVE_Crawler
2. 安装依赖
bash
pip install -r requirements.txt3. 安装浏览器驱动
bash
playwright install chromium📖 快速开始
🎨 图形界面(推荐)
bash
# 启动现代化GUI界面
python run_gui.py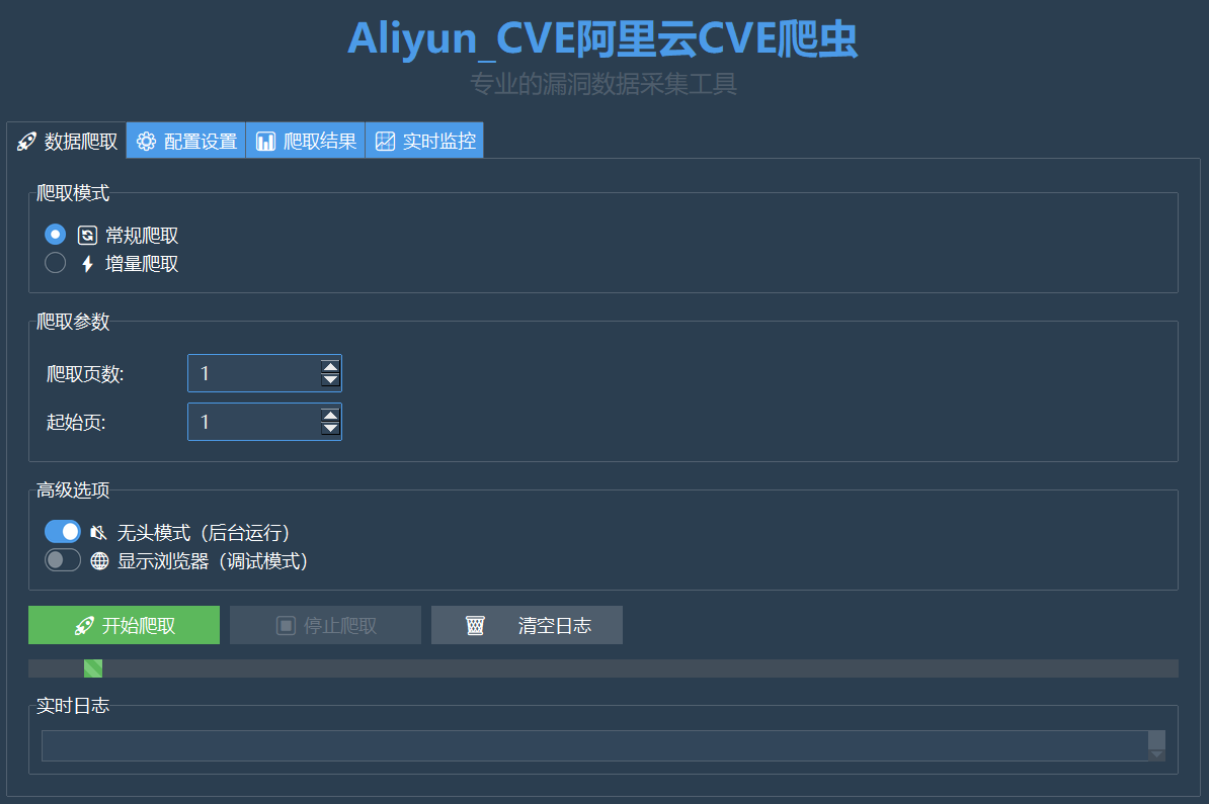
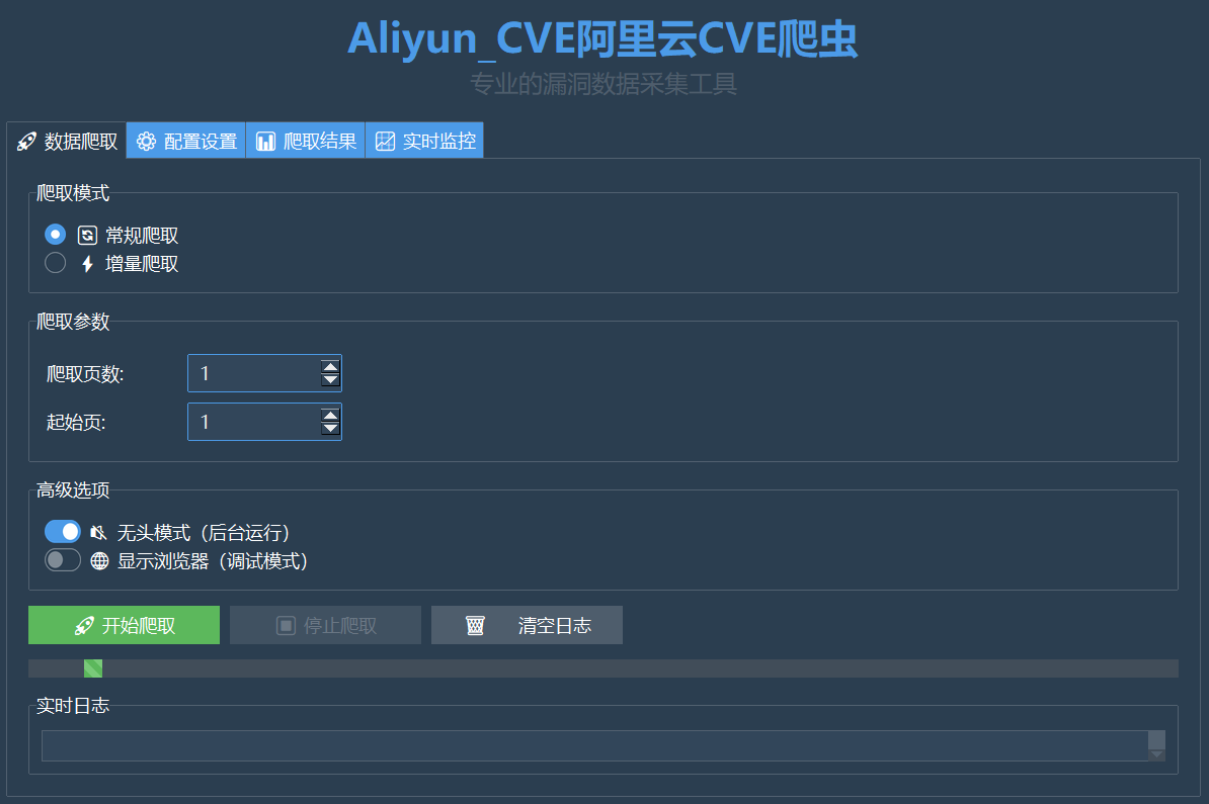
GUI界面提供:
- 🖱️ 直观的点击操作
- 📊 实时数据展示
- ⚙️ 可视化配置管理
- 📈 爬取进度监控
- 💾 一键导出功能
💻 命令行使用
bash
# 爬取前10页数据
python main.py --pages 10

# 从第5页开始爬取10页
python main.py --pages 10 --start-page 5

# 增量爬取最近7天的数据
python main.py --incremental --days 7

# 显示浏览器界面(调试模式)
python main.py --pages 5 --no-headless
🐍 Python API
python
import asyncio
from main import crawl_aliyun_cves

async def main():
    # 爬取前5页的CVE数据
    cve_infos = await crawl_aliyun_cves(max_pages=5)
    print(f"成功爬取 {len(cve_infos)} 个CVE")

asyncio.run(main())