macOS操作系统部署开源DeepSeek大模型,搭建Agent平台,构建私有化RAG知识库完整流程
- [1 部署DS大模型](#1 部署DS大模型)
-
- [1.1 下载macOS版ollama](#1.1 下载macOS版ollama)
- [1.2 验证](#1.2 验证)
- [1.3 部署DeepSeek模型](#1.3 部署DeepSeek模型)
- [1.4 测试对话](#1.4 测试对话)
- [2 搭建Agent](#2 搭建Agent)
-
- [2.1 下载macOS版本 AnythingLLM](#2.1 下载macOS版本 AnythingLLM)
- [2.2 切换中文](#2.2 切换中文)
- [2.3 配置本地服务](#2.3 配置本地服务)
- [3 构建RAG知识库](#3 构建RAG知识库)
-
- [3.1 部署BGE-M3](#3.1 部署BGE-M3)
- [3.2 配置本地嵌入模型](#3.2 配置本地嵌入模型)
- [3.3 新建工作区](#3.3 新建工作区)
- [3.4 上传文档](#3.4 上传文档)
- [3.5 测试对话](#3.5 测试对话)
昨天在马路上捡到一台全新的Mac Studio。
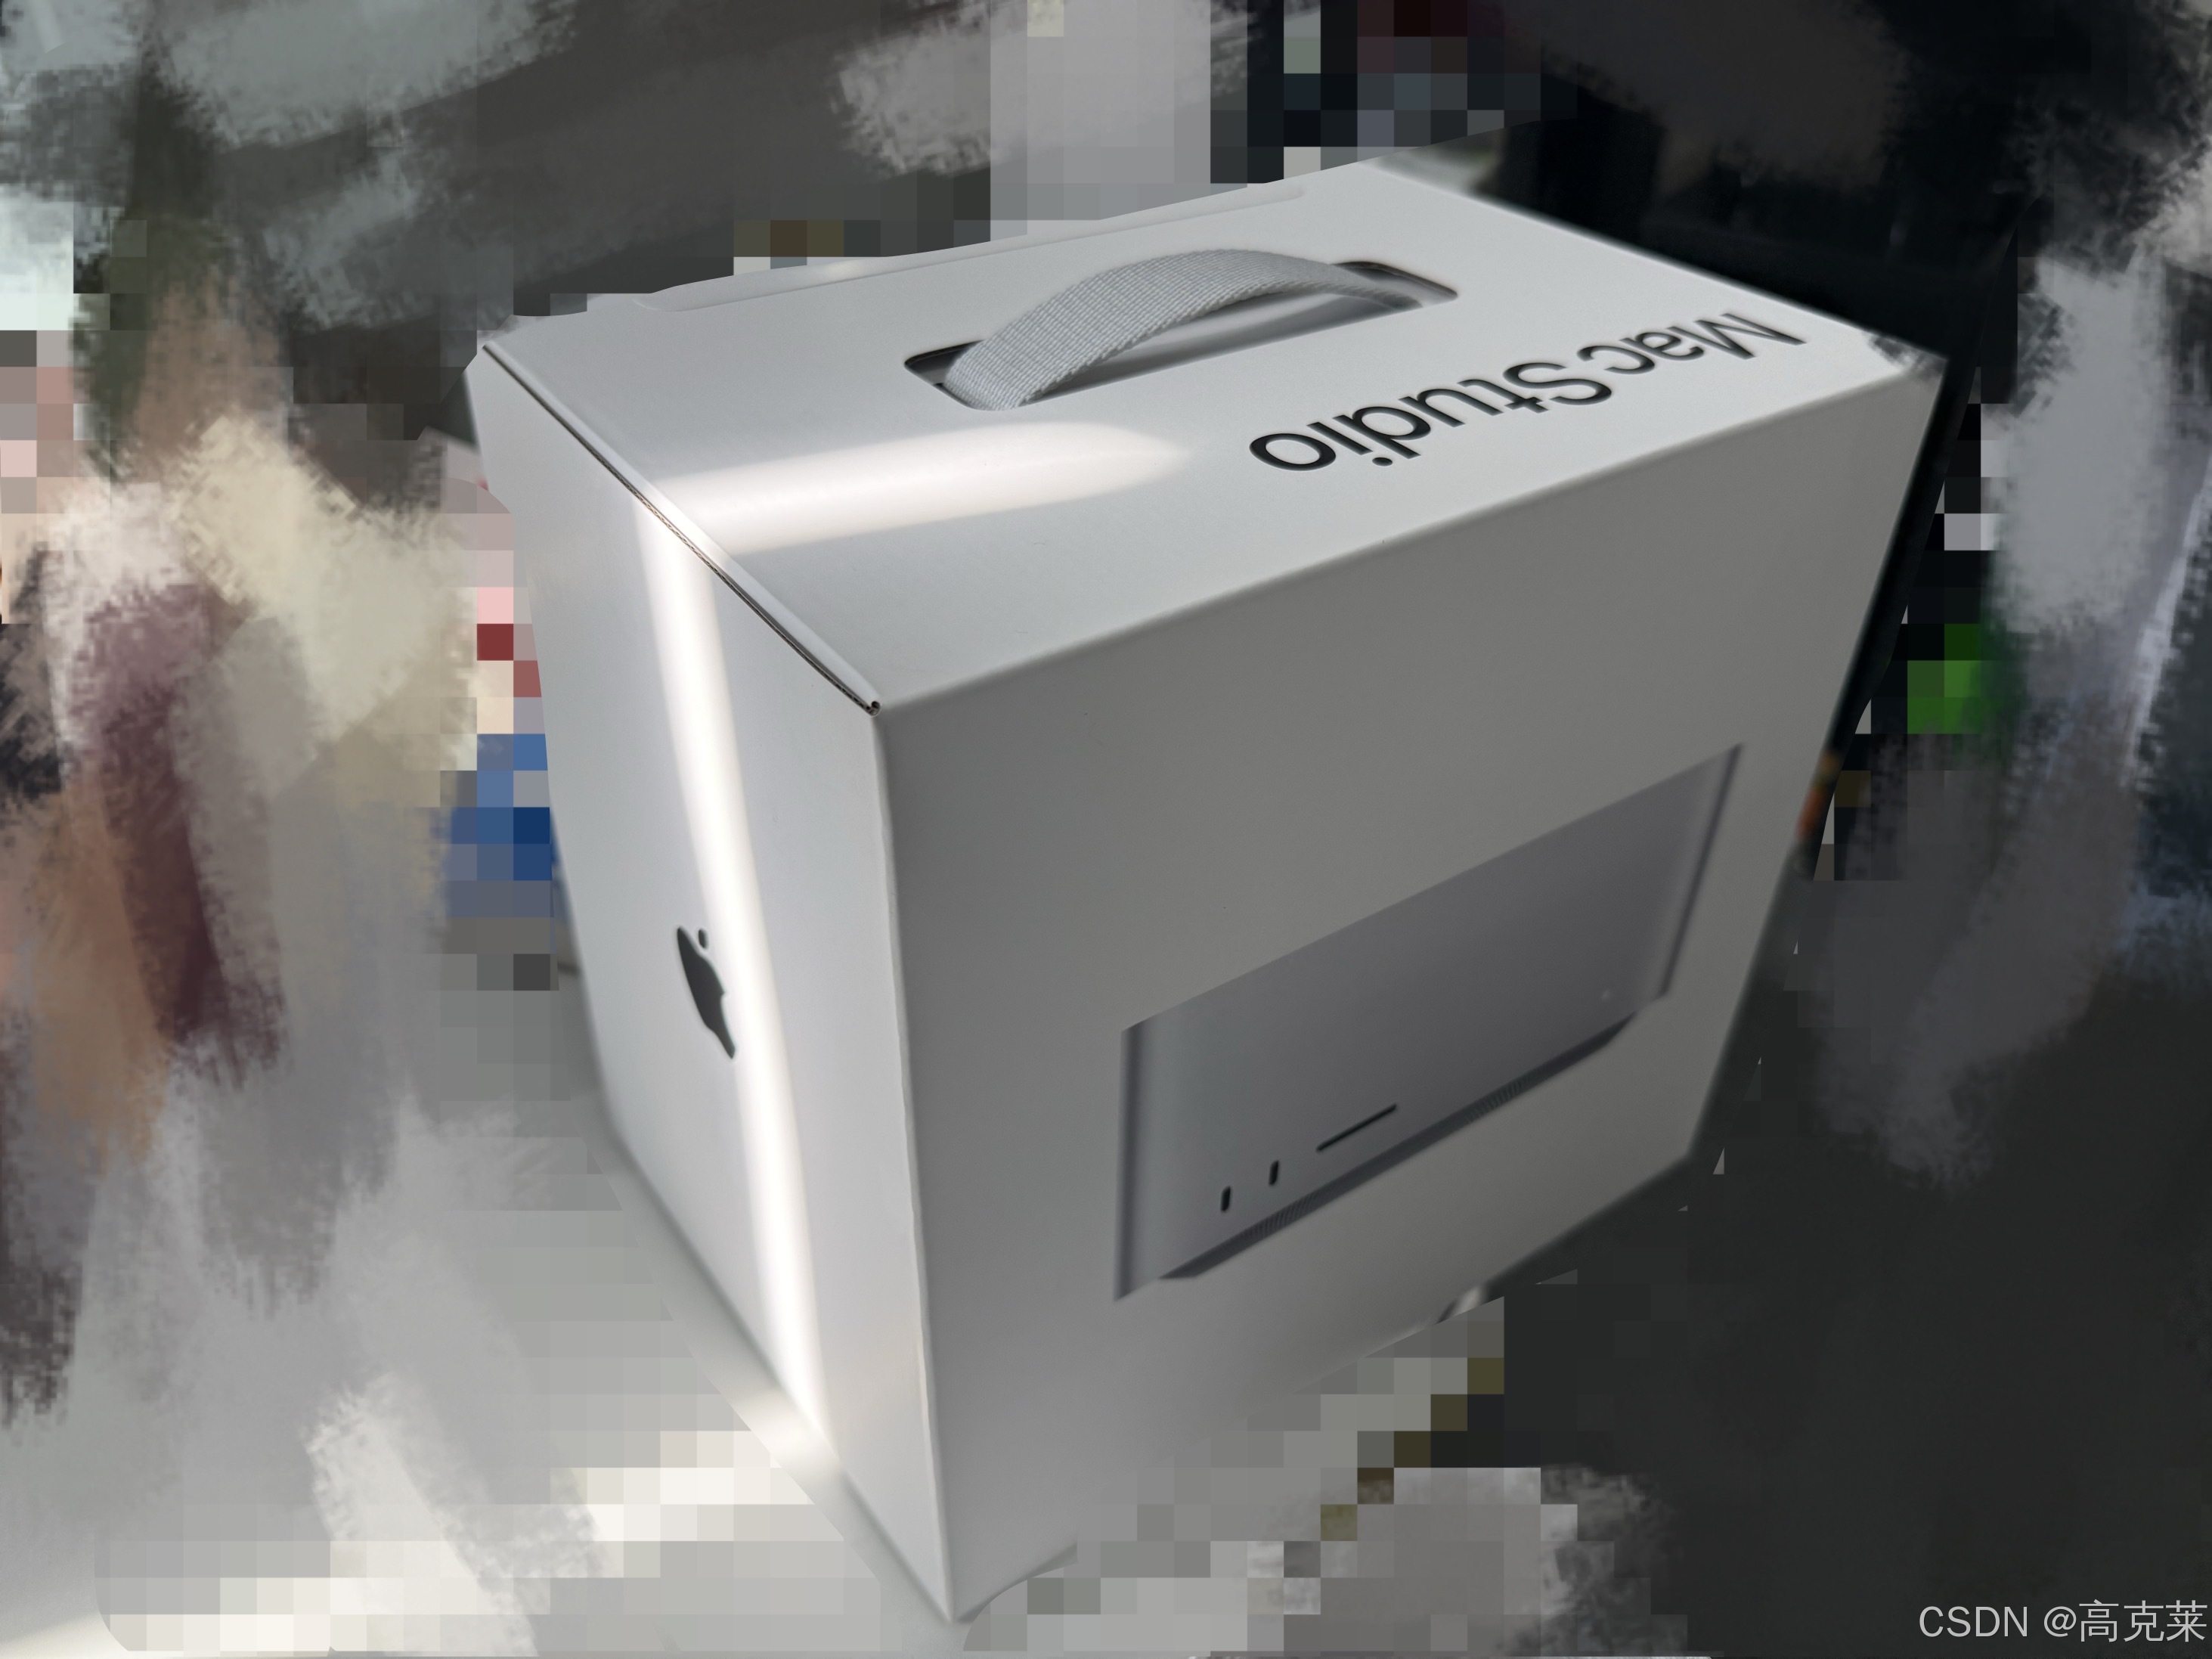
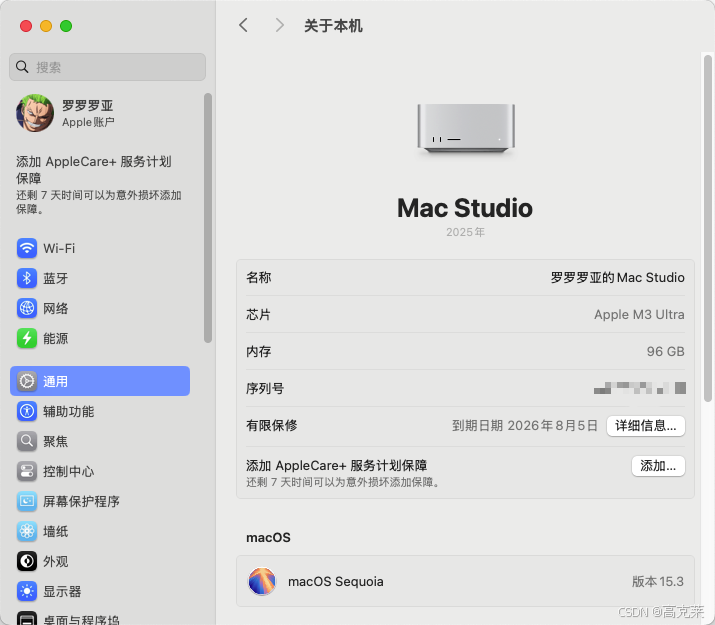
拆开一看配置还挺高的,好家伙早就听说macOS操作系统也非常适合拿来跑大模型了,赶紧激活系统试了一下,以下是部署流程的完整记录。
1 部署DS大模型
1.1 下载macOS版ollama
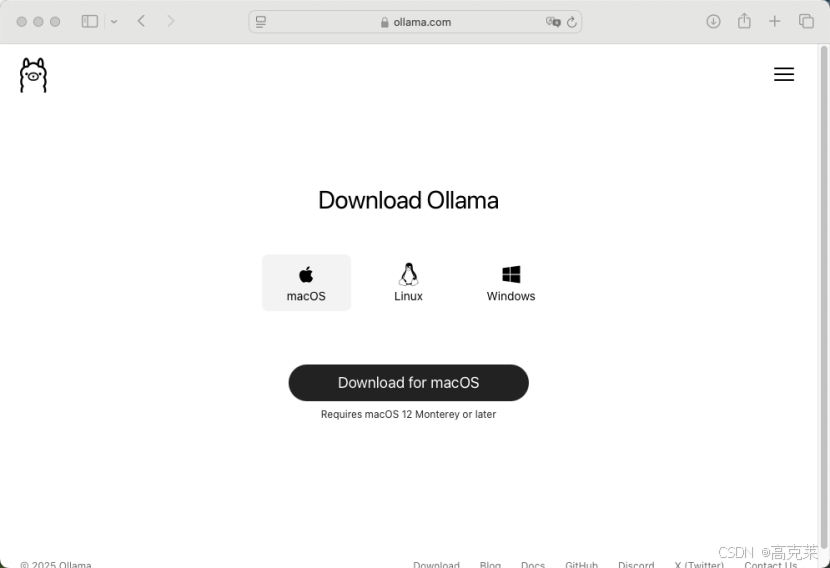
访问 ollama官网 下载macOS版ollama,将 Ollama 图标拖入 Applications 文件夹。
1.2 验证
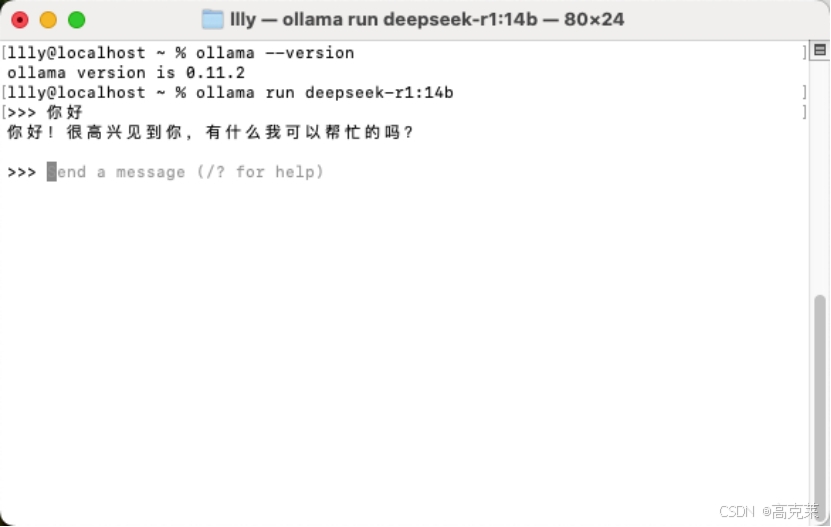
在终端中执行验证是否安装成功
ollama --version输出(例):
ollama version is 0.11.2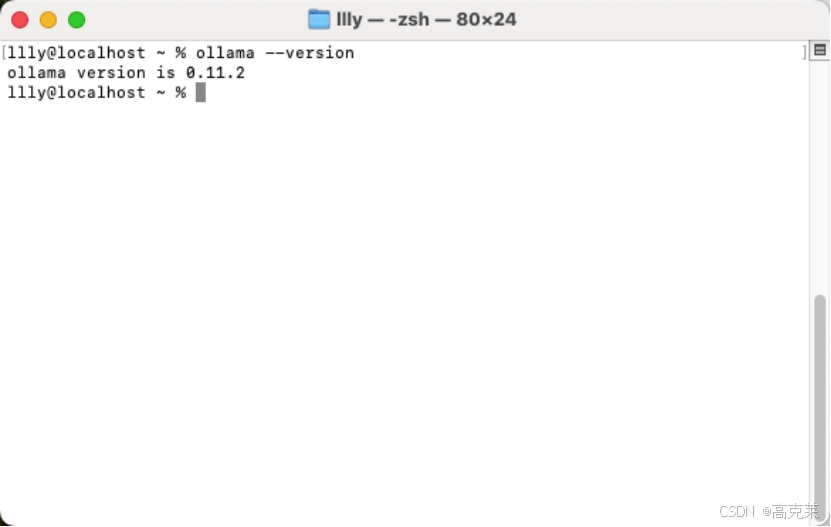
1.3 部署DeepSeek模型
在终端中执行部署DeepSeek模型
ollama run deepseek-r1:14b1.4 测试对话
部署完成后,启动模型进行对话
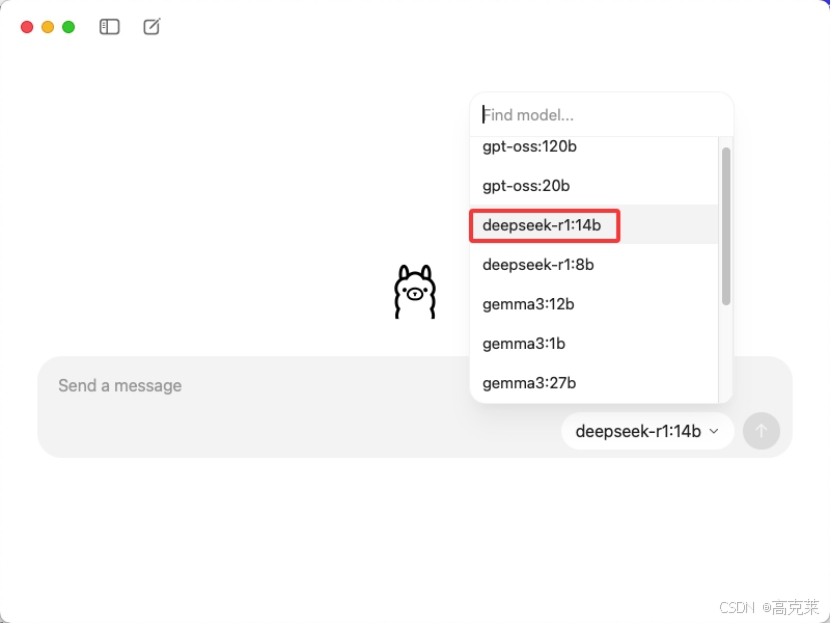
或在ollama界面输入问题,观察是否响应,ollama 界面时需要选择指定模型,选择未下载的模型发送信息ollama会自动拉取模型到本地
2 搭建Agent
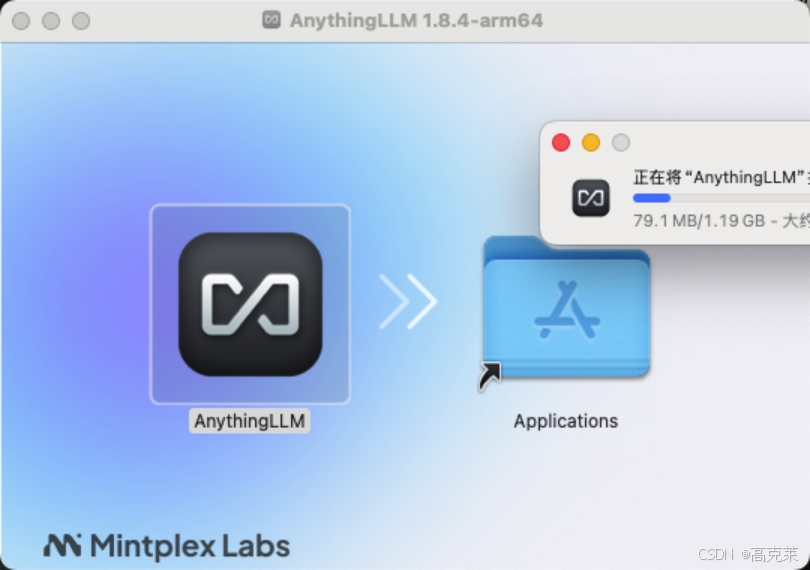
2.1 下载macOS版本 AnythingLLM
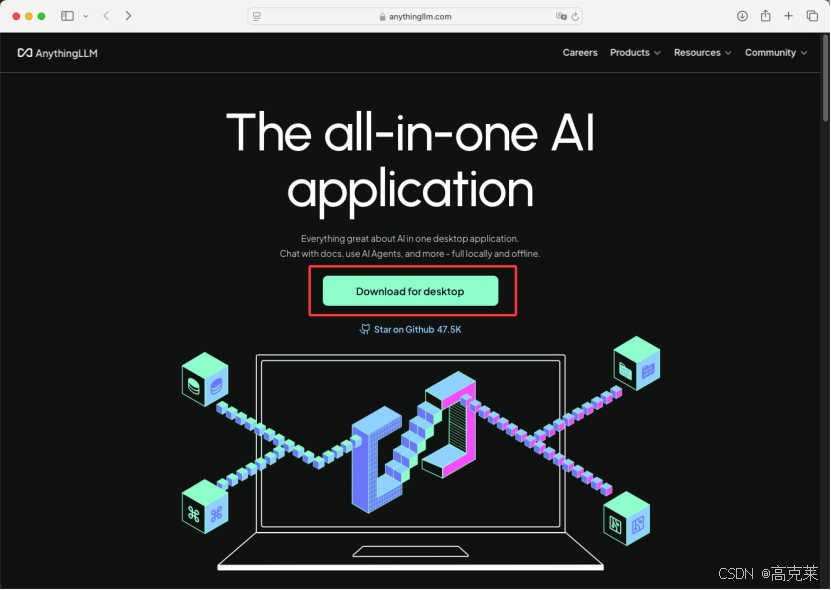
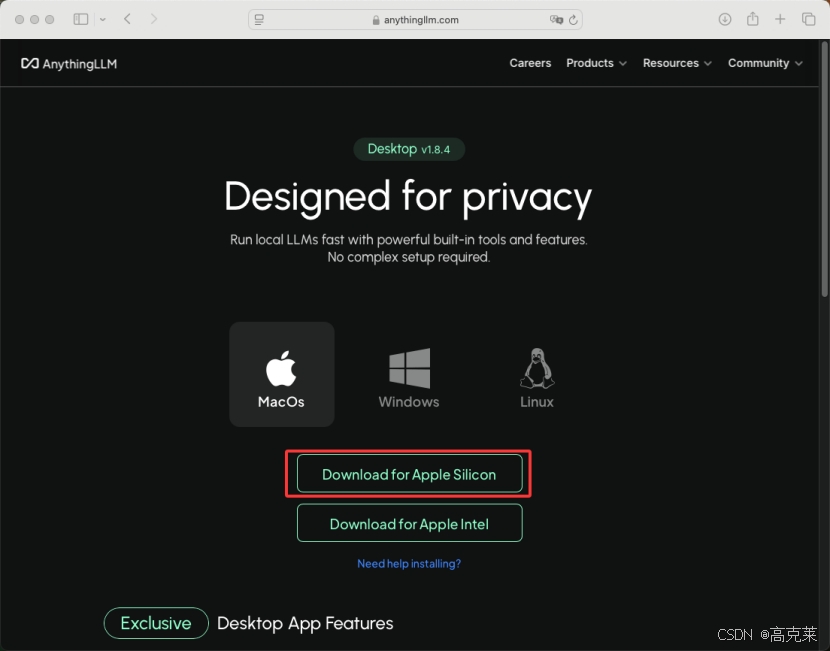
访问 AnythingLLM官网 下载macOS版本 AnythingLLM
2.2 切换中文
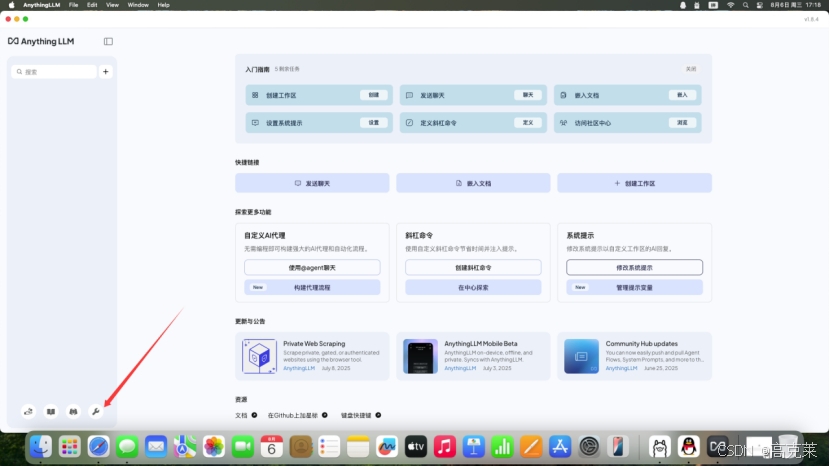
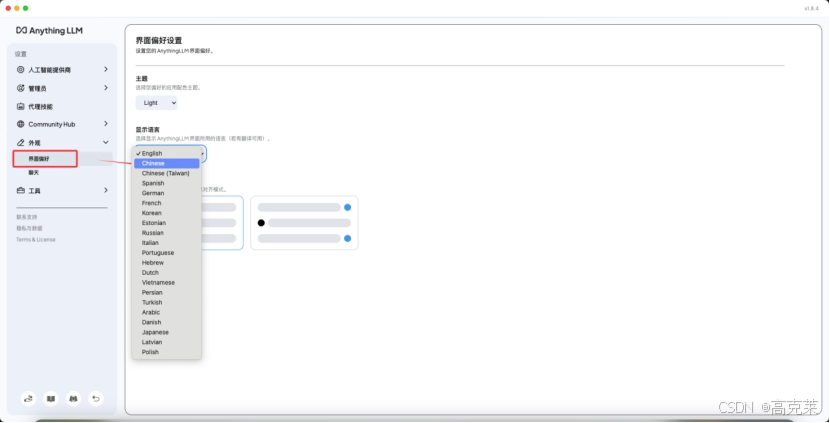
启动AnythingLLM,进入设置页面,将语言切换为中文
2.3 配置本地服务
配置本地ollama deepseek-r1:14b 大模型服务
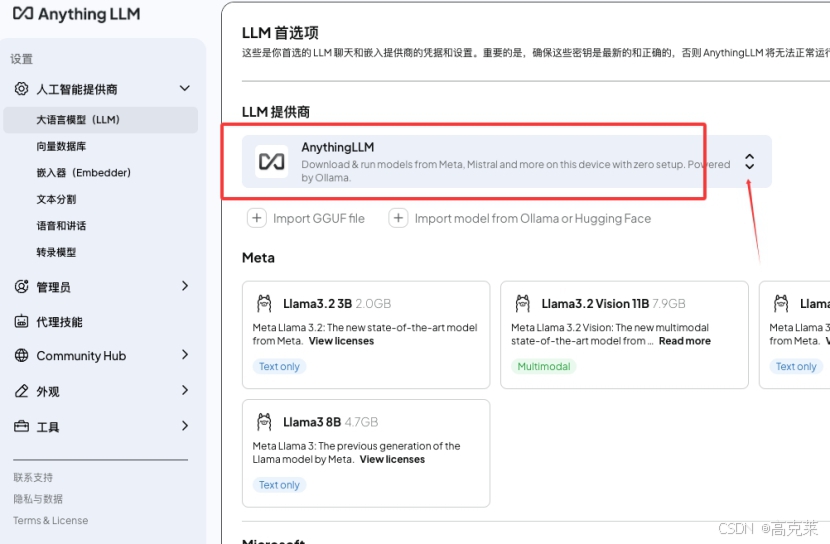
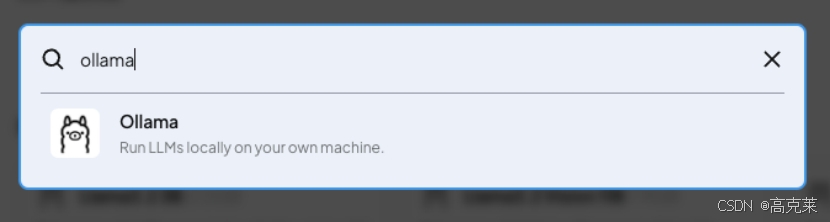
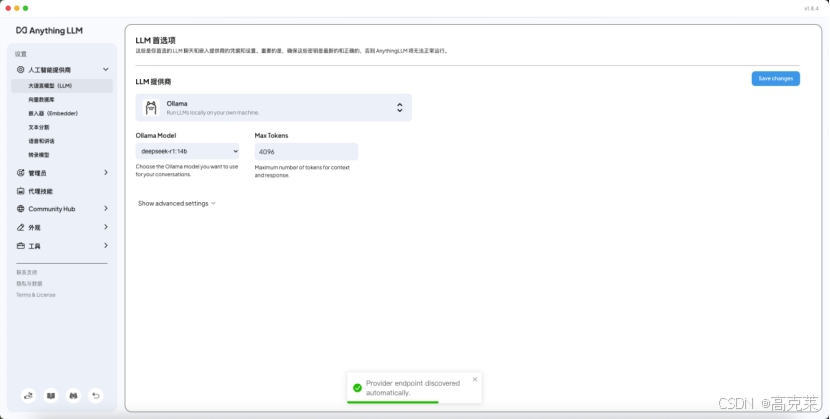
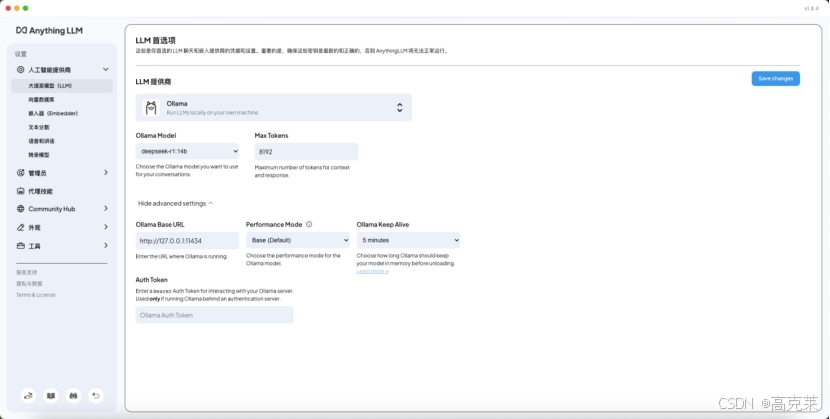
做好本地模型、tokens、url等配置
模型勾选ollama已部署的deepseek-r1:14b,tokens上调至8192,本地默认地址及端口为127.0.0.1:11434
完成后右上角 保存【Save changes】
3 构建RAG知识库
3.1 部署BGE-M3
在终端中执行部署BGE-M3 嵌入模型
ollama run bge-m3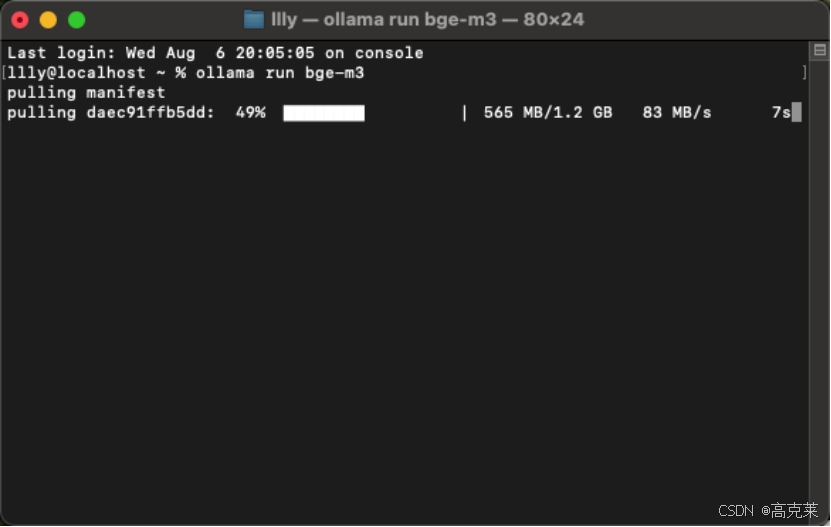
3.2 配置本地嵌入模型
在AnythingLLM 中配置本地嵌入模型,操作同2.3
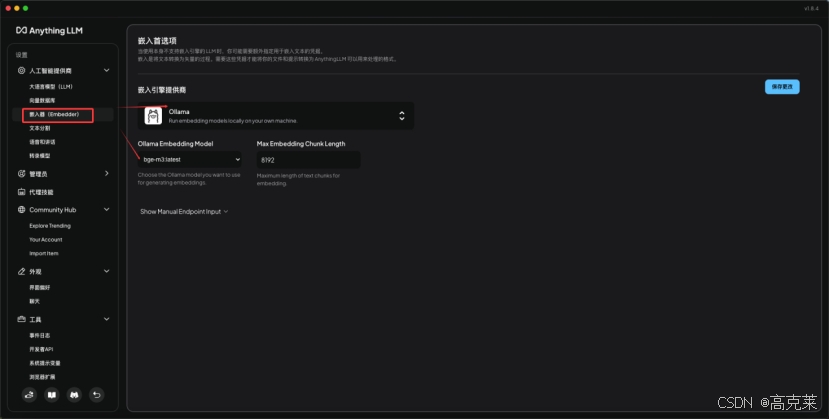
3.3 新建工作区
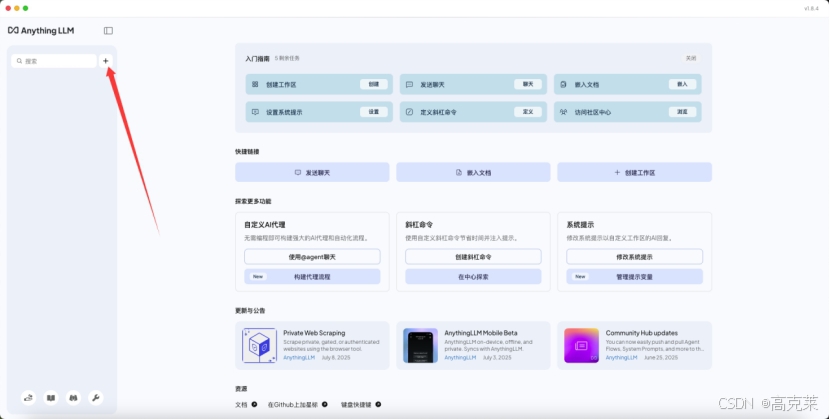
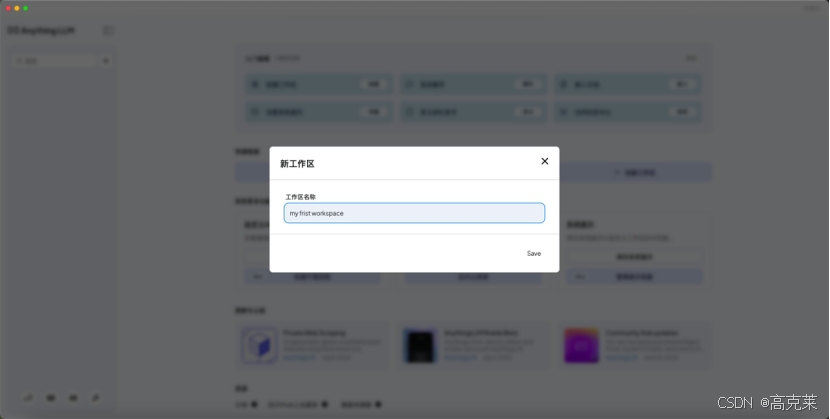
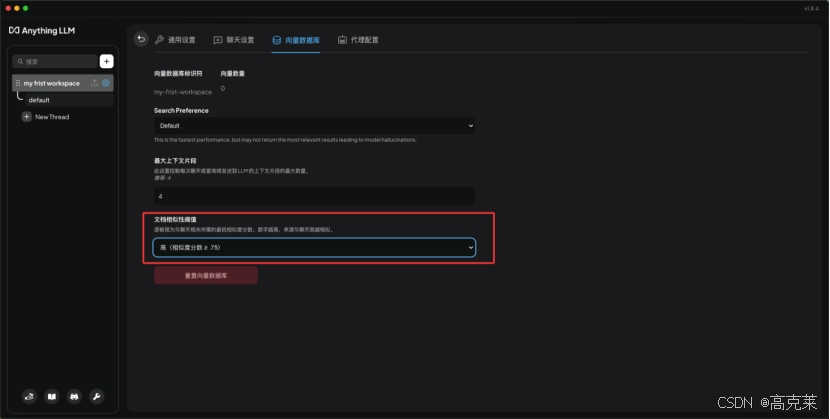
在新建的工作区(my first workspace)配置聊天设置和向量数据库
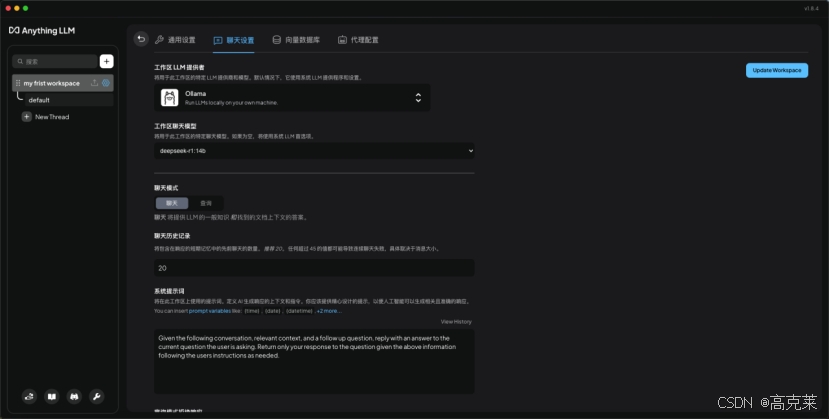
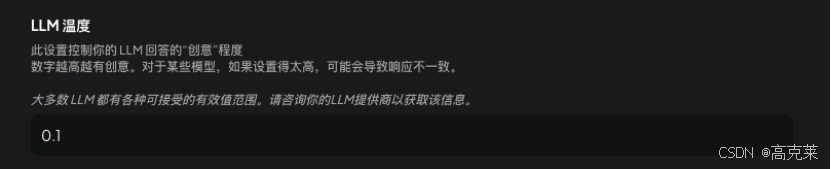
文档相似度阈值设置最高
3.4 上传文档
这里为了突显测试结果,创建了2个不同格式的文档。
txt文档内容为
高克莱是一个程序员,高克莱养了三只猫。word文档内容为
第一只猫叫可乐

第二只猫叫雪碧

第三只猫叫芬达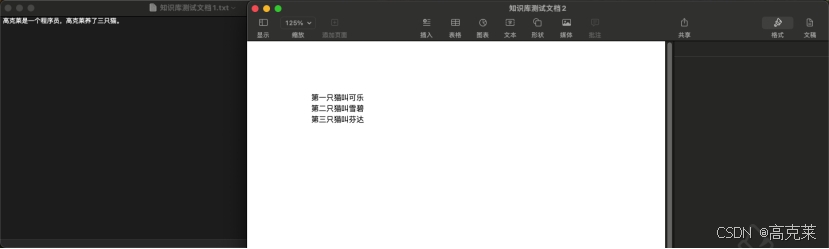
在工作区点击上传图标
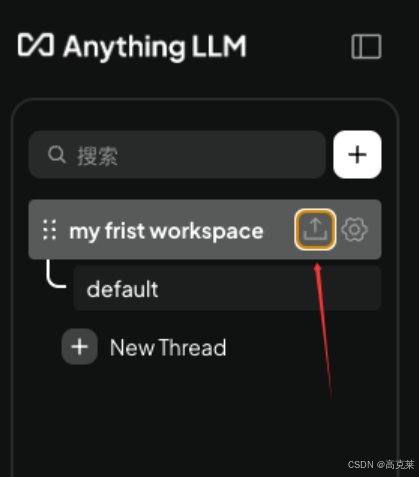
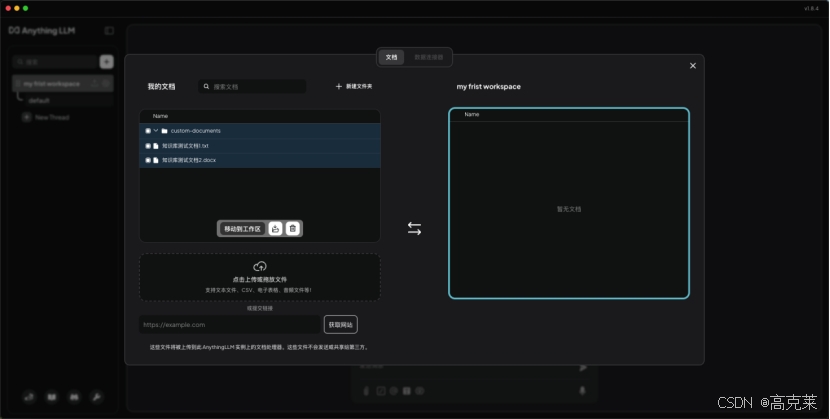
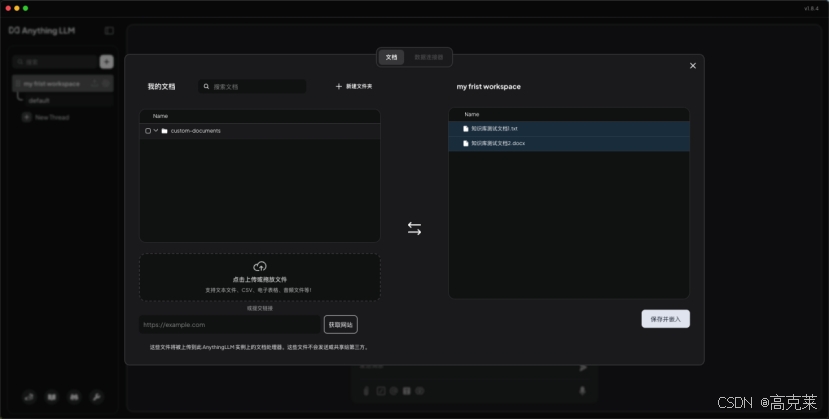
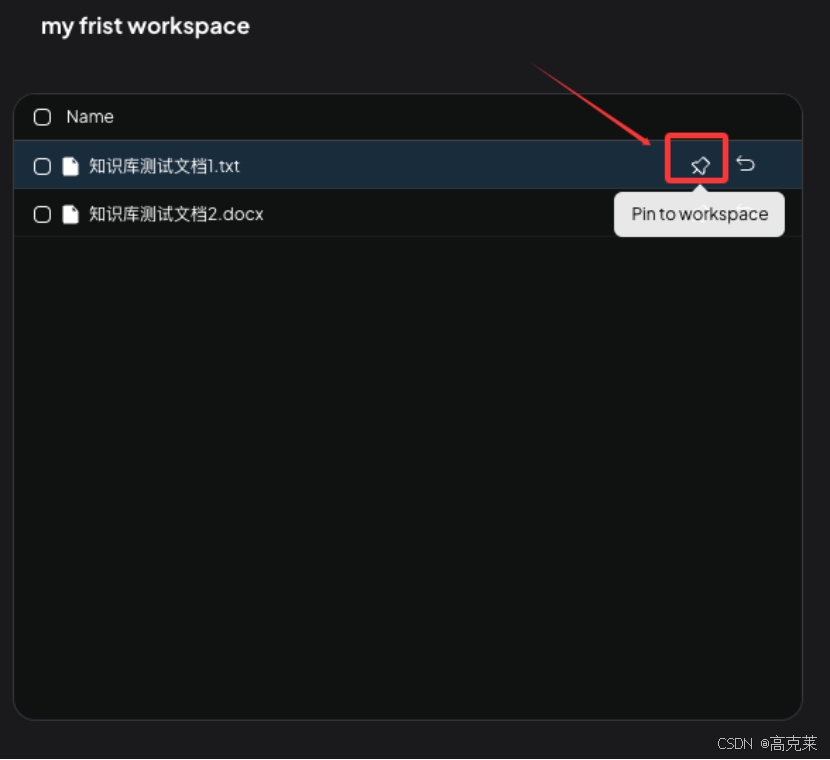
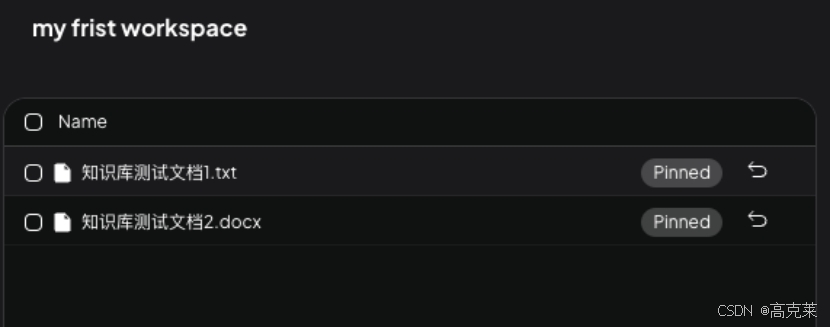
保存并嵌入后,务必要点击需要参与检索的文档右侧的【Pin to workspace】图标与当前工作区进行关联,这样大模型在检索生成回答内容时会优先参考该文档内容,如果未点击,则只是将文档存储到了全局库中,并不参与检索
3.5 测试对话
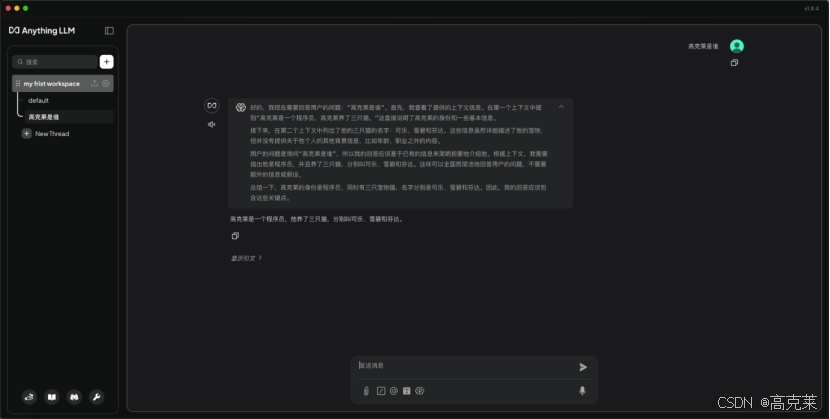
部署完成