简单场景:存在一个知识库,需要统计知识库下文件的个数
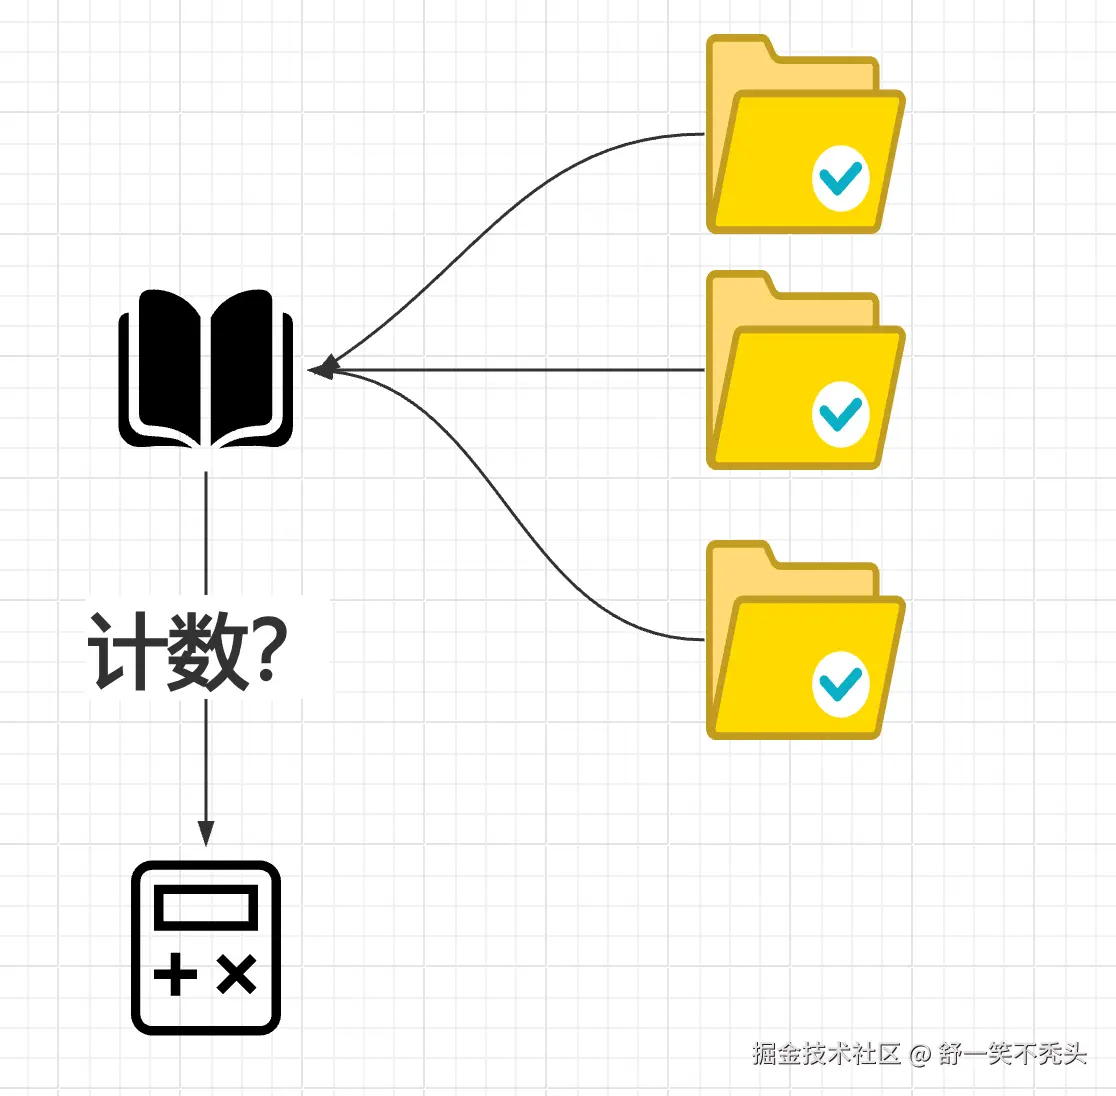
在这个场景中对知识库中文件计数还是比较简单可以实现,只需要进行对数据库查询时增加对知识库空间ID的筛查就可以实现
大致SQL查询语句
sql
        SELECT
            space_code as code,
            COUNT(*) AS code_count
        FROM
            kb_page
        WHERE
            type != 'FOLDER'
            AND status = 'PUBLISHED'
            AND tenant_id = #{tenantId}
            AND space_code IN
            <foreach collection="spaceCodesList" item="spaceCode" open="(" separator="," close=")">
                #{spaceCode}
            </foreach>
        GROUP BY
            space_code;
现在有一个新的场景,需要统计在每个知识库下,存在不同层级的文件夹📁,需要统计不同层级文件夹下文件的个数,如何进行实现?
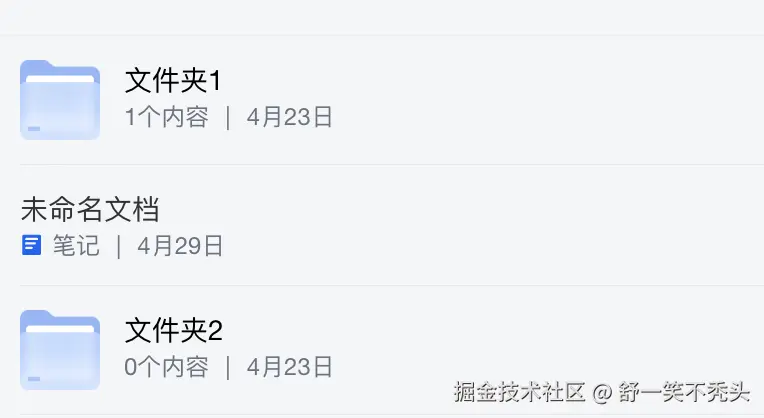
最开始考虑的是,文件夹能实现父子级别关联,数据库会存在一个code和parentCode进行关联。可以通过递归的方式进行深度检索,从而计算出不同文件夹下的文件个数。但是这个方案会存在性能问题,假如文件夹数量和层级众多,不是特别可行。
最终采取的计数方案是,数据库中存在一个对每一个文件都拥有一个全路径编码,不管当前文件的类型是word,excel,ppt,md等等等等。都会为其生成一个全路径编码,例如:1111,2222,3333,4444. 这个编码意味着当前该文件的级别是在第四级。
交代完上述的方案设计,如何进行代码层面的计数实现:
java
            for (PageTreeResp item : result) {
                if (PageTypes.FOLDER.name().equals(item.getType())) {
                    int fileCount = countFilesByFullParentCode(item.getCode(), item.getSpaceCode(), sysUserInfo.getTenantId());
                    item.setCodeCount(String.valueOf(fileCount));
                }
            }

## 具体的代码计算逻辑
   /**
     * 使用数据库 full_parent_code 统计文件夹下所有子孙文件数量(排除文件夹本身,type != FOLDER)
     * 保证同一租户、同一空间内统计。
     */
    private int countFilesByFullParentCode(String folderCode, String spaceCode, String tenantId) {
        LambdaQueryWrapper<KbPage> wrapper = new LambdaQueryWrapper<>();
        wrapper.eq(KbPage::getTenantId, tenantId);
        wrapper.eq(KbPage::getSpaceCode, spaceCode);
        wrapper.eq(KbPage::getStatus, KBPageStatus.PUBLISHED.name());
        // full_parent_code 中以逗号分隔父级编码,使用分隔符匹配避免误匹配
        wrapper.apply("INSTR(CONCAT(',', full_parent_code, ','), CONCAT(',', {0}, ',')) > 0", folderCode);
        // 只统计非文件夹类型
        wrapper.ne(KbPage::getType, KbPageTypes.FOLDER.name());
        return Math.toIntExact(kbPageMapper.selectCount(wrapper));
    }
上述查询逻辑的详细解析
一、先看整体 SQL 生成出来长什么样
假设
folderCode = "abc"
full_parent_code 里存的值是 "root,abc,xyz"
那么这一行最终被拼成:
sql
-- 伪 SQL
WHERE ...
  AND INSTR(CONCAT(',', full_parent_code, ','), ',abc,') > 0
二、为什么要这么写
- full_parent_code 存的是"从根到当前节点"的父节点编码,用英文逗号分隔,例如:
root,abc,xyz - 需求:找出"abc"这个文件夹下面的所有子孙节点(包括子文件夹里的文件)。
换句话说只要 full_parent_code 里出现过 abc 就算命中。 - 如果直接写简单的 LIKE '%abc%',当存在编码为 abc1、xabc 等节点时也会被错误匹配(模糊匹配会把包含子串的都选出来)。
- 因此把两端也补上逗号,再匹配 ",abc," 就能保证只匹配完整的一段编码,不会误伤。
三、函数拆解
-
CONCAT(',', full_parent_code, ',')
给原来的字符串前后各加一个逗号 → ",root,abc,xyz,"
-
CONSTR(',', {0}, ',')
把传入的 folderCode 前后也加逗号 → ",abc,"
-
INSTR(str, substr)
MySQL 内置函数:返回 substr 在 str 中第一次出现的位置(从 1 开始计数),找不到则返回 0。
-
INSTR(...) > 0
只要大于 0 就说明找到了,于是这条记录就是 folderCode 的子孙。
四、总结一句话
通过"前后补逗号再精确匹配"的技巧,避免了 LIKE 的模糊误差,从而可靠地判断某条记录的 full_parent_code 里是否包含指定的 folderCode,即该记录是否位于该文件夹之下。