写在前面
本文为《动手学深度学习v2》的学习笔记。本着自己学习、分享他人的态度,分享学习笔记,希望能对大家有所帮助。
本文为同步更新版本,文章格式可能存在问题,建议阅读以下版本:
 https://mp.weixin.qq.com/mp/appmsgalbum?__biz=MzkwMjM0MzA5MA==&action=getalbum&album_id=3180615146931748866#wechat_redirect
目录
-
2.4 微积分
-
2.4.1 导数和微分
-
2.4.2 偏导数
-
2.4.3 梯度
-
2.4.4 链式法则
-
-
2.5 自动微分
-
2.5.1 一个简单的例子
-
2.5.2 非标量变量的反向传播
-
2.5.3 分离计算
-
2.5.4 Python控制流的梯度计算
-
2.4 微积分
参考资料:
视频: https://www.bilibili.com/video/BV1eZ4y1w7PY
教材: https://zh.d2l.ai/chapter_preliminaries/calculus.html#sec-calculus
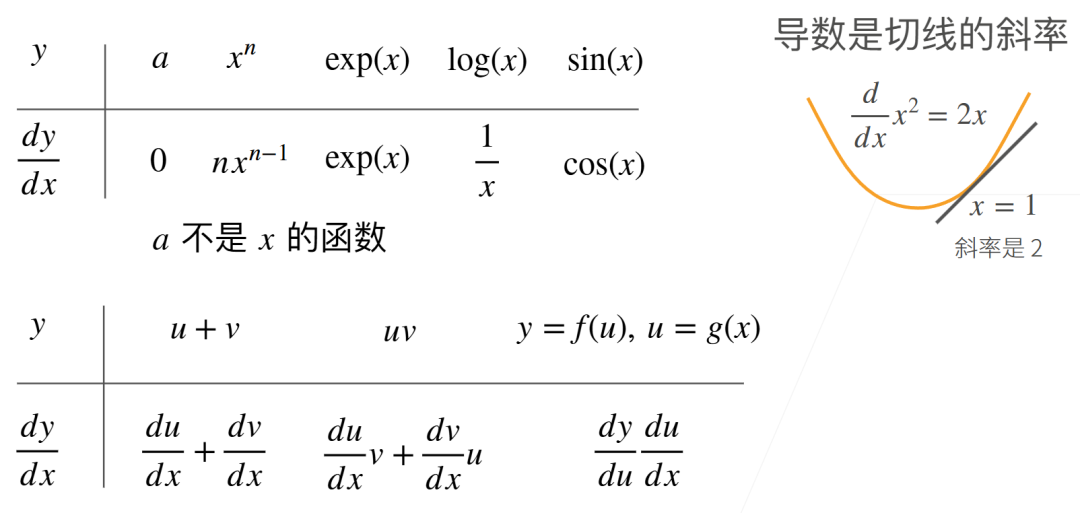
标量导数:
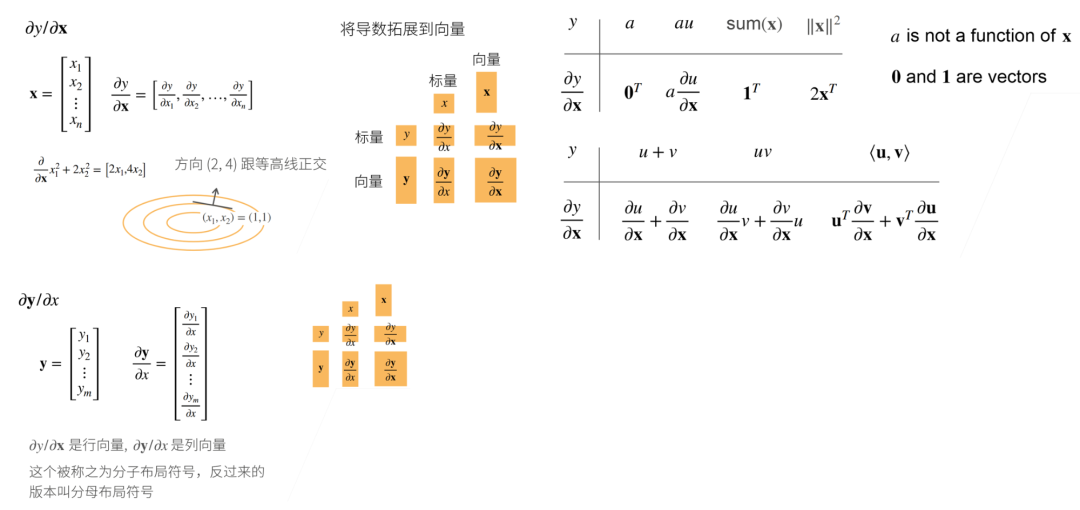
向量导数:
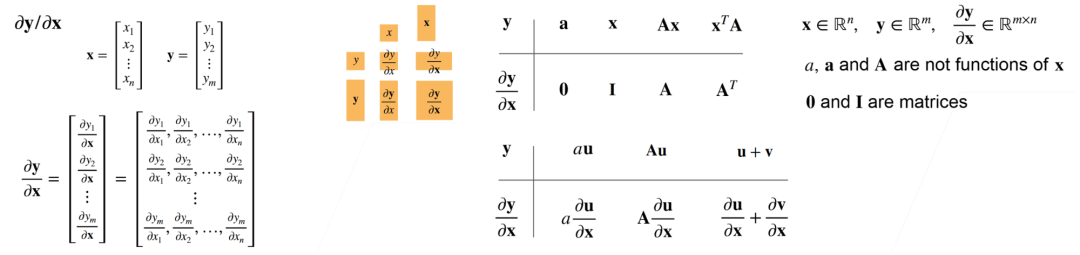
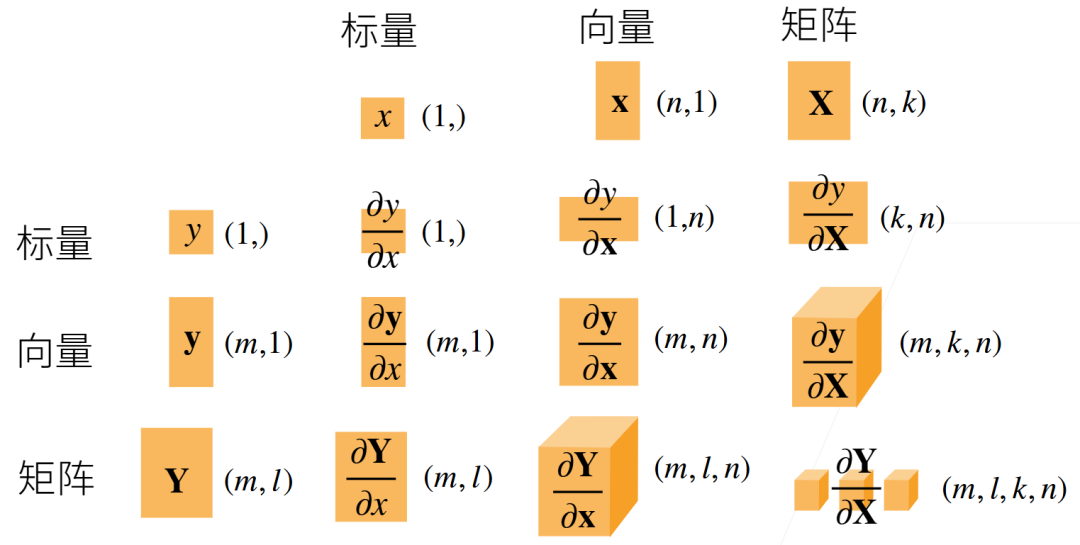
矩阵导数:
2.4.1 导数和微分
假设我们有一个函数 ,其输入和输出都是标量。如果 的导数存在,这个极限被定义为
如果 存在,则称 在 处是**可微(differentiable)**的。
对于导数的表示,以下是等价的:
2.4.2 偏导数
设 是一个具有 个变量的函数。 关于第 个参数 的**偏导数(partial derivative)**为:
为了计算 ,我们可以简单地将 看作常数,并计算 关于 的导数。对于偏导数的表示,以下是等价的:
2.4.3 梯度
我们可以连结一个多元函数对其所有变量的偏导数,以得到该函数的**梯度(gradient)**向量。 具体而言,设函数 的输入是一个 维向量 ,并且输出是一个标量。函数 相对于 的梯度是一个包含 个偏导数的向量:
其中 通常在没有歧义时被 取代。
2.4.4 链式法则
链式法则可以被用来微分复合函数。
让我们先考虑单变量函数。假设函数 和 都是可微的,根据链式法则:
现在考虑一个更一般的场景,即函数具有任意数量的变量的情况。假设可微分函数 有变量 ,其中每个可微分函数 都有变量 。注意, 是 , 的函数。对于任意 ,链式法则给出:
2.5 自动微分
参考资料:
视频: https://www.bilibili.com/video/BV1KA411N7Px
教材: https://zh.d2l.ai/chapter_preliminaries/autograd.html#sec-autograd
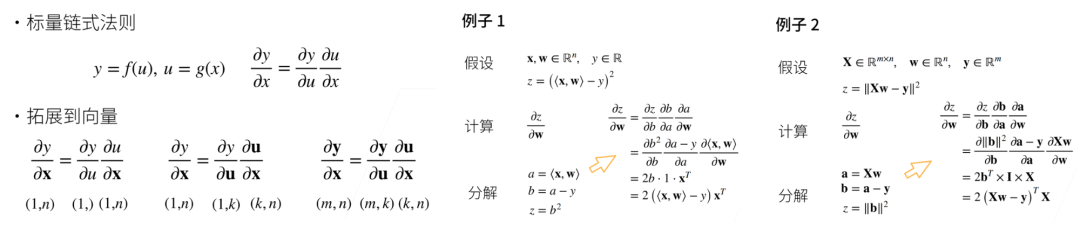
向量链式法则:
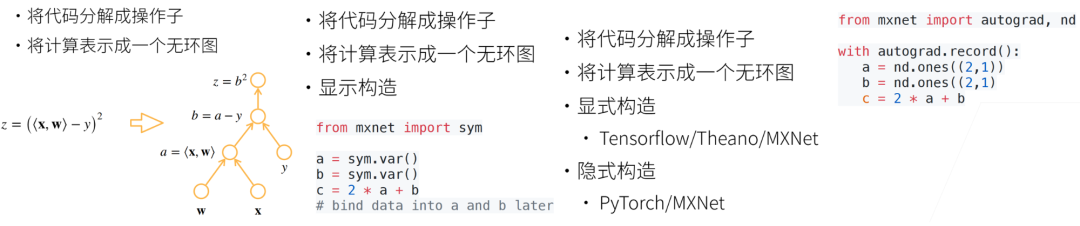
计算图:
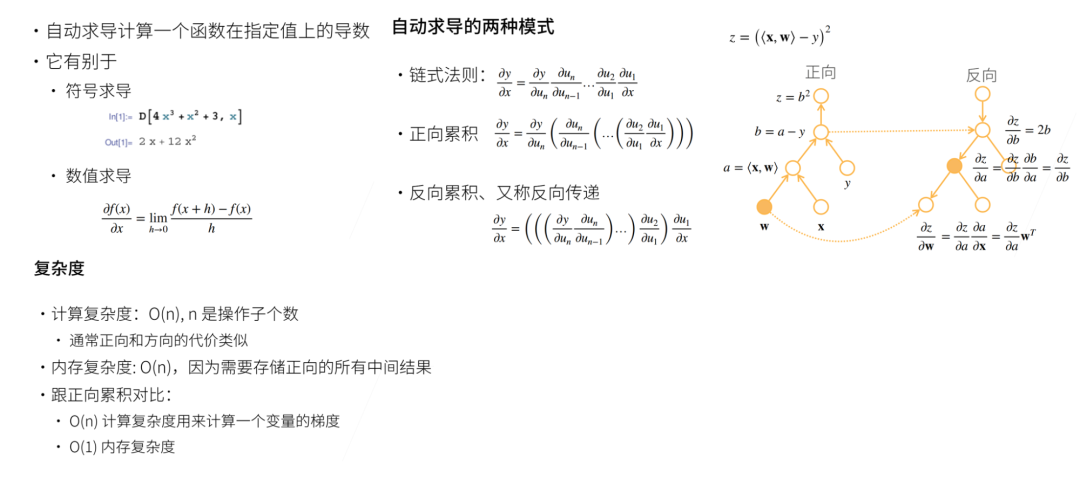
自动求导:
2.5.1 一个简单的例子
假设我们想对函数 关于列向量 求导
首先,我们创建变量x并为其分配一个初始值。
import torch

x = torch.arange(4.0)
x
# tensor([0., 1., 2., 3.])
在我们计算 关于 的梯度之前,需要一个地方来存储梯度。
x.requires_grad_(True)  # 等价于 x=torch.arange(4.0,requires_grad=True)
x.grad  # 默认值是 None
现在计算 ,x是一个长度为4的向量,计算x和x的点积,得到了我们赋值给y的标量输出。
y = 2 * torch.dot(x, x)
y
# tensor(28., grad_fn=<MulBackward0>)
通过调用反向传播函数 backward() 来自动计算y关于x每个分量的梯度
y.backward()
x.grad
# tensor([ 0.,  4.,  8., 12.])
函数 关于 的梯度应为 。让我们快速验证这个梯度是否计算正确。
x.grad == 4 * x
# tensor([True, True, True, True])
现在计算x的另一个函数。
# 在默认情况下,PyTorch会累积梯度,我们需要清除之前的值
x.grad.zero_()
y = x.sum()
y.backward()
x.grad
# tensor([1., 1., 1., 1.])
2.5.2 非标量变量的反向传播
深度学习中,我们的目的不是计算微分矩阵,而是单独计算批量中每个样本的偏导数之和。
# 对非标量调用backward需要传入一个gradient参数,该参数指定微分函数关于self的梯度。
# 本例只想求偏导数的和,所以传递一个1的梯度是合适的
x.grad.zero_()
y = x * x
# 等价于y.backward(torch.ones(len(x)))
y.sum().backward()
x.grad

# tensor([0., 2., 4., 6.])
2.5.3 分离计算
将某些计算移动到记录的计算图之外
x.grad.zero_()
y = x * x
u = y.detach()
z = u * x

z.sum().backward()
x.grad == u

# tensor([True, True, True, True])由于记录了y的计算结果,我们可以随后在y上调用反向传播,得到y=x*x关于的x的导数,即2*x。
x.grad.zero_()
y.sum().backward()
x.grad == 2 * x

# tensor([True, True, True, True])
2.5.4 Python控制流的梯度计算
即使构建函数的计算图需要通过Python控制流(例如,条件、循环或任意函数调用),我们仍然可以计算得到的变量的梯度
deff(a):
    b = a * 2
while b.norm() < 1000:
        b = b * 2
if b.sum() > 0:
        c = b
else:
        c = 100 * b
return c

a = torch.randn(size=(), requires_grad=True)
d = f(a)
d.backward()

a.grad == d / a
# tensor(True)
--------------- 结束 ---------------
注:本文为个人学习笔记,仅供大家参考学习,不得用于任何商业目的。如有侵权,请联系作者删除。