目录
[为什么 GBM 适合做特征选择](#为什么 GBM 适合做特征选择)
[GBFS 的一般步骤](#GBFS 的一般步骤)
什么是梯度增强特征选择(GBFS)
GBFS 并非一个像 Lasso 或随机森林那样有严格标准定义的独立算法,而是一种基于梯度提升机(Gradient Boosting Machine, GBM)模型来进行特征选择的思想和策略。
其核心思想是:利用训练好的 GBM 模型(如 XGBoost, LightGBM, CatBoost)内置的特征重要性评分,来识别并选择对预测目标最重要的特征子集
为什么 GBM 适合做特征选择
-
内置的特征重要性(Feature Importance):大多数 GBM 实现都会自动计算特征重要性。最常见的两种计算方式是:
- 基于分裂(Gain): 衡量一个特征在所有树中被用于分裂时,所带来的不纯度(如基尼系数、均方误差)减少的总和。这是最常用、最可靠的指标。
- 基于频率(Frequency): 衡量一个特征在所有树中被用作分裂点的次数。
-
强大的非线性拟合能力:GBM 能够捕捉特征与目标之间复杂的非线性关系和交互效应,因此其评估出的特征重要性比一些线性模型(如 Lasso)更全面。
-
抗过拟合和鲁棒性:通过集成多棵弱学习器(树),GBM 对噪声数据相对鲁棒,其给出的特征重要性排序也更为稳定
GBFS 的一般步骤
- 训练一个 GBM 模型 :使用全部特征在训练集上训练一个梯度提升模型(如
XGBRegressor或LGBMClassifier)。 - 获取特征重要性:从训练好的模型中提取每个特征的重要性分数。
- 排序和选择:将特征按重要性分数从高到低排序。
- 确定阈值:选择一个阈值来选择特征。方法有:
- 选择 Top-K 个特征:例如,只保留最重要的前 20 个特征。
- 重要性分数阈值:例如,只保留重要性分数大于平均值的特征。
- 递归消除:结合递归特征消除(RFE),逐步剔除最不重要的特征,通过交叉验证来确定最佳特征数量
代码示例
python
# 导入必要的库
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from xgboost import XGBClassifier

# 1. 加载数据
data = load_breast_cancer()
X, y = data.data, data.target
feature_names = data.feature_names

# 查看数据形状
print("原始特征维度:", X.shape)  # (569, 30)

# 2. 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 3. 训练一个XGBoost模型(使用所有特征)
model = XGBClassifier(random_state=42, use_label_encoder=False, eval_metric='logloss')
model.fit(X_train, y_train)

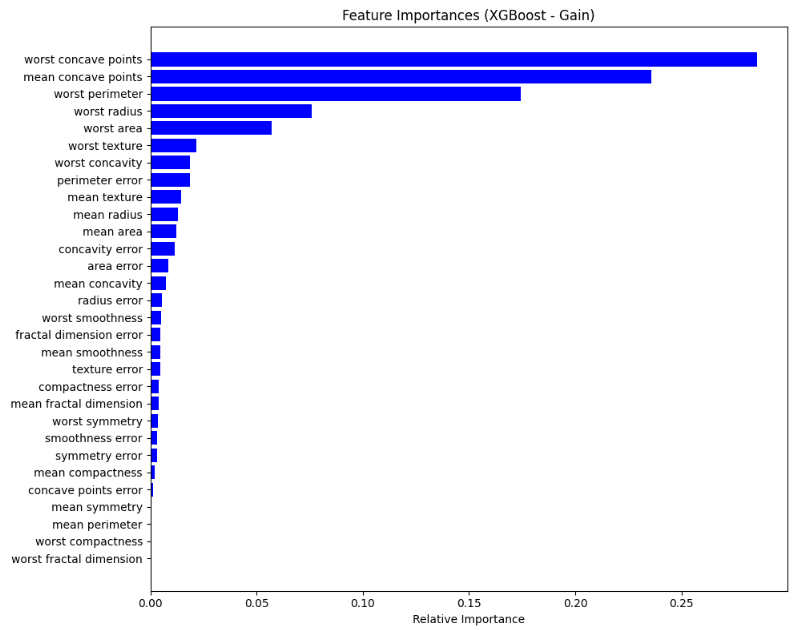
# 4. 获取特征重要性(基于Gain)
importance_scores = model.feature_importances_
# 创建一个(特征名:重要性分数)的字典,并排序
feat_imp_dict = dict(zip(feature_names, importance_scores))
sorted_feat_imp = sorted(feat_imp_dict.items(), key=lambda x: x[1], reverse=True)

# 打印最重要的10个特征
print("\n最重要的10个特征:")
for feat, imp in sorted_feat_imp[:10]:
    print(f"{feat}: {imp:.4f}")
# worst concave points: 0.2856
# mean concave points: 0.2357
# worst perimeter: 0.1743
# worst radius: 0.0760
# worst area: 0.0570
# worst texture: 0.0217
# worst concavity: 0.0187
# perimeter error: 0.0186
# mean texture: 0.0144
# mean radius: 0.0128


# 5. 可视化特征重要性(可选)
plt.figure(figsize=(10, 8))
indices = np.argsort(importance_scores)[::-1] # 按重要性降序排列的索引
plt.title('Feature Importances (XGBoost - Gain)')
plt.barh(range(len(indices)), importance_scores[indices], color='b', align='center')
plt.yticks(range(len(indices)), [feature_names[i] for i in indices])
plt.xlabel('Relative Importance')
plt.gca().invert_yaxis() # 让最重要的特征显示在顶部
plt.tight_layout()
plt.show()

# 6. 进行特征选择:我们选择最重要的前10个特征
top_k = 10
selected_feature_indices = indices[:top_k] # 获取最重要特征的索引

X_train_selected = X_train[:, selected_feature_indices]
X_test_selected = X_test[:, selected_feature_indices]

print(f"\n选择后的特征维度:{X_train_selected.shape}")  # (455, 10)

# 7. 使用选择后的特征重新训练模型,验证效果
model_selected = XGBClassifier(random_state=42, use_label_encoder=False, eval_metric='logloss')
model_selected.fit(X_train_selected, y_train)

# 预测
y_pred_full = model.predict(X_test)
y_pred_selected = model_selected.predict(X_test_selected)

# 评估准确率
acc_full = accuracy_score(y_test, y_pred_full)
acc_selected = accuracy_score(y_test, y_pred_selected)

print(f"\n模型性能对比:")
print(f"使用所有特征的测试集准确率: {acc_full:.4f}")  # 0.9561
print(f"使用Top-{top_k}个特征的测试集准确率: {acc_selected:.4f}")  # 0.9561