解决AI幻觉,只能死磕模型?OpenAI给出不一样的思路

大家应该都被 AI 坑过:

问它一些不懂的问题,它并不会告诉你它不会,而是给你编造一个看起来非常靠谱的答案,语气笃定、结构完整,但实际上,全都是无中生有。

这就是当前这波大模型 AI 最显著的一个问题------幻觉。
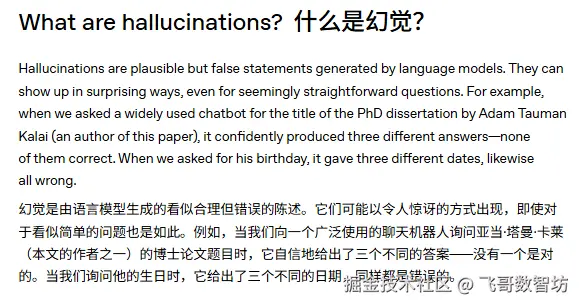
最近,OpenAI 发布了一篇论文,专门解释了 AI 为什么爱瞎编。其中的思路和例子都特别直观,忍不住想给大家分享一下。

简单概括,就是模型评价的激励方式,错误地导致模型为了更高的激励,去猜测答案。

文中举了一个猜生日的例子:

假设问 AI 张三的生日(它并不知道),如果 AI 猜测,那就会有 1/365 的概率猜对,但如果回答"不知道",那铁定不会正确。
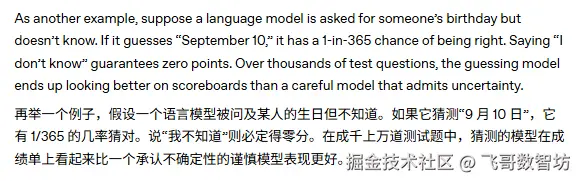
经过成千上万道类似的评价题目后,聪明的 AI 很快就 get 到:

"猜,可能赢;不猜,一定输。"

甚至,越聪明的模型,越容易领悟到这个准则,然后越容易出现"幻觉"问题,比如,DeepSeek。

同时,Open AI 也提出了一个解决方法,"对自信的错误进行比不确定性更重的惩罚",以此引导模型更加的务实和可靠。

思路其实挺简单的,但这个简单的思路却非常有效,毕竟 GPT-5 都已经从写作高手变成编程高手了。
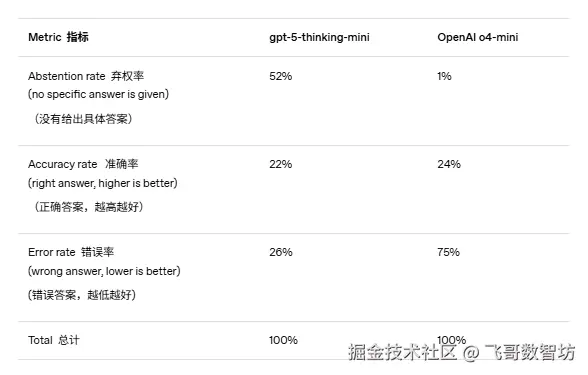
这个思路不仅训练 AI 时可以采用,我们使用 AI 时,也可以尝试利用一下。

比如,在提示词里加一句:

"如果不确定,请告诉我'不知道'。"

你会发现 ------ AI 更稳更靠谱了~

相关推荐
论文复现现场1 小时前
8卡4090能跑70B吗?Llama-2显存预算、QLoRA与通信瓶颈
人工智能·深度学习·分布式训练·llama·显存·qlora·算家云
酷虎软件2 小时前
如何用AI创作AI歌曲AI音乐
人工智能
小宋10212 小时前
A2UI从零实战:Agent安全生成交互界面与事件回传
javascript·人工智能·安全·交互
罗小罗同学2 小时前
谷歌团队在Nat Med最新发表的医学多模态模型,4B参数的模型性能逼近671B的DeepSeek
人工智能·医学图像处理·医工交叉·医学ai
GlobalInfo2 小时前
2026年推理算力超越训练算力,市场调研该关注什么
大数据·人工智能·ai·芯片
JavaGuide2 小时前
最近爆火的 Muse 浙大开源版 nanoMuse,来了!
aigc·openai·ai编程
陈然信息站2 小时前
PCB覆膜检测场景下明治ESE-10N色标传感器技术适配性分析
人工智能
阿里云大数据AI技术2 小时前
阿里云 Milvus 自研内核 EAGLE 发布:向量检索的SOTA,我们决定自己造
人工智能
码流子2 小时前
04-AI标注系统
人工智能
心易行者2 小时前
Agent应用+API端点商业化进阶实战:从单体智能体到可付费调用的API全流程
运维·服务器·人工智能·python·apache