首先说一下,这里解决的问题应用场景:
sparksql处理Hive表数据时,判断加载的是否是分区表,以及分区表的字段有哪些?再进一步限制查询分区表必须指定分区?
这里涉及到两种情况:select SQL查询和加载Hive表路径的方式。这里仅就"加载Hive表路径的方式"解析分区表字段,在处理时出现的一些问题及解决作出详细说明。
如果大家有类似的需求,笔者建议通过解析Spark SQL logical plan和下面说的这种方式解决方案结合,封装成一个通用的工具。
问题现象
sparksql加载指定Hive分区表路径,生成的DataSet没有分区字段。如:
sparkSession.read.format("parquet").load(s"${hive_path}"),hive_path为Hive分区表在HDFS上的存储路径。
hive_path的几种指定方式会导致这种情况的发生(test_partition是一个Hive外部分区表,dt是它的分区字段,分区数据有dt为20200101和20200102):
1.hive_path为"/spark/dw/test.db/test_partition/dt=20200101"
2.hive_path为"/spark/dw/test.db/test_partition/*"
因为牵涉到的源码比较多,这里仅以示例的程序中涉及到的源码中的class、object和方法,绘制成xmind图如下,想细心研究的可以参考该图到spark源码中进行分析。

问题分析
我这里主要给出几个源码段,结合上述xmind图理解:
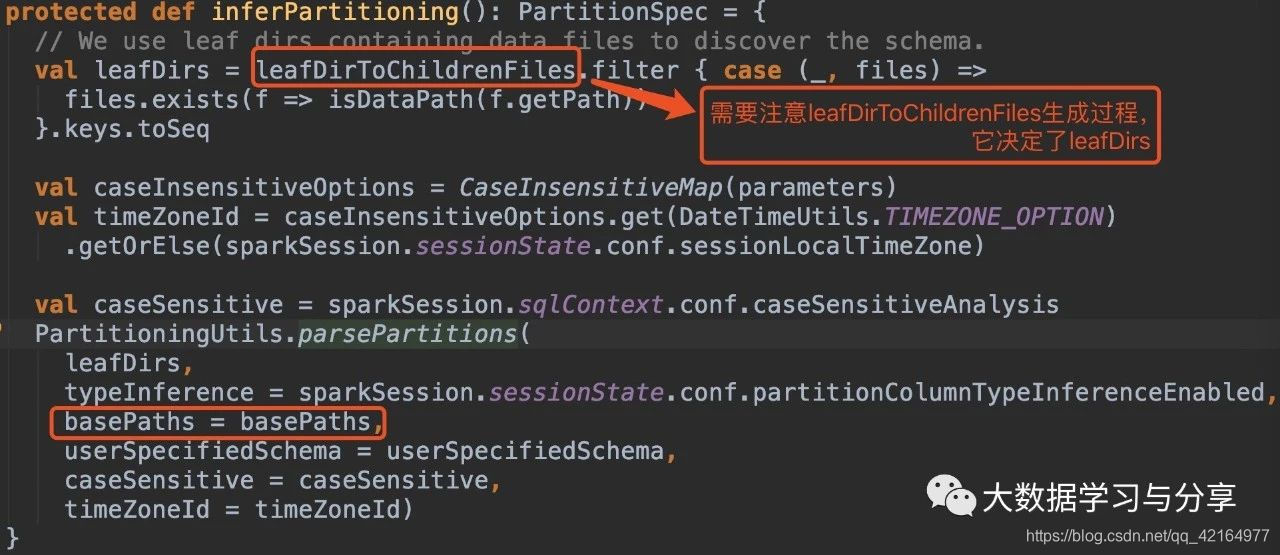
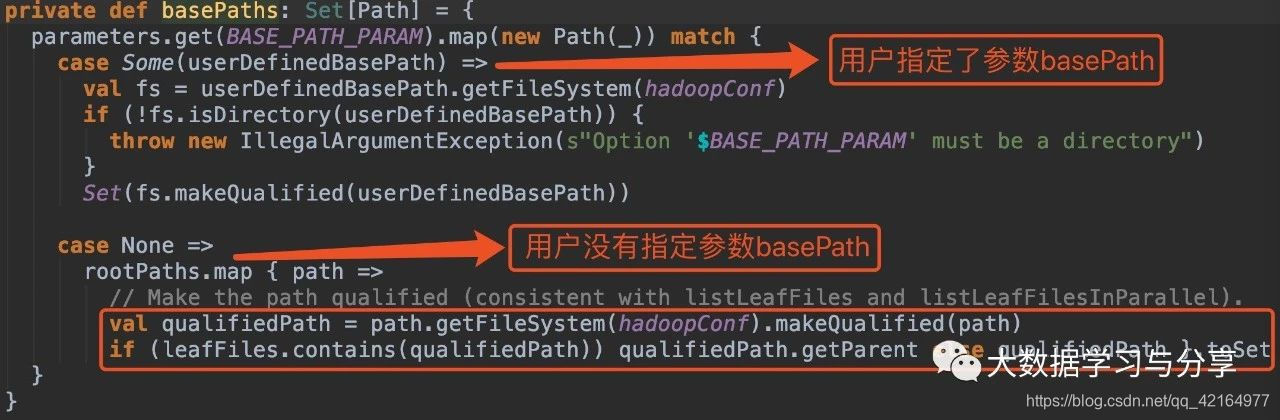
在没有指定参数basePath的情况下:
1.hive_path为/spark/dw/test.db/test_partition/dt=20200101
bash
sparksql底层处理后得到的basePaths: Set(new Path("/spark/dw/test.db/test_partition/dt=20200101"))【伪代码】

leafDirs: Seq(new Path("/spark/dw/test.db/test_partition/dt=20200101"))【伪代码】
2.hive_path为/spark/dw/test.db/test_partition/*
bash
sparksql底层处理后得到的basePaths: Set(new Path("/spark/dw/test.db/test_partition/dt=20200101"),new Path("/spark/dw/test.db/test_partition/dt=20200102"))【伪代码】

leafDirs: Seq(new Path("/spark/dw/test.db/test_partition/dt=20200101"),new Path("/spark/dw/test.db/test_partition/dt=20200102"))【伪代码】
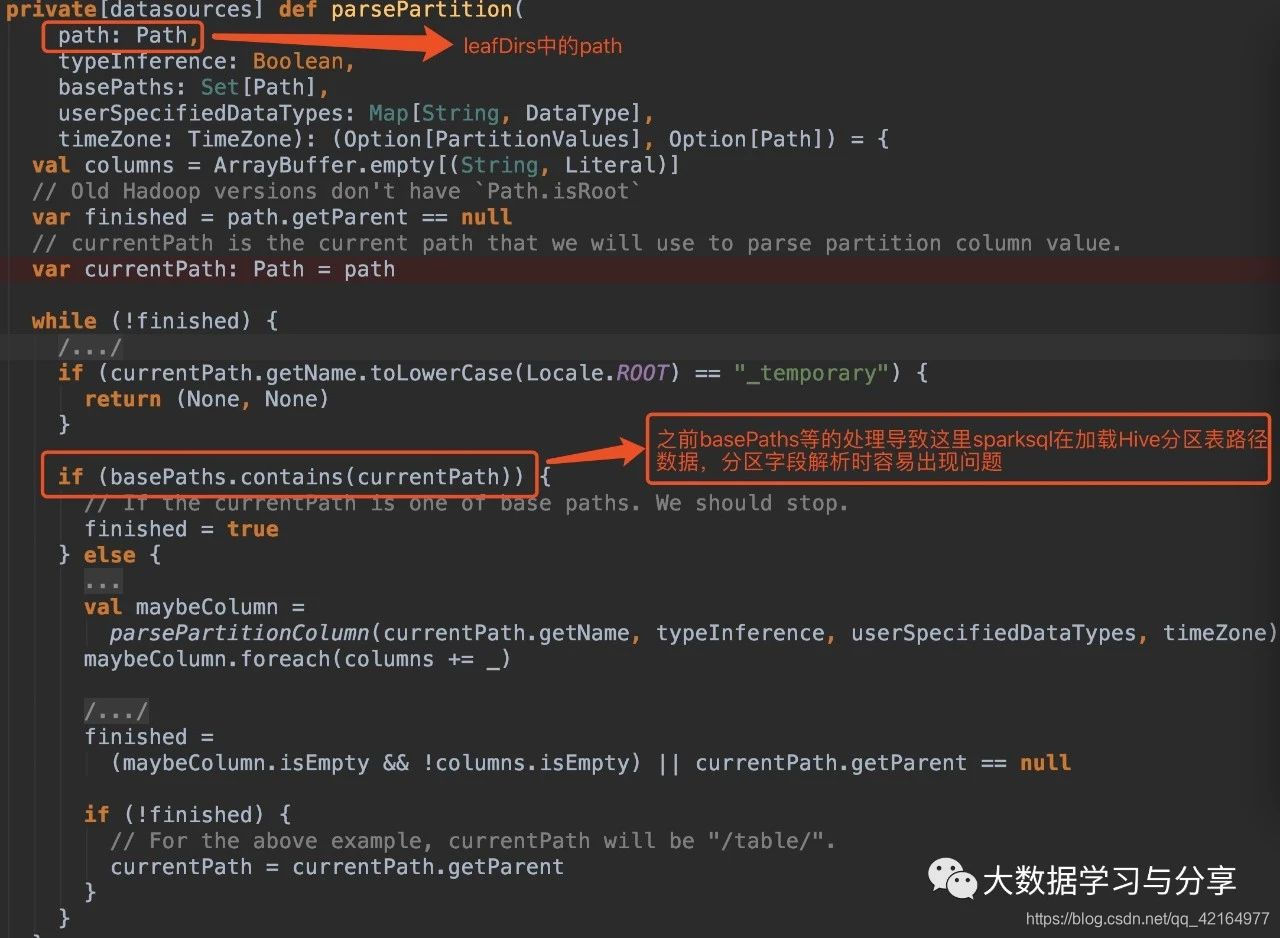
这两种情况导致源码if(basePaths.contains(currentPath))为true,还没有解析分区就重置变量finished为true跳出循环,因此最终生成的结果也就没有分区字段:
解决方案(亲测有效)
1.在Spark SQL加载Hive表数据路径时,指定参数basePath,如
sparkSession.read.option("basePath","/spark/dw/test.db/test_partition")
2.主要重写basePaths方法和parsePartition方法中的处理逻辑,同时需要修改其他涉及的代码。由于涉及需要改写的代码比较多,可以封装成工具。
更多干货抢先看 : 大数据技术干货汇总 ------ 助力迎接复杂多变且充满机遇的2025