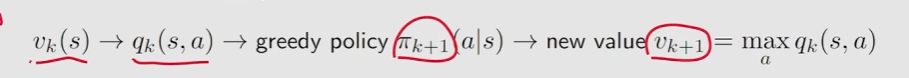强化学习原理(二)

一、贝尔曼最优公式(BOE)

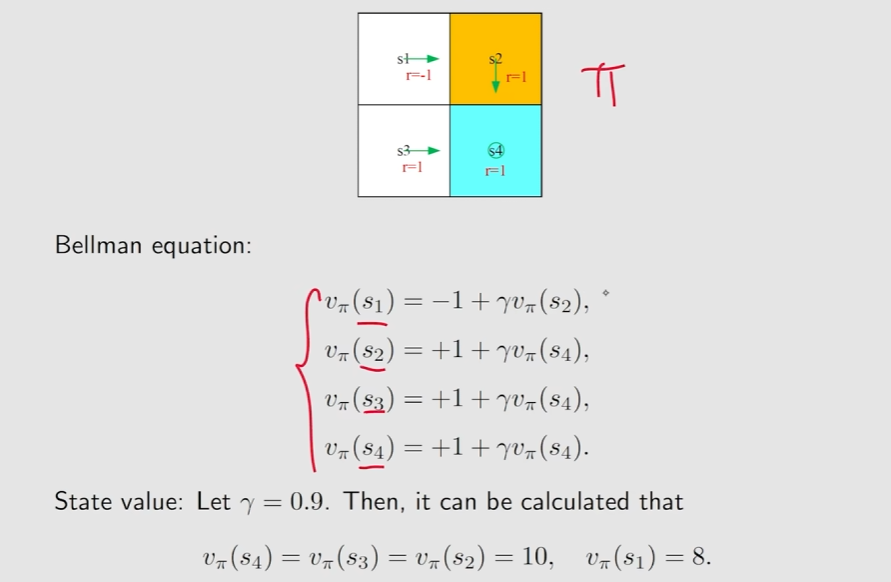
Motivating examples:
贝尔曼最优公式:
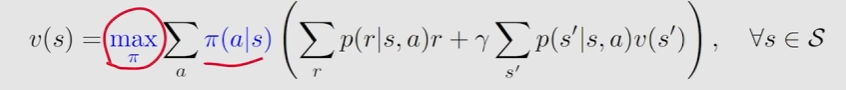
贝尔曼最优公式(矩阵向量形式):
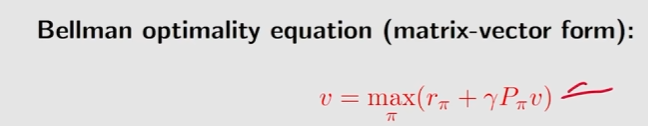
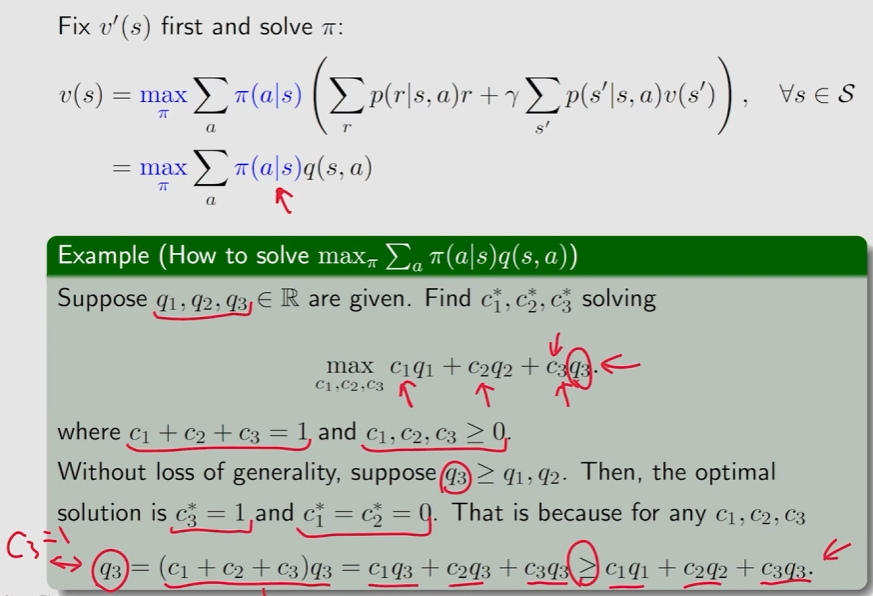
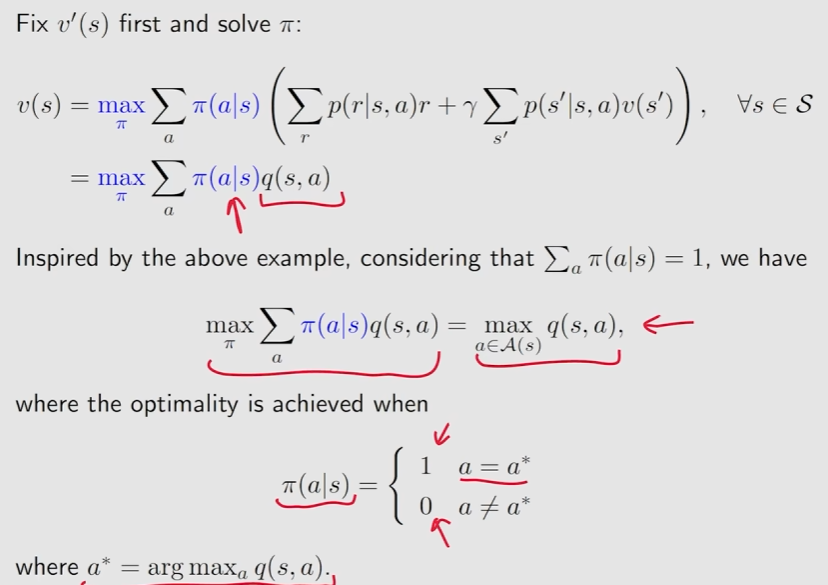
求解贝尔曼最优公式:
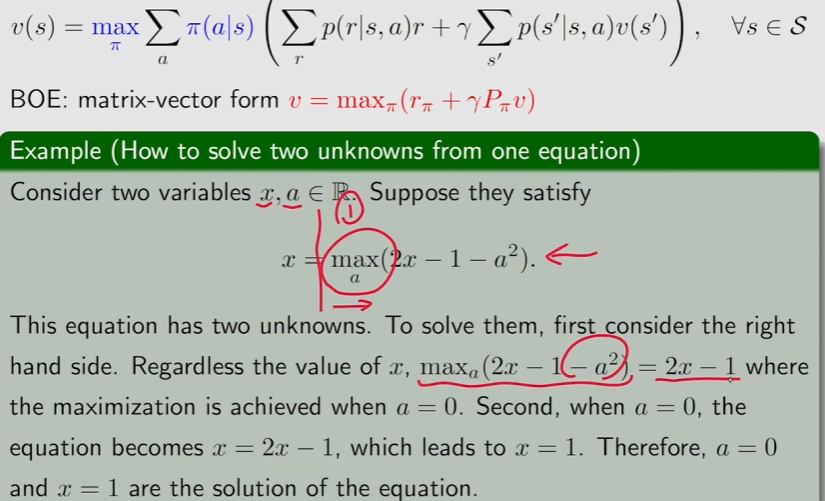
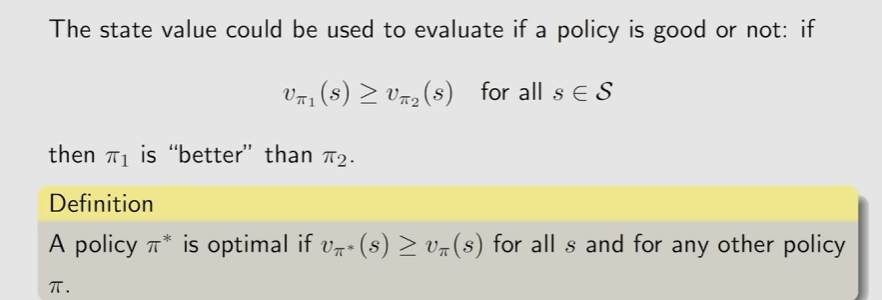
贝尔曼公式求解以及最优性:

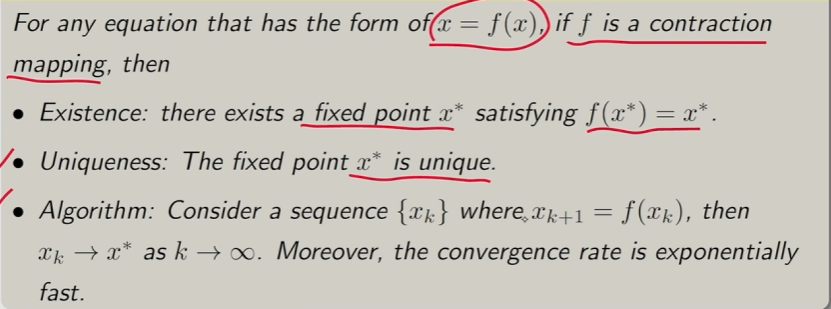
**Fixed point:**f(x) = x

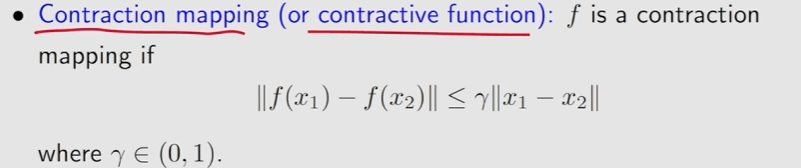
Contraction mapping:
Contraction mapping Theorem:
二、值迭代与策略迭代

值迭代算法:
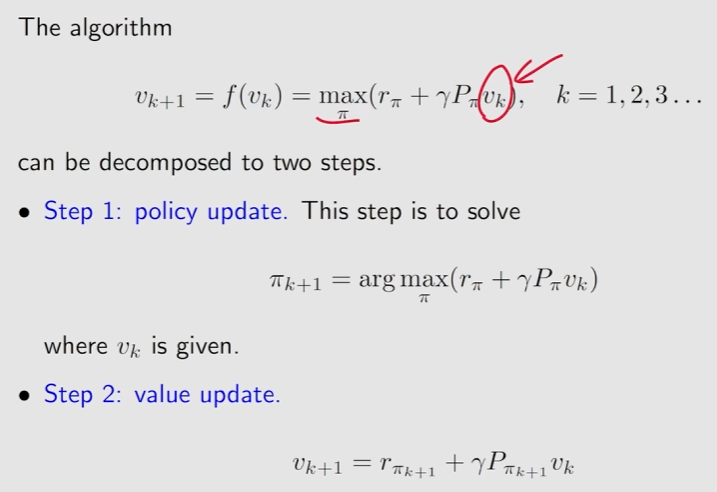
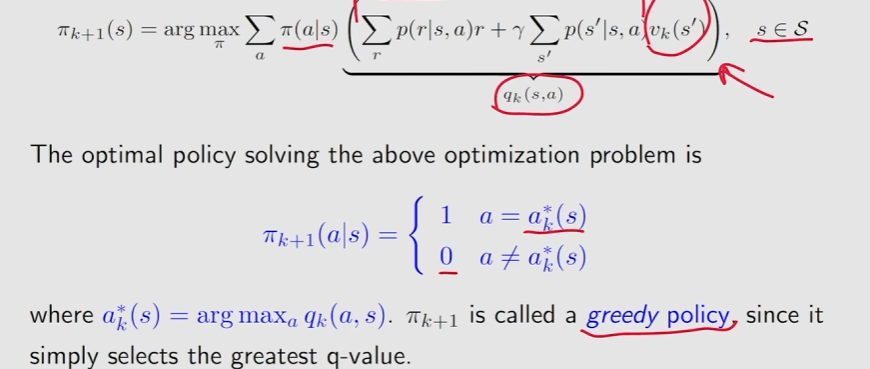
① Policy update
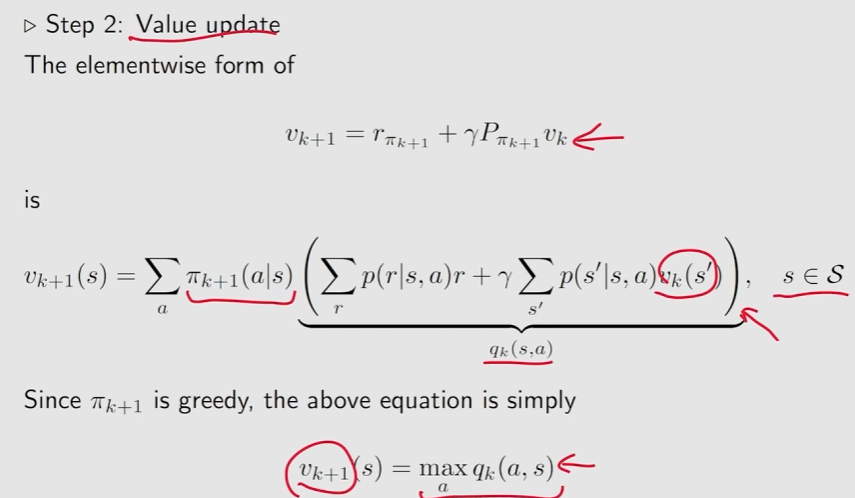
② Value update
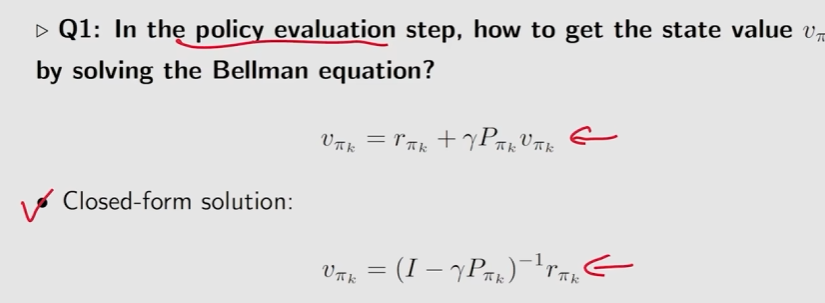
策略迭代算法:
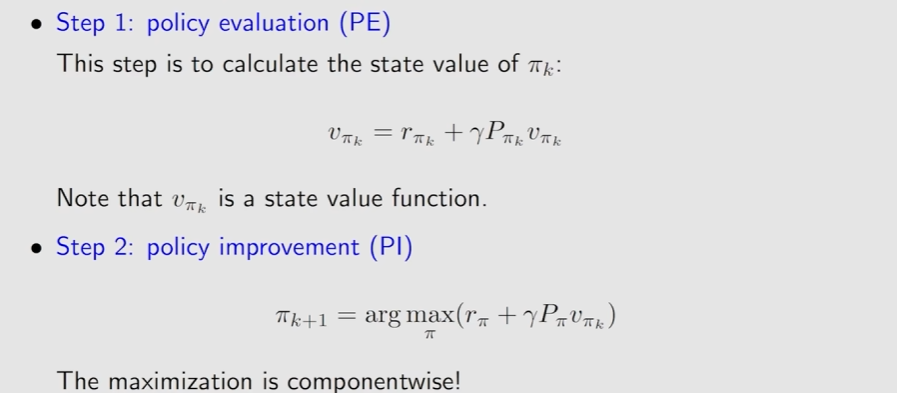
① policy evaluation:
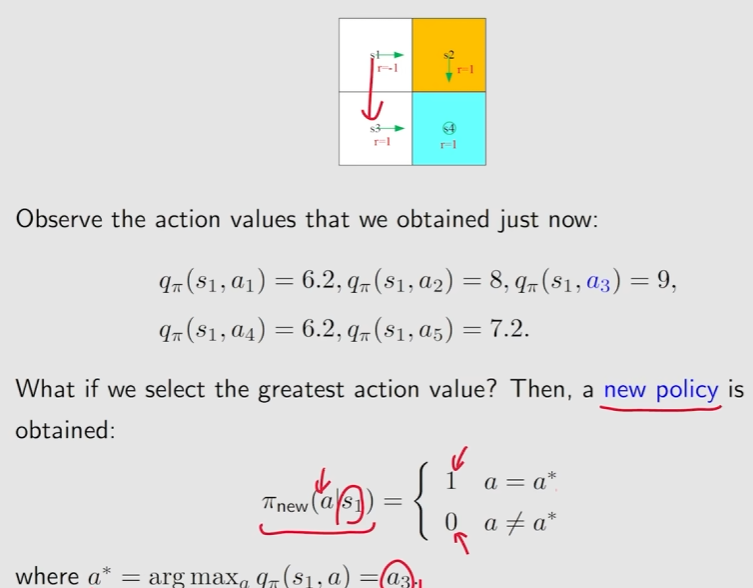
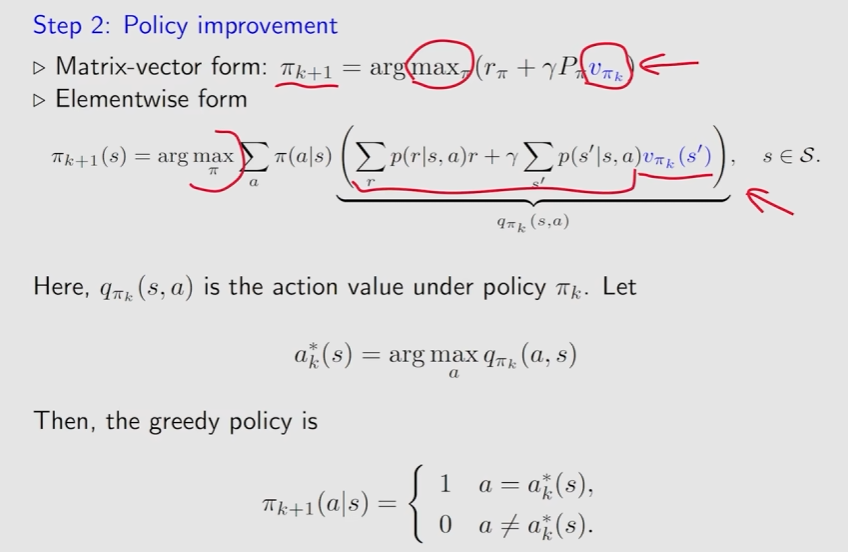
② policy improvement:
相关推荐
irislinAmelia3 小时前
缺陷检测AI关键点在哪
人工智能·嵌入式硬件·1024程序员节
Ai-_Man3 小时前
Meta Muse还是不可以导出左侧所有对话,只能点进去单条内容导出,方法不对吗?
开发语言·人工智能·ai·小程序·c#·1024程序员节
安托智造3 小时前
MBD:从二维图纸到三维模型的制造革命(下)
大数据·人工智能·制造·mbd
火山引擎开发者社区3 小时前
VeOps 深度调查:让 AI 排障从“能用”走向“可靠”
人工智能
梓豪csd3 小时前
消息订阅中心:谁该收到哪条通知
java·开发语言·人工智能·低代码·自动化·1024程序员节
王中阳Go3 小时前
两个入口答案不一致先别调模型:6 行入口口径对账表(附脚本)
人工智能·后端·python·大语言模型·1024程序员节
武天旭3 小时前
AI安全--AI大模型的隐私保护与法律法规
人工智能·安全
Solange__3 小时前
影视预演怎么用AI生成3D场景?从分镜、Blockout到镜头交付的完整流程
人工智能·游戏·3d·ai·自然语言处理·aigc·游戏策划
冬奇Lab3 小时前
一次 Skill 评测的复盘:我推翻了一份现成的模型选型结论,然后自己造了个评测平台
人工智能·llm·agent
奇树谦4 小时前
朴素贝叶斯(Naive Bayes)详解
机器学习·1024程序员节