AWS中的离线计算(大数据大屏项目)

一图胜千言

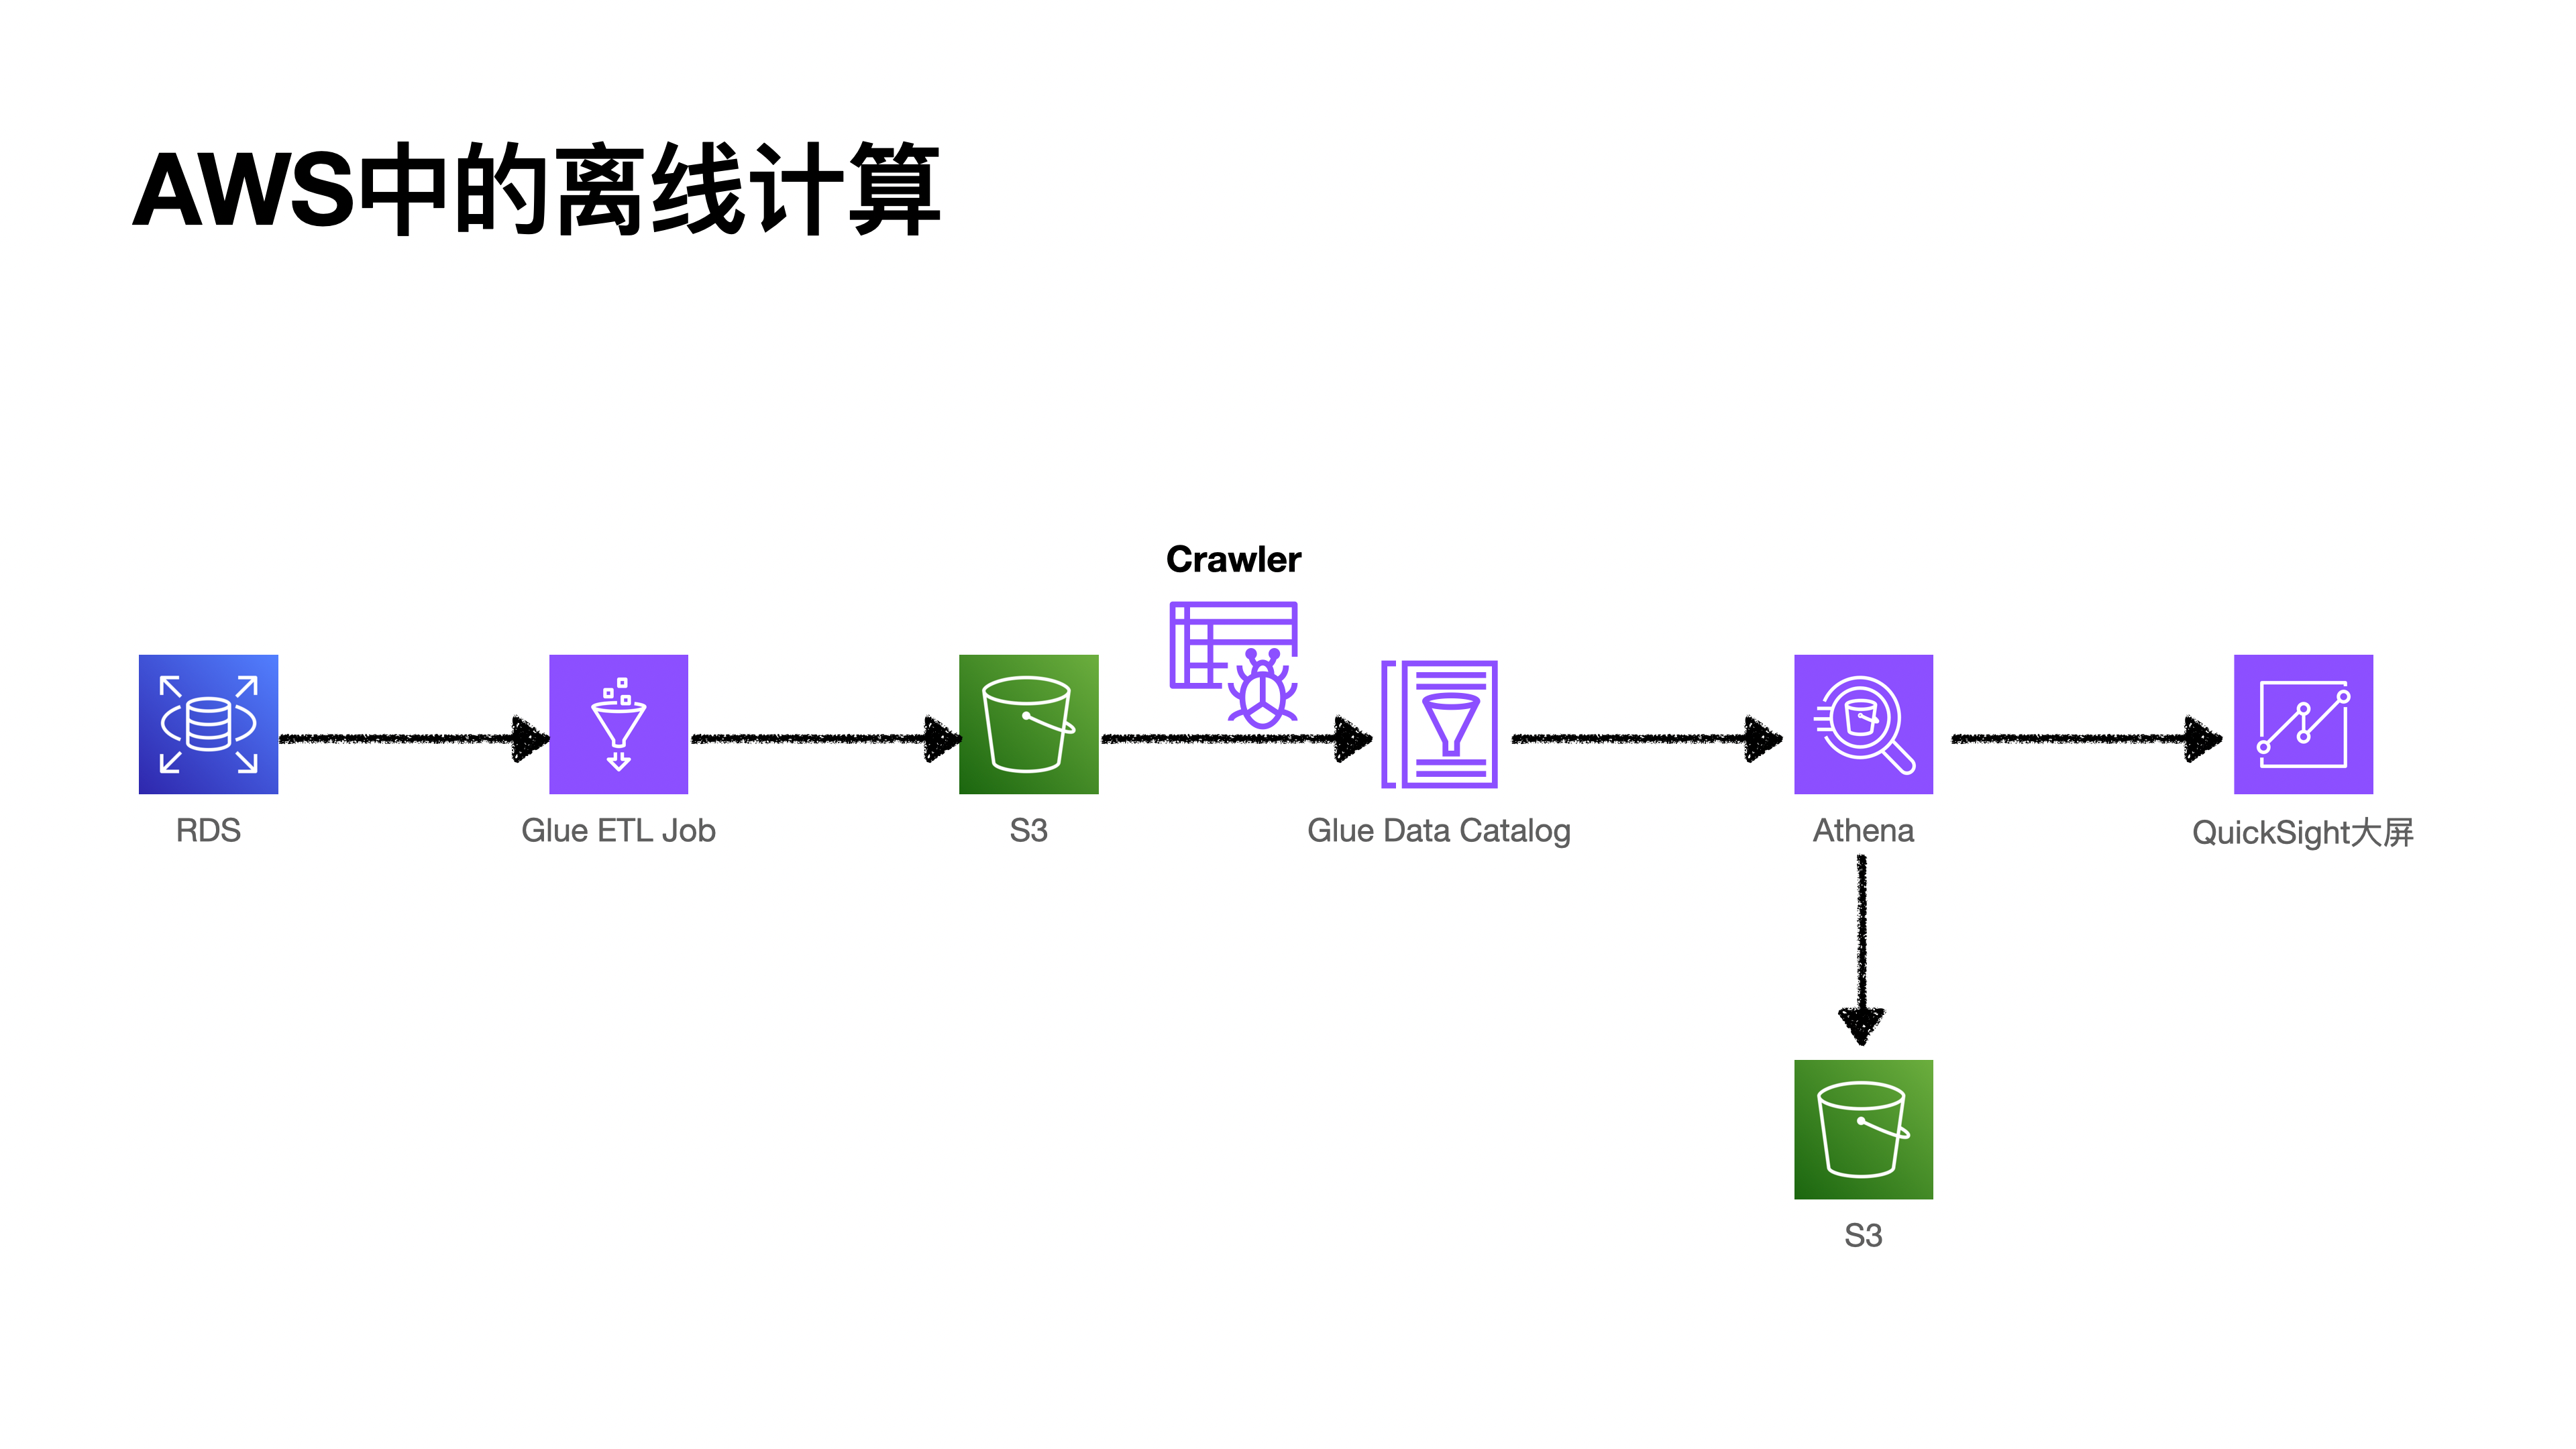
这里主要是通过Glue ETL Job将普通业务库(MySQL)里面的表数据,每日定时任务写入前天的数据到s3(保存为Hadoop的格式为parquet),然后,使用爬虫Crawler定时从S3桶中爬数据,爬到Glue的数据库和表中,即Glue Data Catalog,然后,使用Athena进行查业务聚合查询,结果保存到s3桶中,并使用QuickSight呈现为大屏。这就是AWS最简单的大数据离线计算大屏项目了。

参考

相关推荐
知识搬运临时工5 分钟前
一个模板把 AEM 拖进 Full GC 死亡螺旋:300% CPU、7 GB 堆、310 万行堆栈
java·aws
NiceZack1 小时前
Hadoop 部署全流程教程:从新装 CentOS 到伪分布式与完全分布式
hadoop·分布式·centos
MARSERERER1 小时前
Flink将Hive数据导入StarRocks中任务重跑如何避免数据重复?
大数据
电子科技圈1 小时前
2026 RISC-V中国峰会观察:编译调试工具链的“在场节奏”,释放了什么信号?
大数据·人工智能·设计模式·软件工程·软件构建·代码规范·risc-v
紧固件情报站1 小时前
紧固件报价逻辑重构:成本、合规与智能博弈
大数据·人工智能·重构
辛迪聊物业数字化2 小时前
智慧社区小程序落地避坑指南:3类物业方案选型+成本测算,线上服务零翻车
大数据·嵌入式硬件·百度·系统架构
Leo.yuan2 小时前
企业业务人员如何独立完成数据分析?2026年自助BI工具选型与应用指南
大数据·数据库·人工智能
roman_日积跬步-终至千里2 小时前
数仓开发的三层责任:业务定义、模型设计与 SQL 实现
数据库·数据仓库·sql·数据建模
@小匠2 小时前
Flink + Iceberg 批量失败复盘:一次超时如何变成 Hive Metastore 锁泄漏
大数据·hive·flink
小海测评2 小时前
生成式引擎优化技术解析:大语言模型外部内容采信机制与工程实践
大数据·人工智能·语言模型·geo·企业获客