抖音短视频数据分析及可视化
项目概况
**👇👇👇👇👇👇👇👇**
**👆👆👆👆👆👆👆👆**
数据类型
抖音短视频数据
开发环境
centos7
软件版本
python3.8.18、hadoop3.2.0、spark3.1.2、mysql5.7.38、scala2.12.18、jdk8
开发语言
python、Scala、Java
开发流程
数据预处理(python)->数据上传(hdfs)->数据清洗(mapreduce)->数据分析(spark)->数据存储(mysql)->后端(flask)->前端(html+js+css)
可视化图表
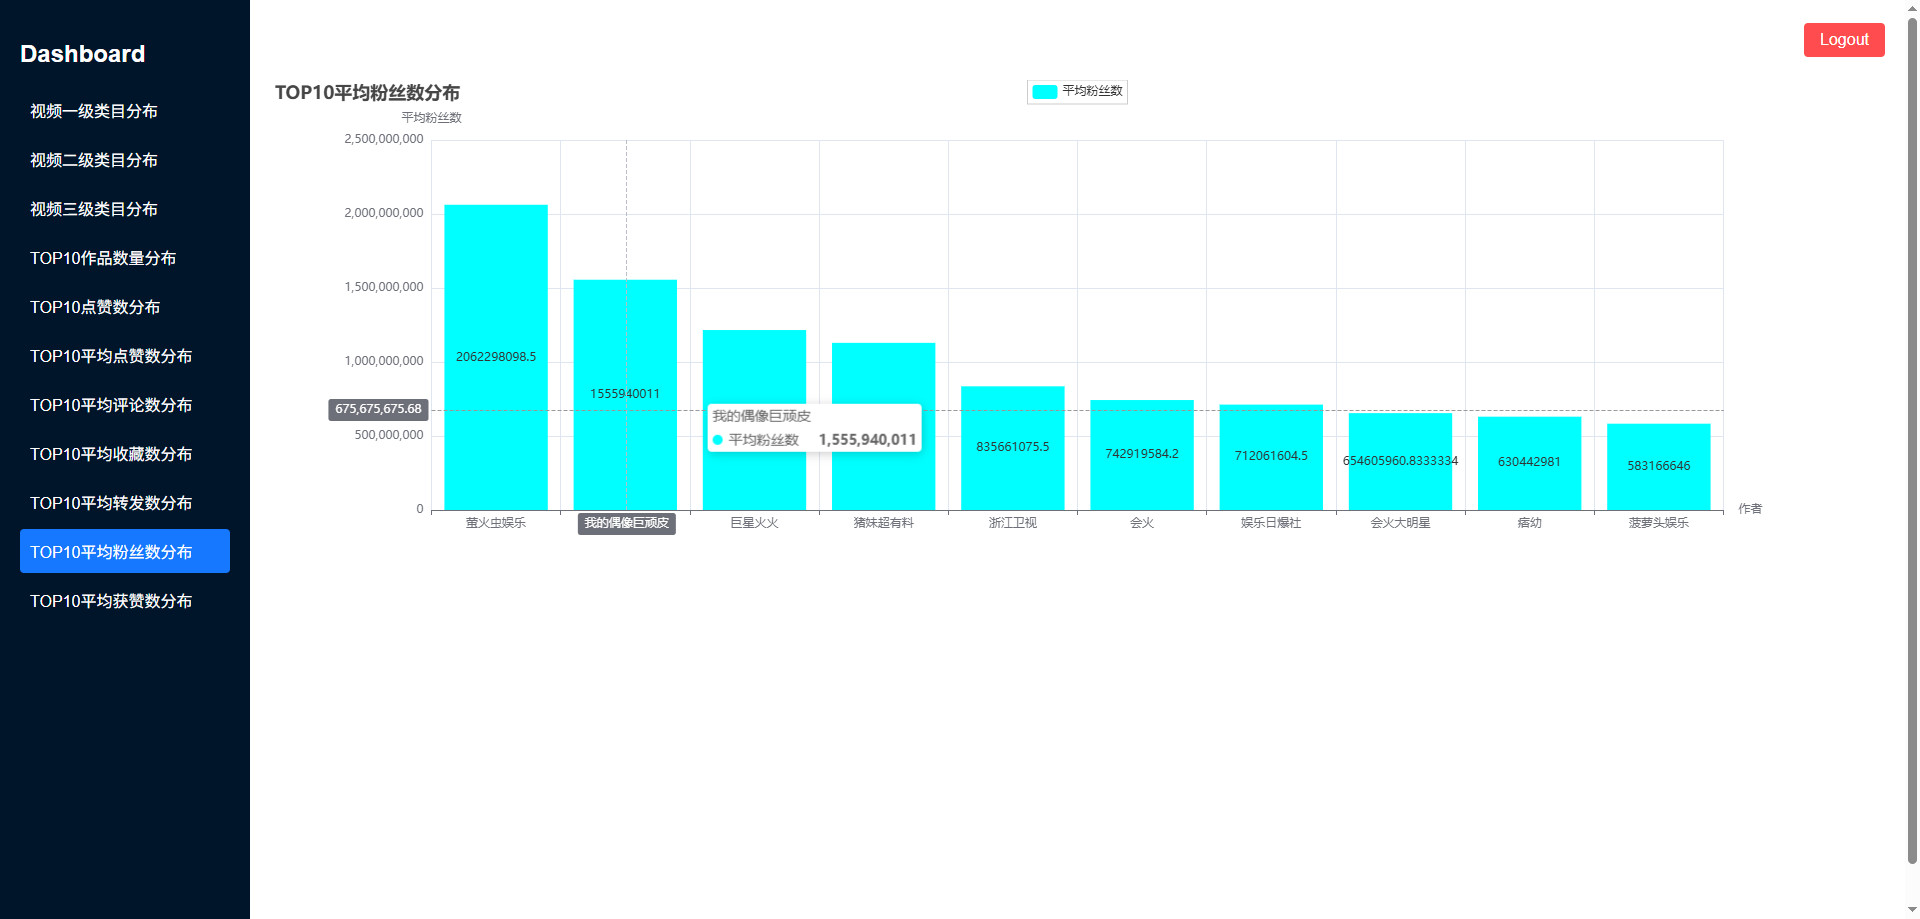
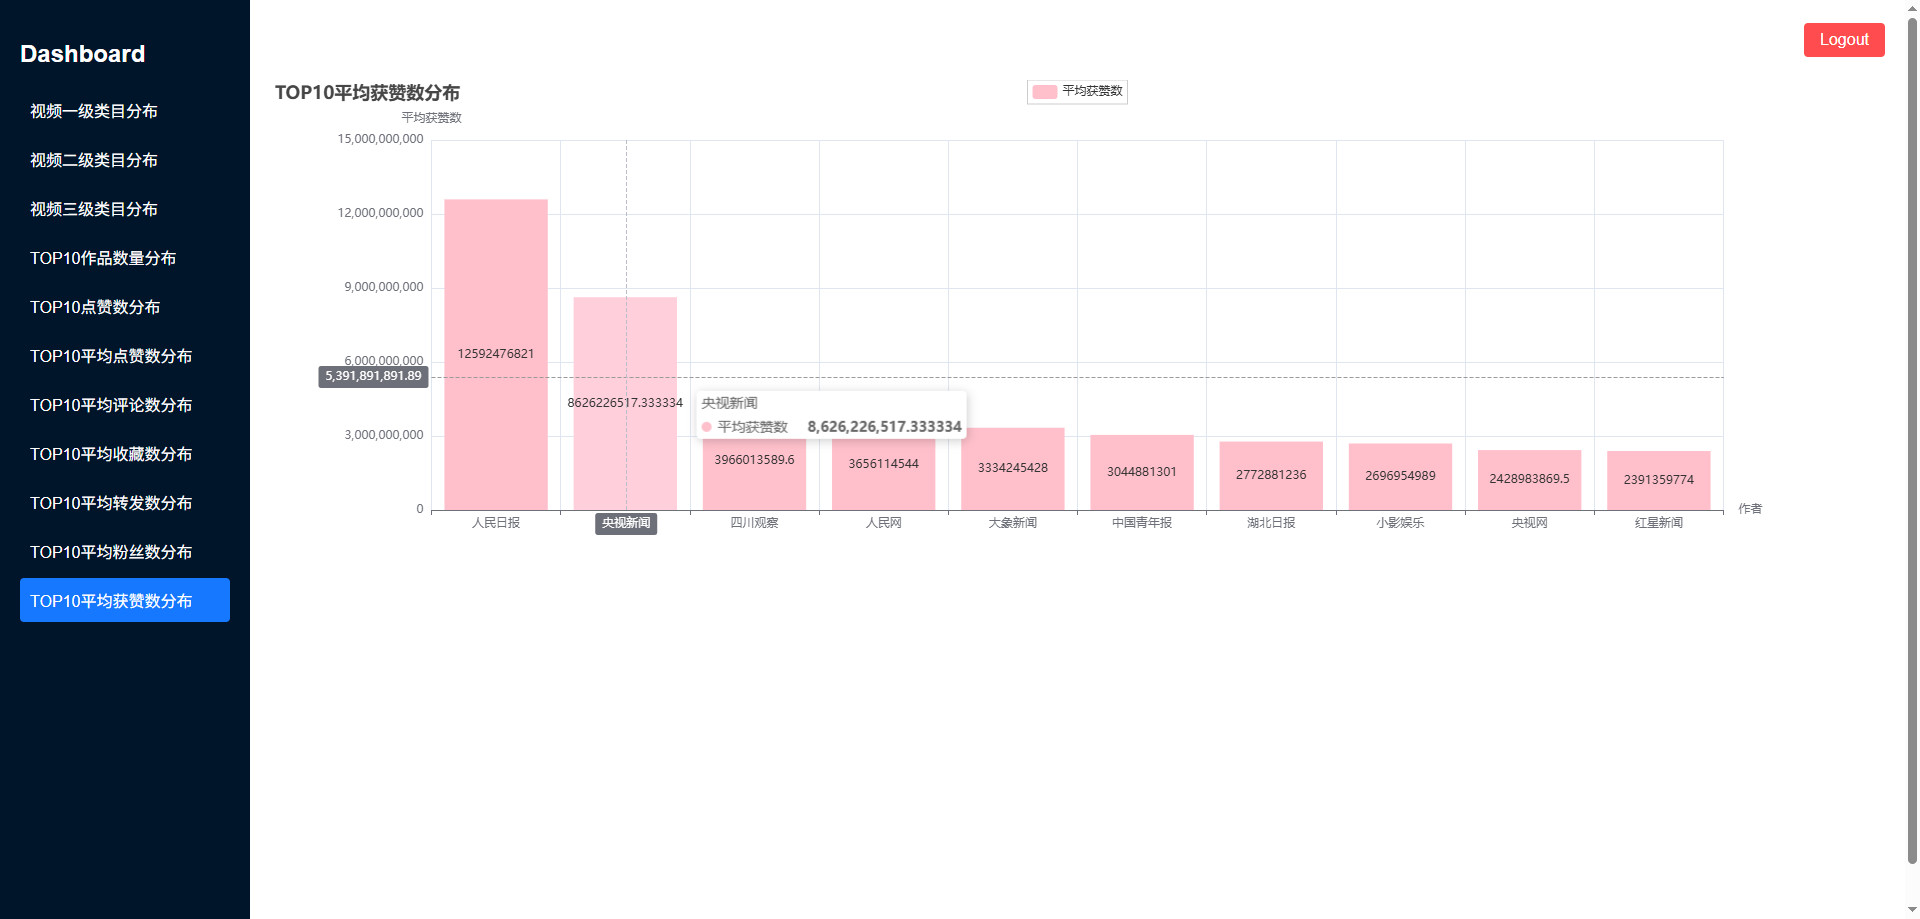
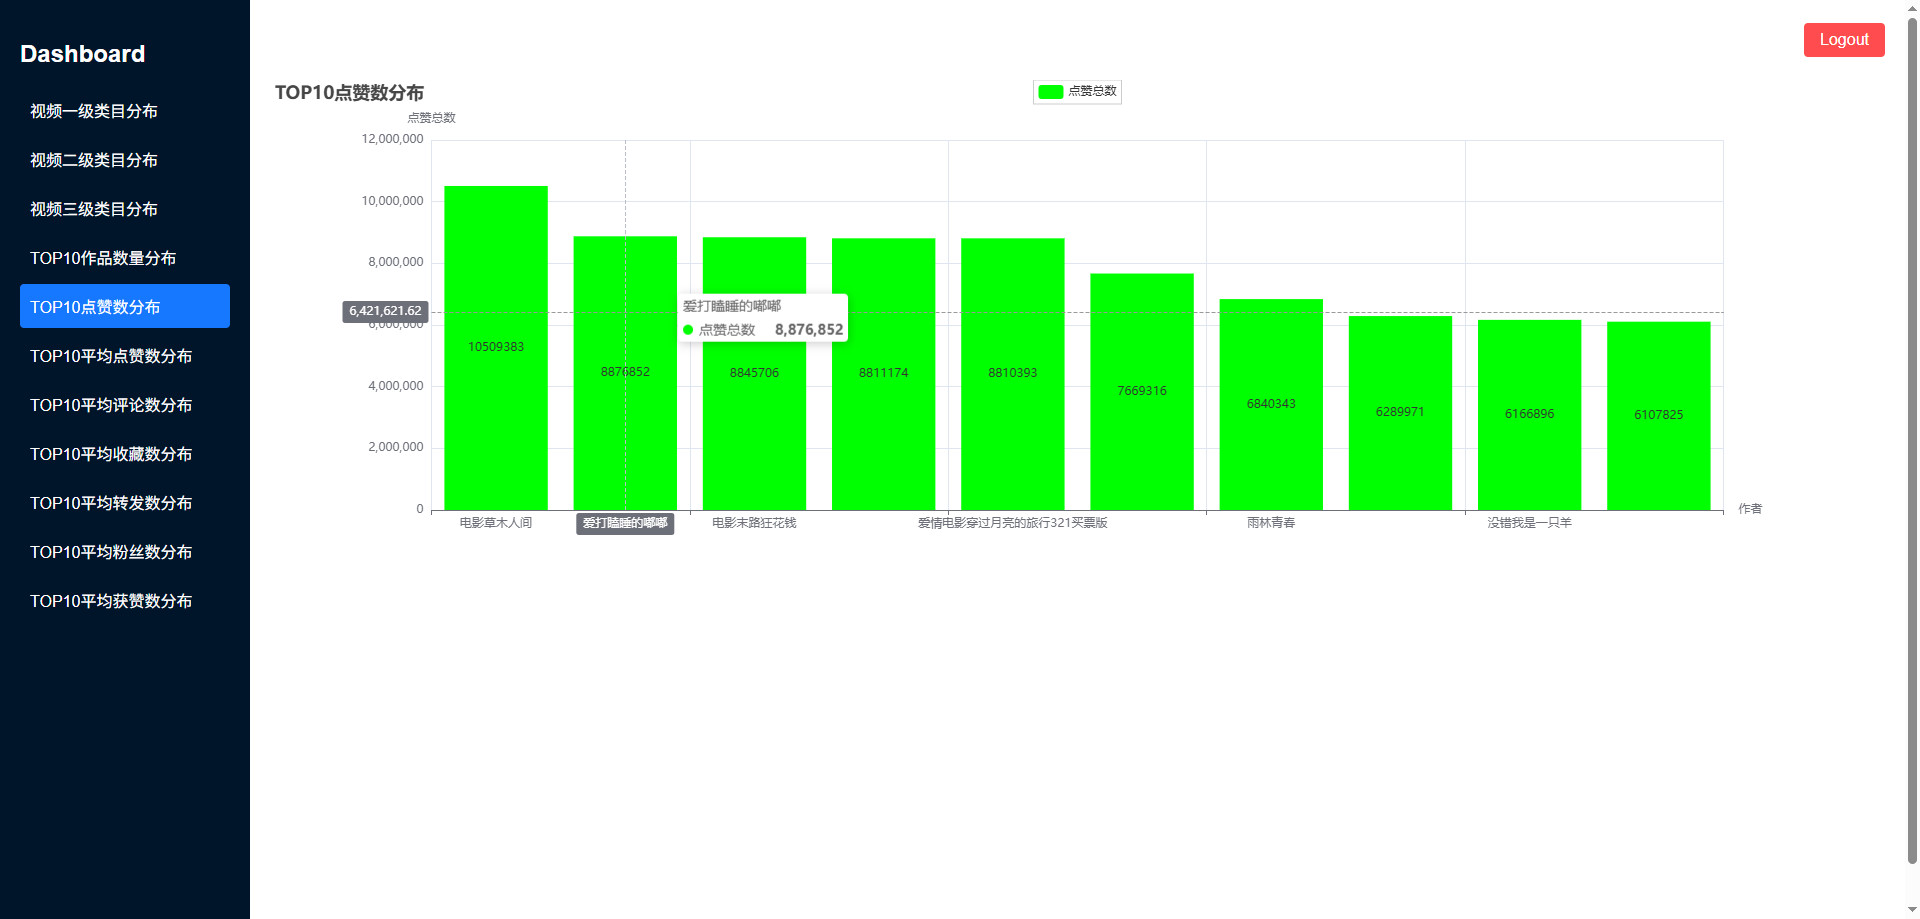
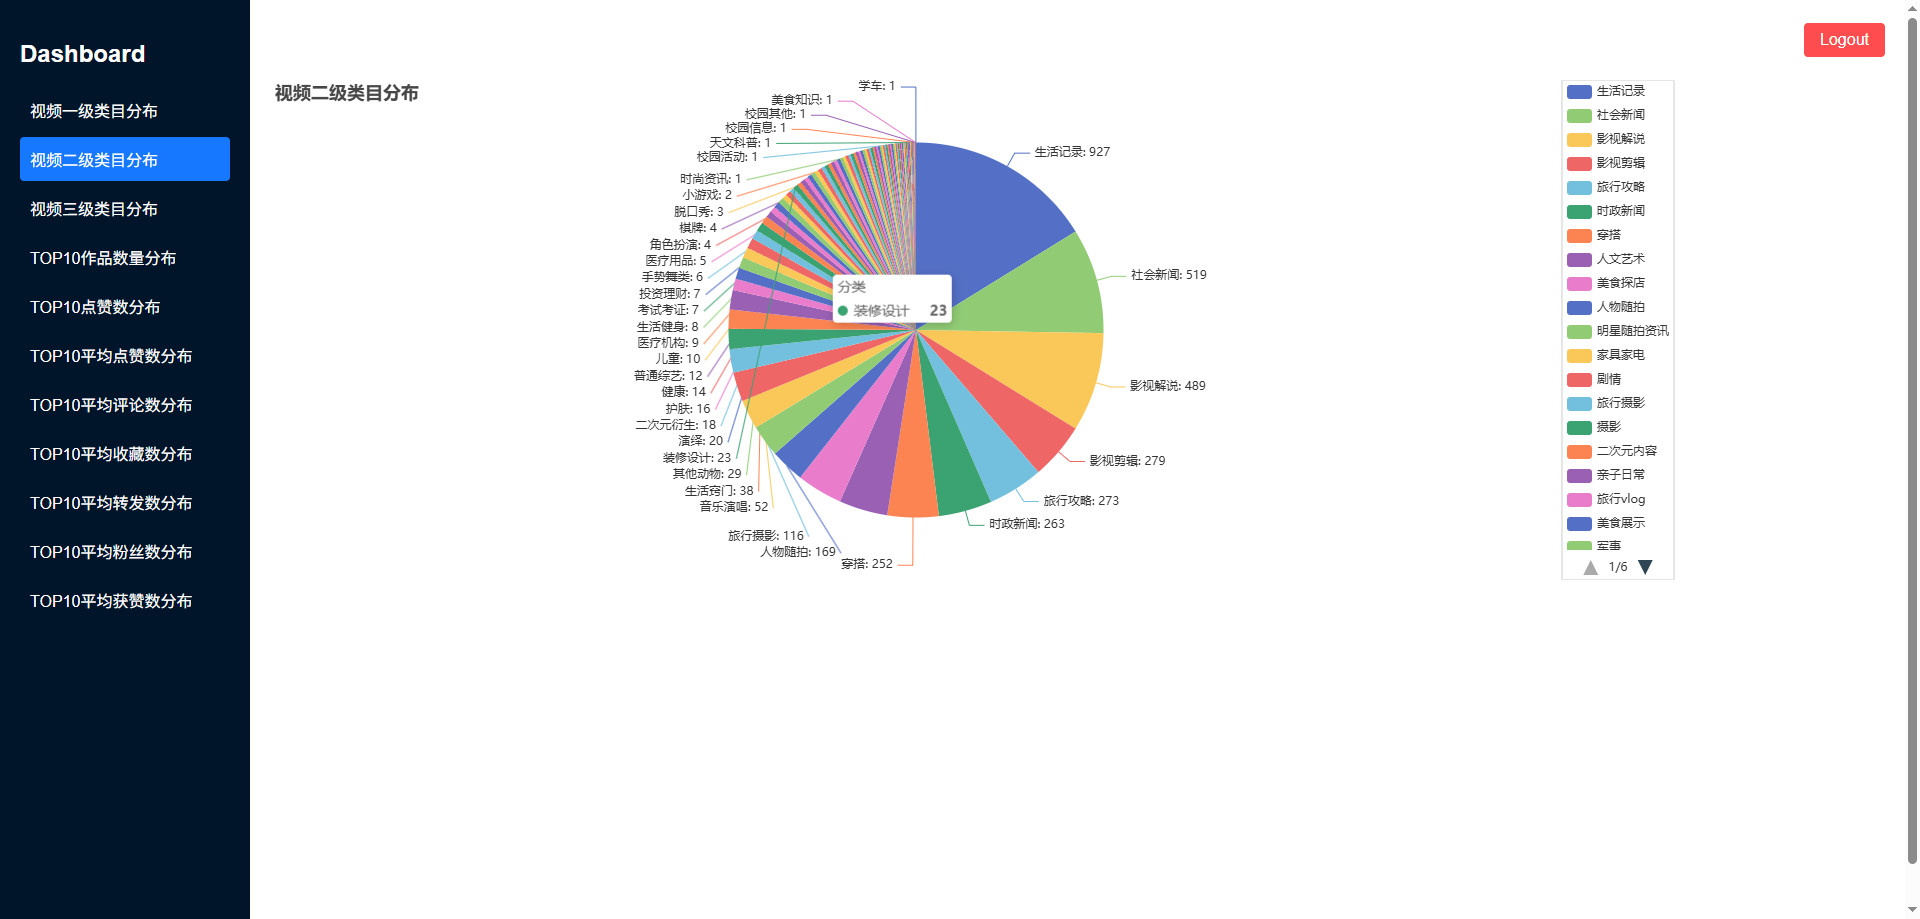
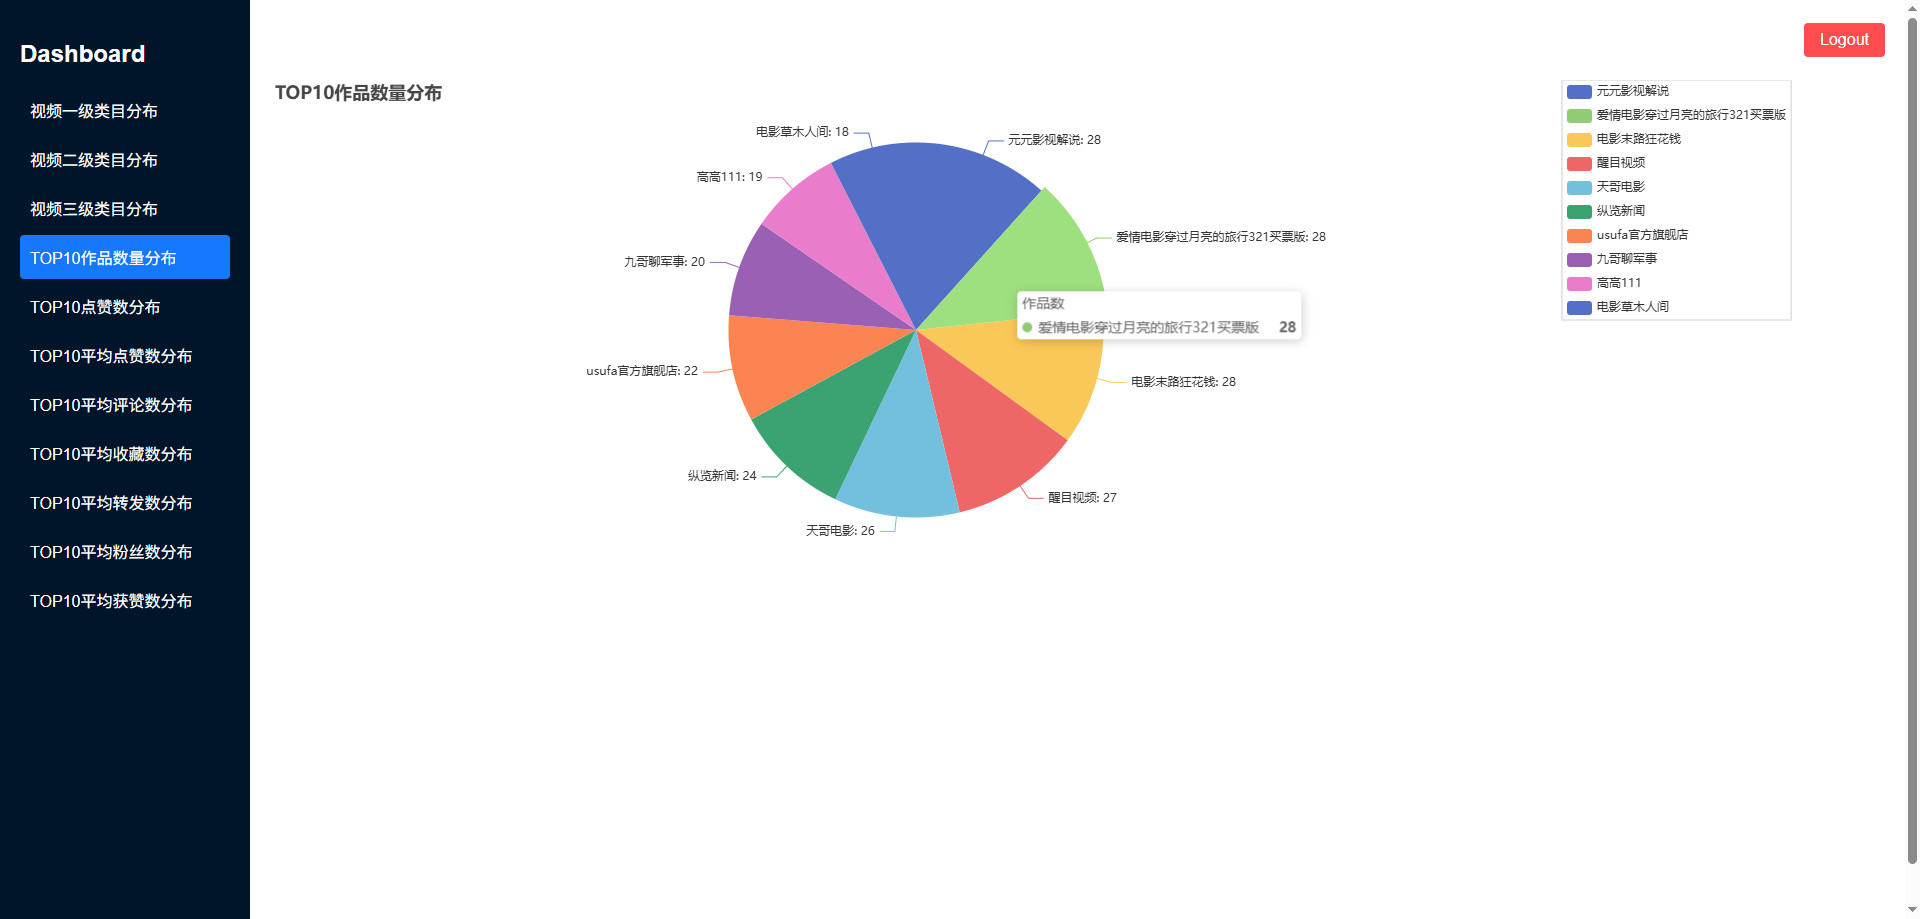
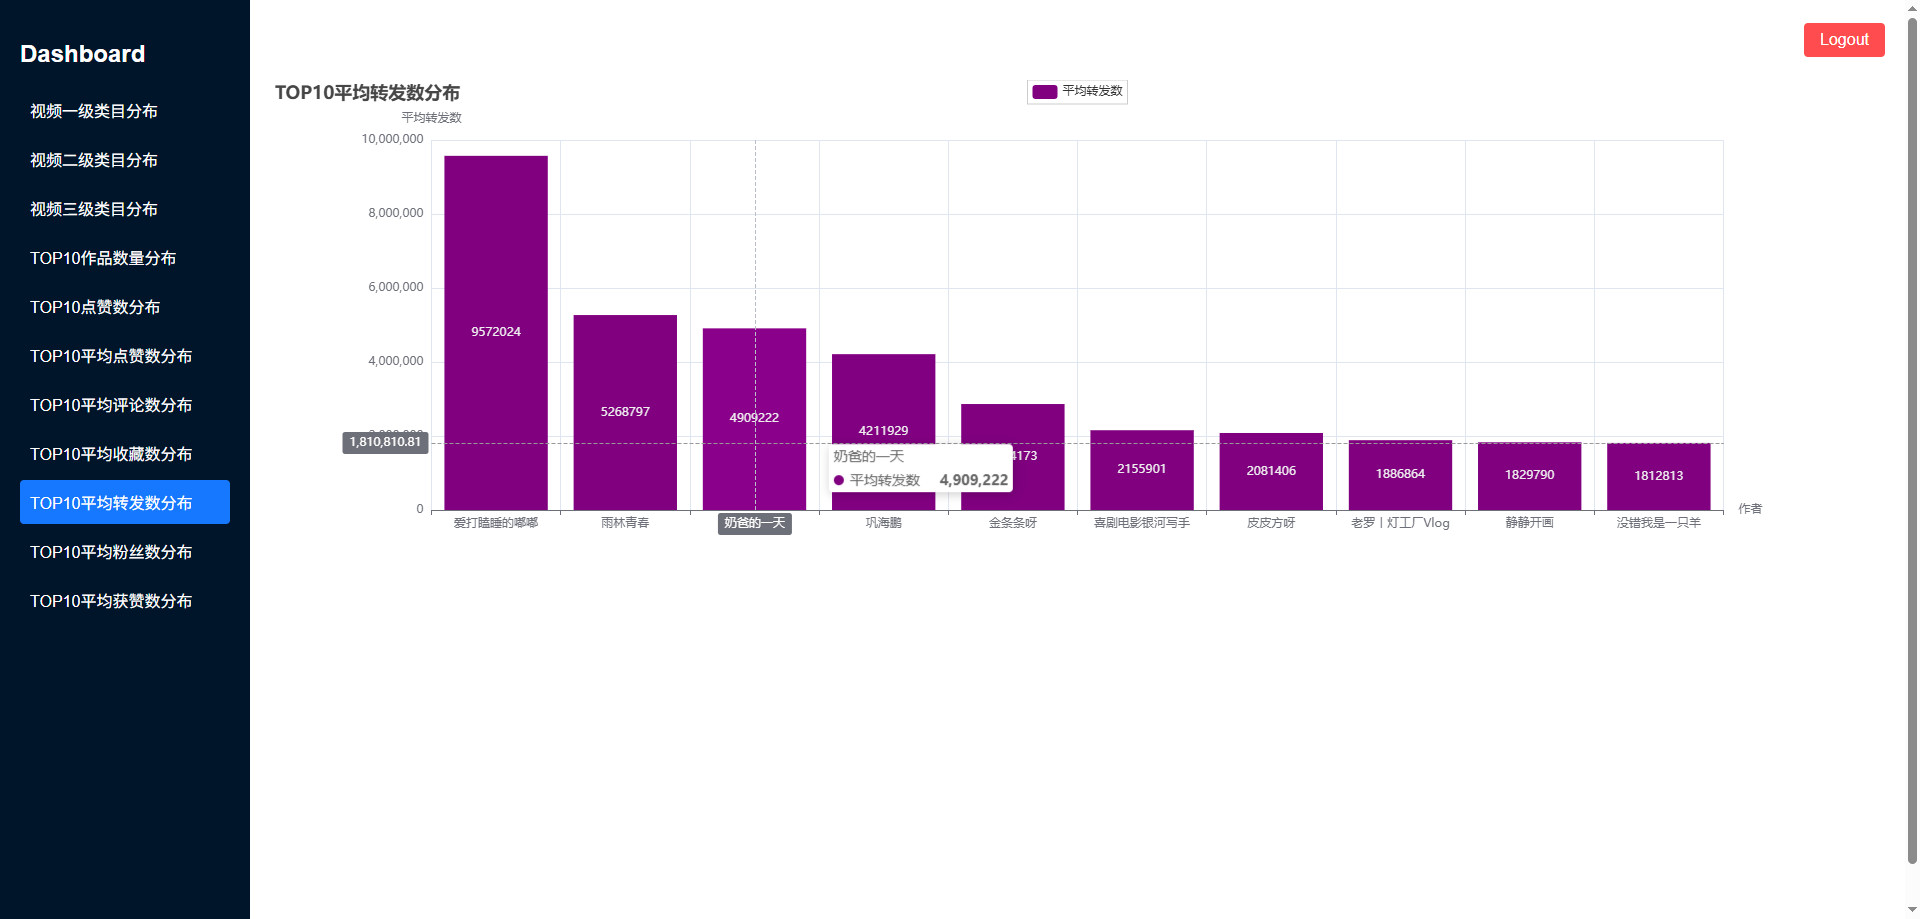
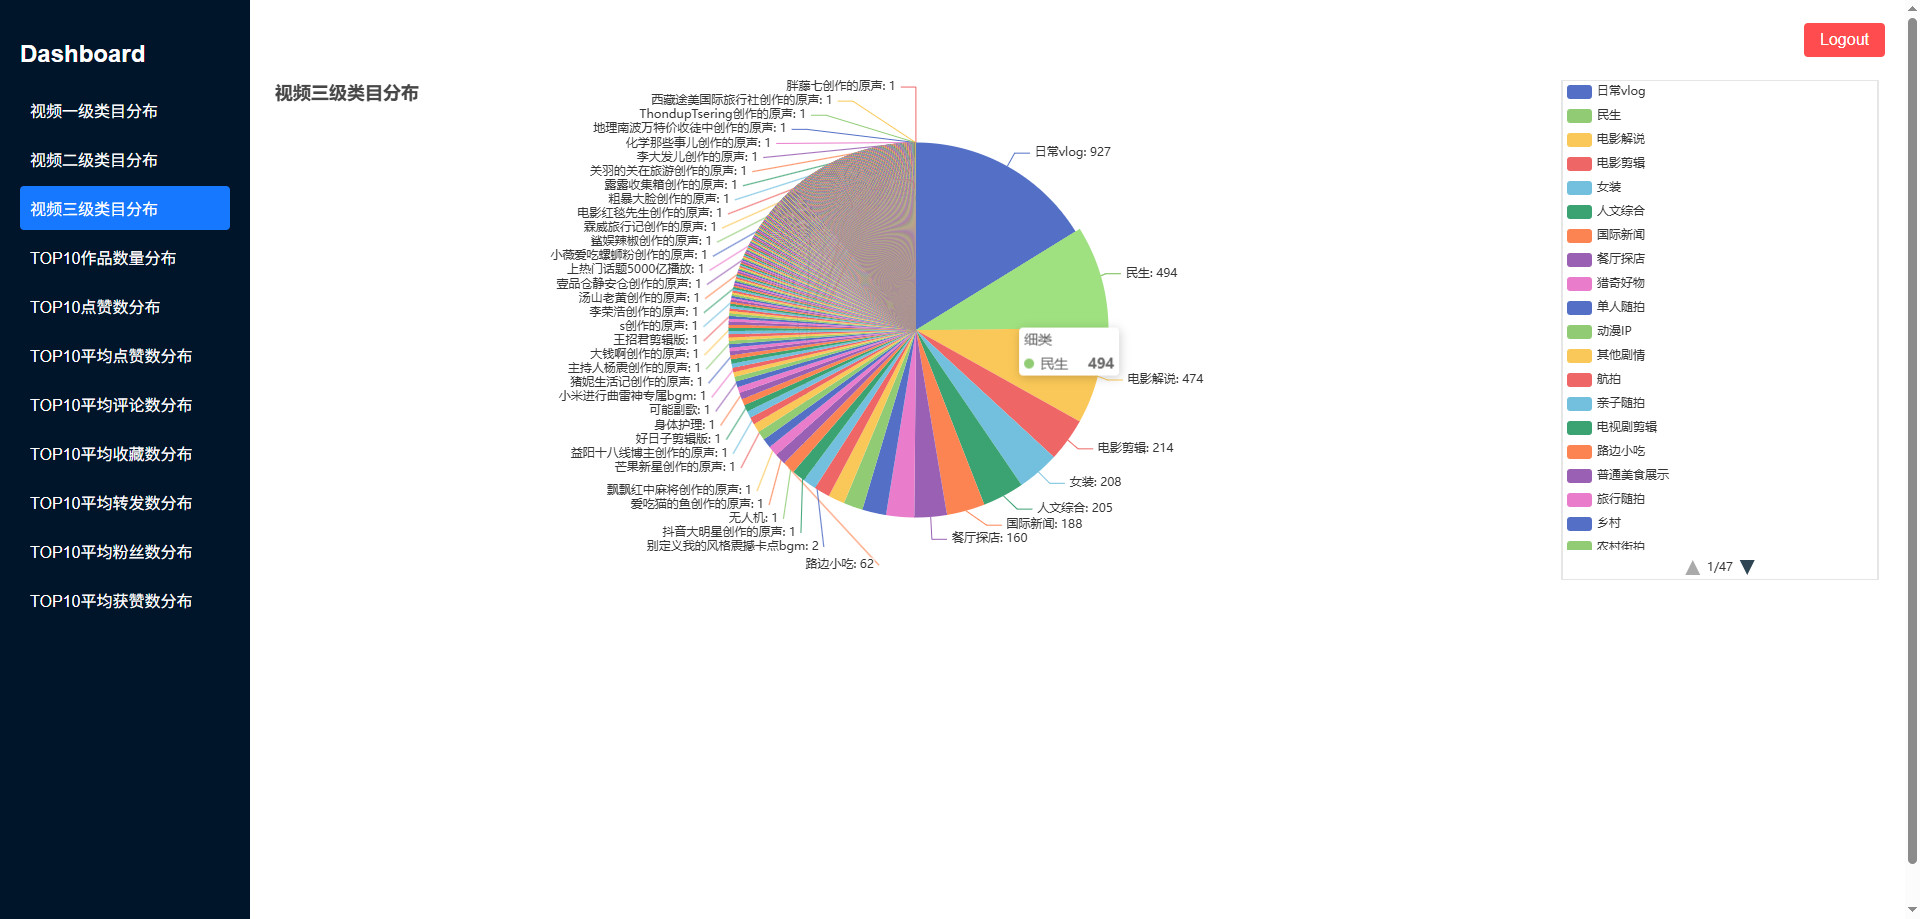
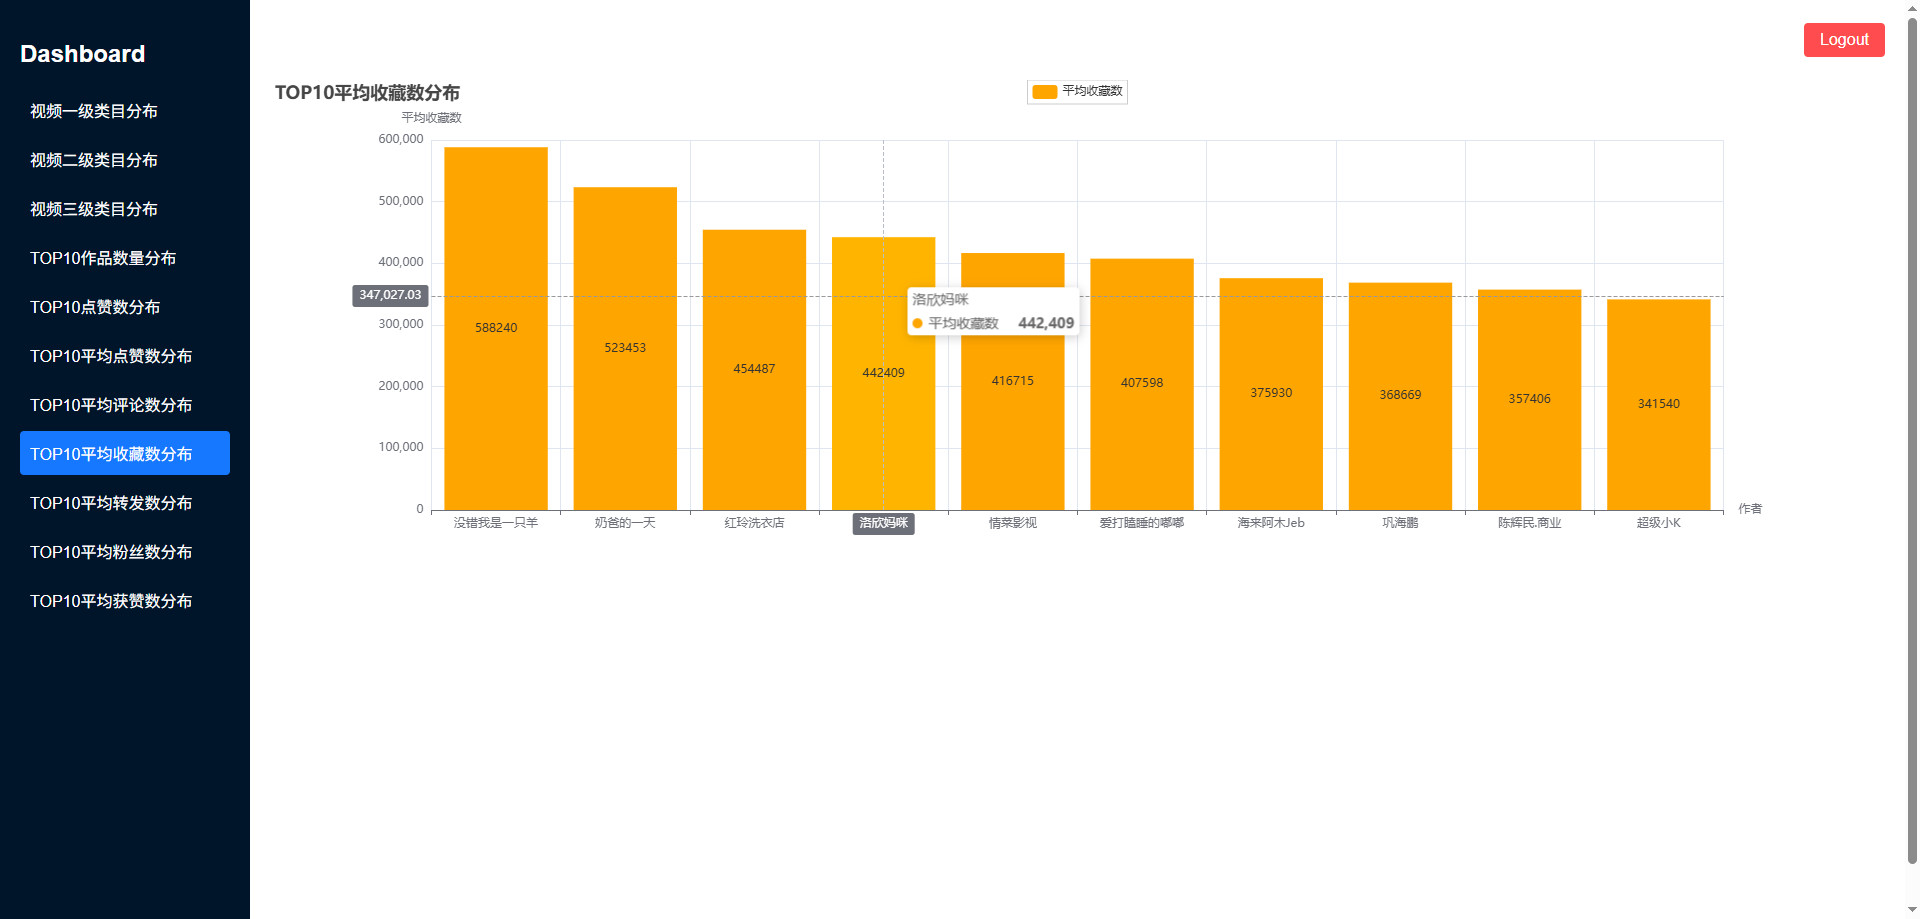
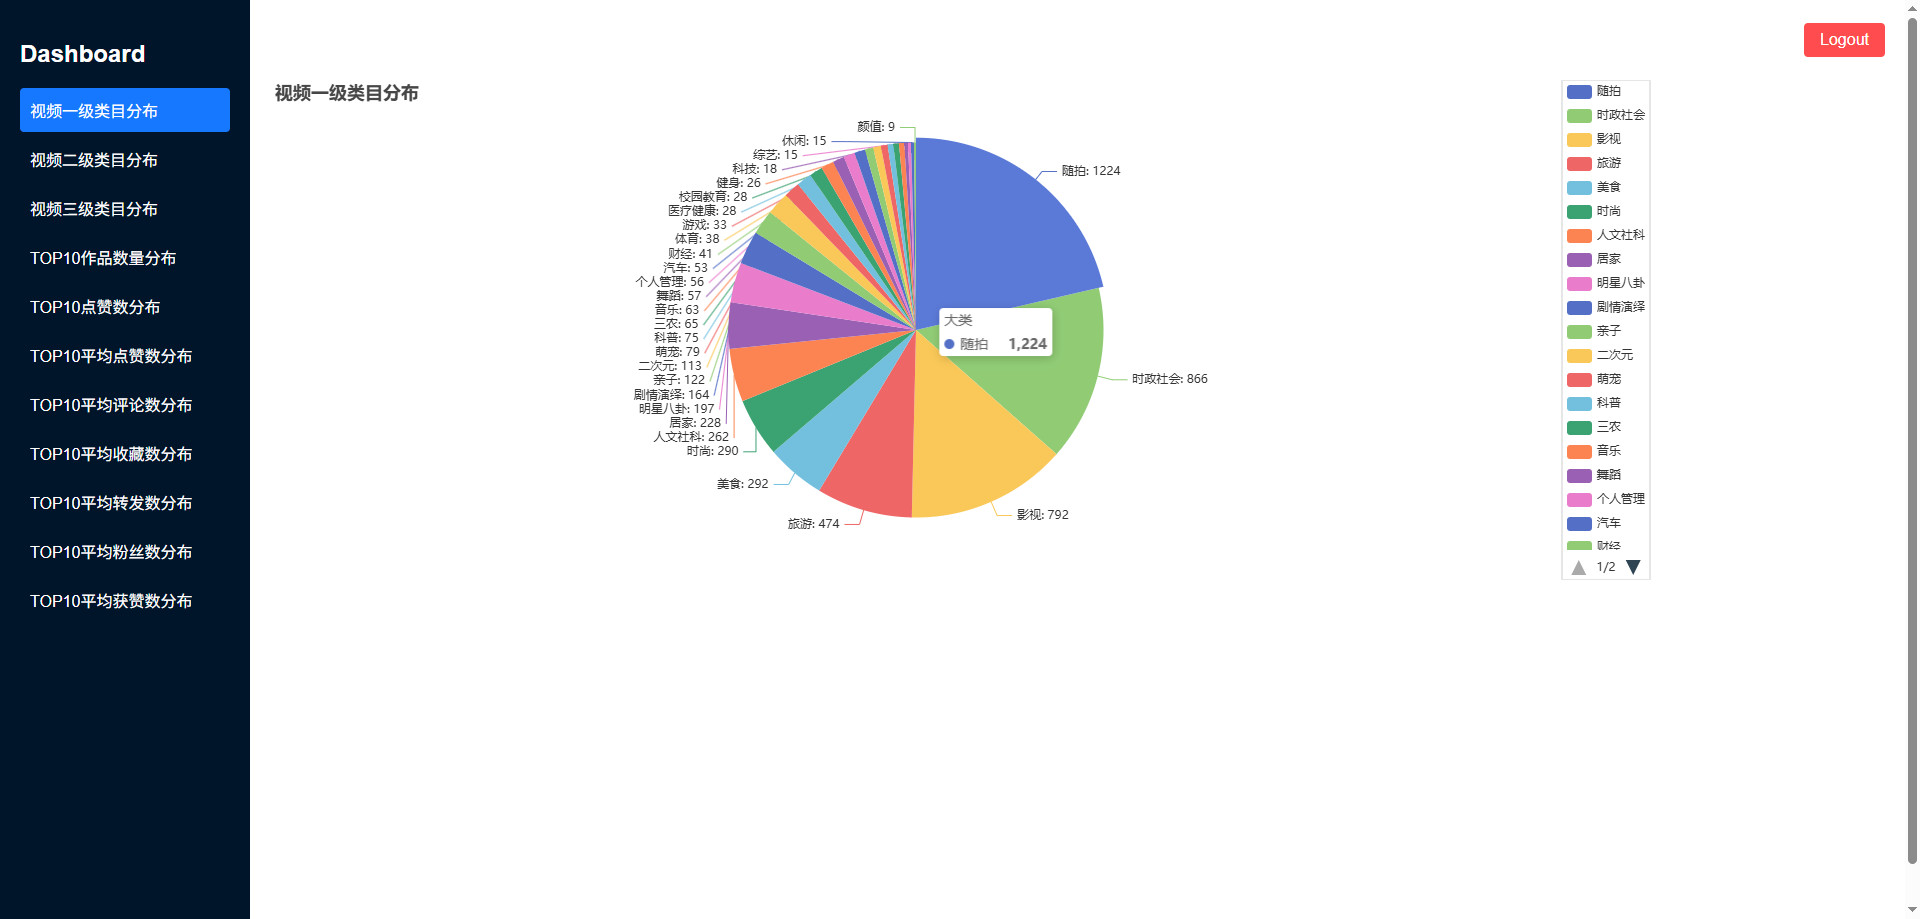
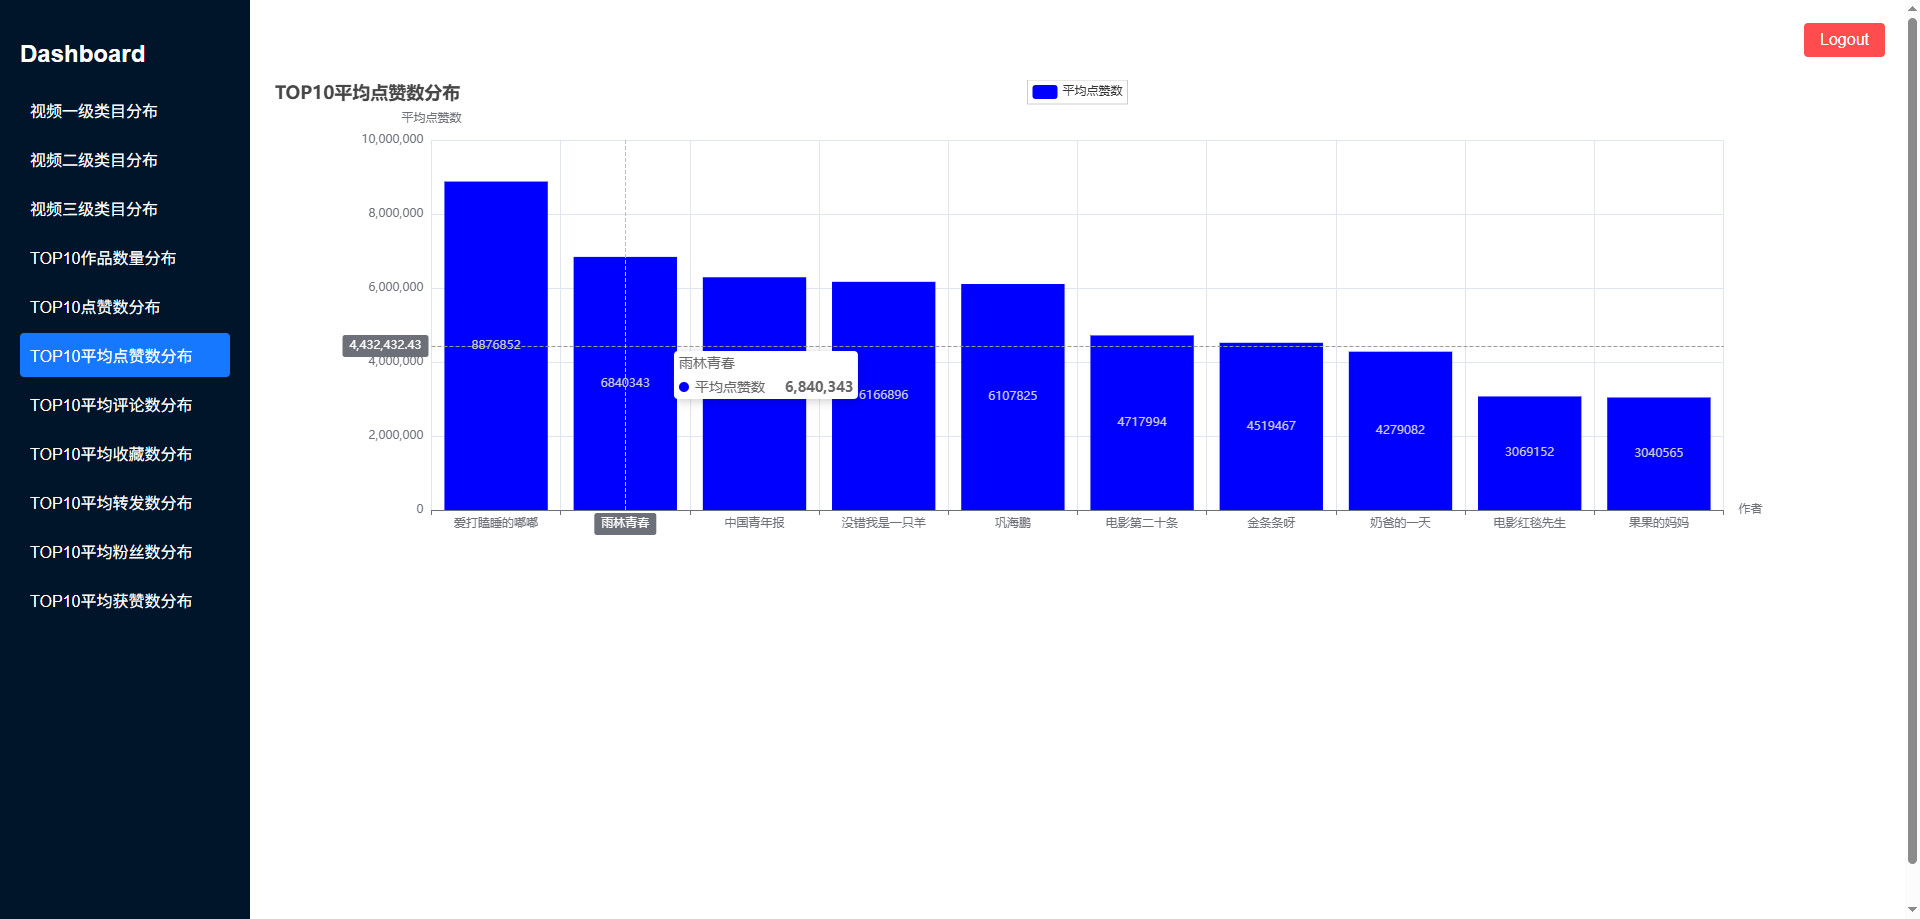
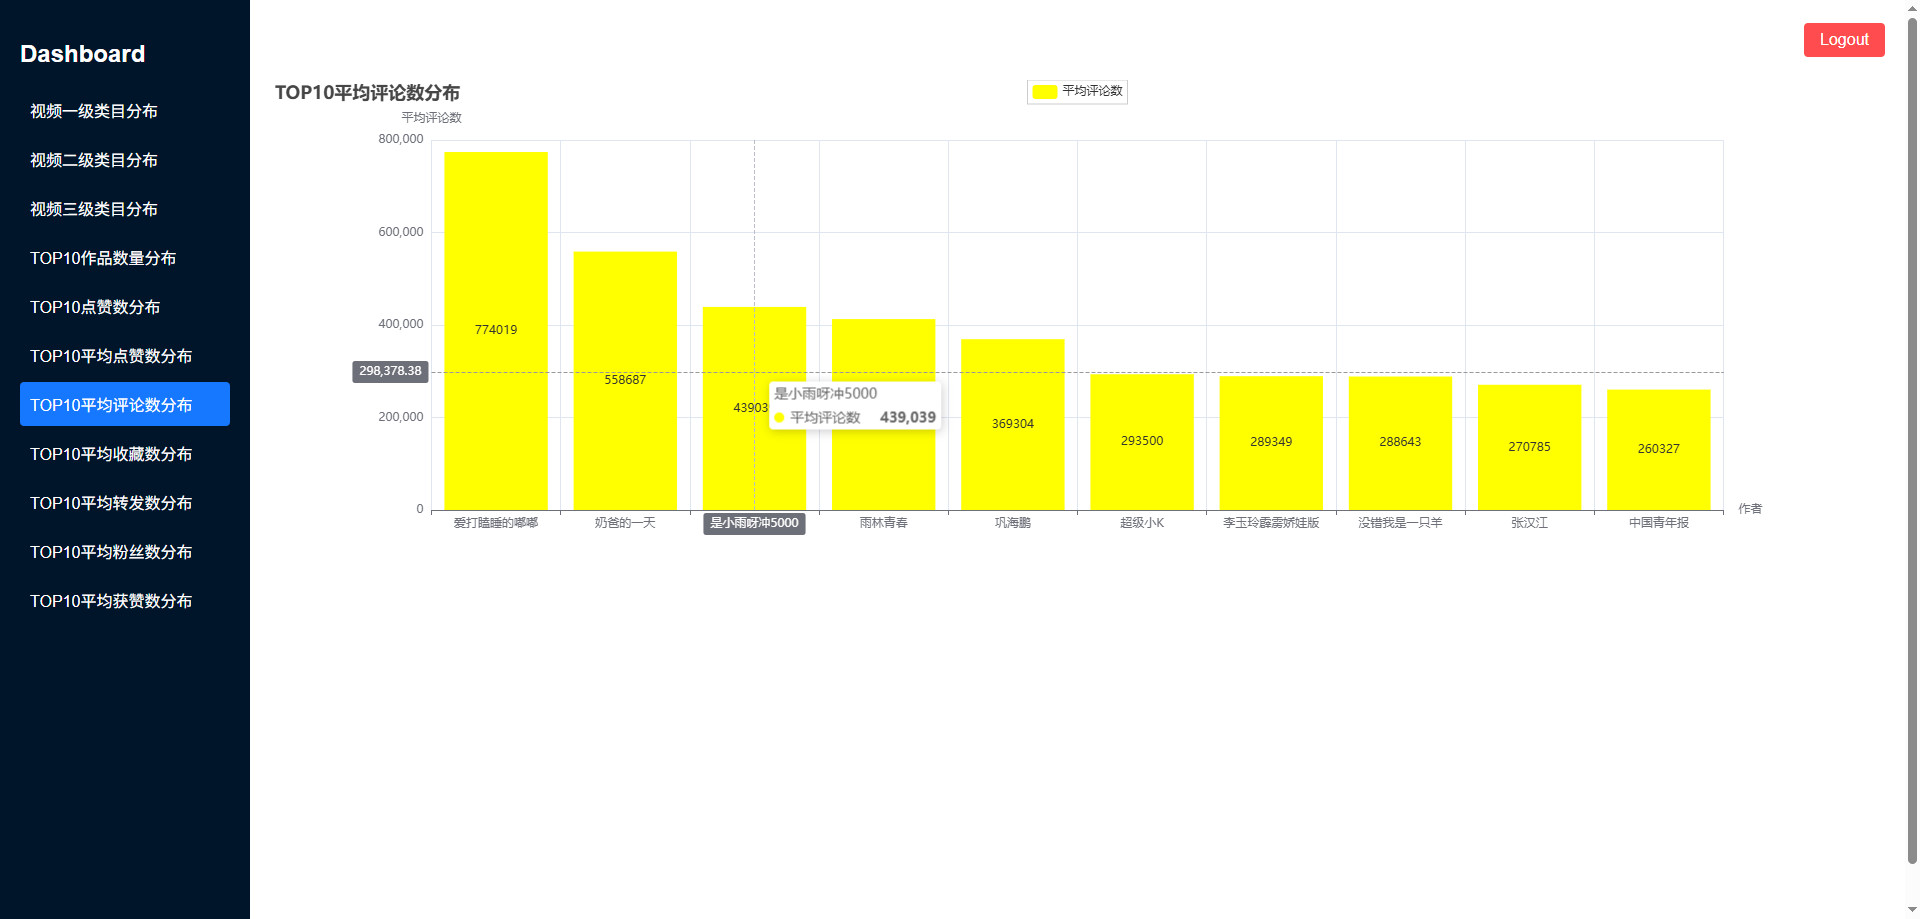
操作步骤
python安装包
shell
pip3 install pandas==2.0.3 -i https://mirrors.aliyun.com/pypi/simple/
pip3 install flask==3.0.0 -i https://mirrors.aliyun.com/pypi/simple/
pip3 install flask-cors==4.0.1 -i https://mirrors.aliyun.com/pypi/simple/
pip3 install pymysql==1.1.0 -i https://mirrors.aliyun.com/pypi/simple/
pip3 install pyecharts==2.0.4 -i https://pypi.tuna.tsinghua.edu.cn/simple
启动MySQL
shell
# 查看mysql是否启动 启动命令: systemctl start mysqld.service
systemctl status mysqld.service
# 进入mysql终端
# MySQL的用户名:root 密码:123456
# MySQL的用户名:root 密码:123456
# MySQL的用户名:root 密码:123456
mysql -uroot -p123456
创建MySQL库
sql
CREATE DATABASE IF NOT EXISTS echarts CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;启动Hadoop
shell
# 离开安全模式: hdfs dfsadmin -safemode leave
# 启动hadoop
bash /export/software/hadoop-3.2.0/sbin/start-hadoop.sh
准备目录
shell
mkdir -p /data/jobs/project/
cd /data/jobs/project/

# 解压 "data" 目录下的 "data.7z" 文件
# 上传 "data" 目录下的 "所有" 文件到 "/data/jobs/project/" 目录

# douyin.csv
# douyin.txt
数据预处理
shell
cd /data/jobs/project/

# 上传 "数据预处理" 目录下的 "data_preprocess.py" 文件到 "/data/jobs/project/" 目录
# 为避免分隔符导致错位问题,重新生成一个分隔符文件
python3 data_preprocess.py

ls -l douyin.txt
head -5 douyin.txt
上传文件到hdfs
shell
cd /data/jobs/project/

hdfs dfs -mkdir -p /data/input/
hdfs dfs -rm -r /data/input/*
hdfs dfs -put douyin.txt /data/input/
hdfs dfs -ls /data/input/
程序打包
shell
cd /data/jobs/project/

# 对 "数据清洗" 目录下的项目 "mapreduce-job" 进行打包
# 打包命令: mvn clean package -Dmaven.test.skip=true

# 上传 "mapreduce-job/target/" 目录下的 "mapreduce-job-jar-with-dependencies.jar" 文件 到 "/data/jobs/project/" 目录
mapreduce数据清洗
shell
cd /data/jobs/project/

hadoop jar mapreduce-job-jar-with-dependencies.jar /data/input/ /data/output/

# 查看结果
hdfs dfs -ls /data/output/
spark数据分析
shell
cd /data/jobs/project/

# 对 "spark" 目录下的项目 "spark-job" 进行打包
# 打包命令: mvn clean package -Dmaven.test.skip=true

# 上传 "spark-job/target/" 目录下的 "spark-job-jar-with-dependencies.jar" 文件 到 "/data/jobs/project/" 目录

spark-submit \
--master local[*] \
--class com.exam.SparkApp \
/data/jobs/project/spark-job-jar-with-dependencies.jar
启动可视化
shell
mkdir -p /data/jobs/project/myapp/
cd /data/jobs/project/myapp/

# 上传 "可视化" 目录下的 "所有" 文件和文件夹 到 "/data/jobs/project/" 目录

# windows本地运行: python app.py
python3 app.py pro
# 登录名/密码 随便输入