什么是LiteLLM?
LiteLLM是一个强大的工具,旨在简化不同大型语言模型(LLM)的调用流程。它提供了统一的接口,让开发者可以使用OpenAI的格式调用超过100种不同的LLM,包括Bedrock、Huggingface、VertexAI、TogetherAI、Azure、OpenAI、Groq等。
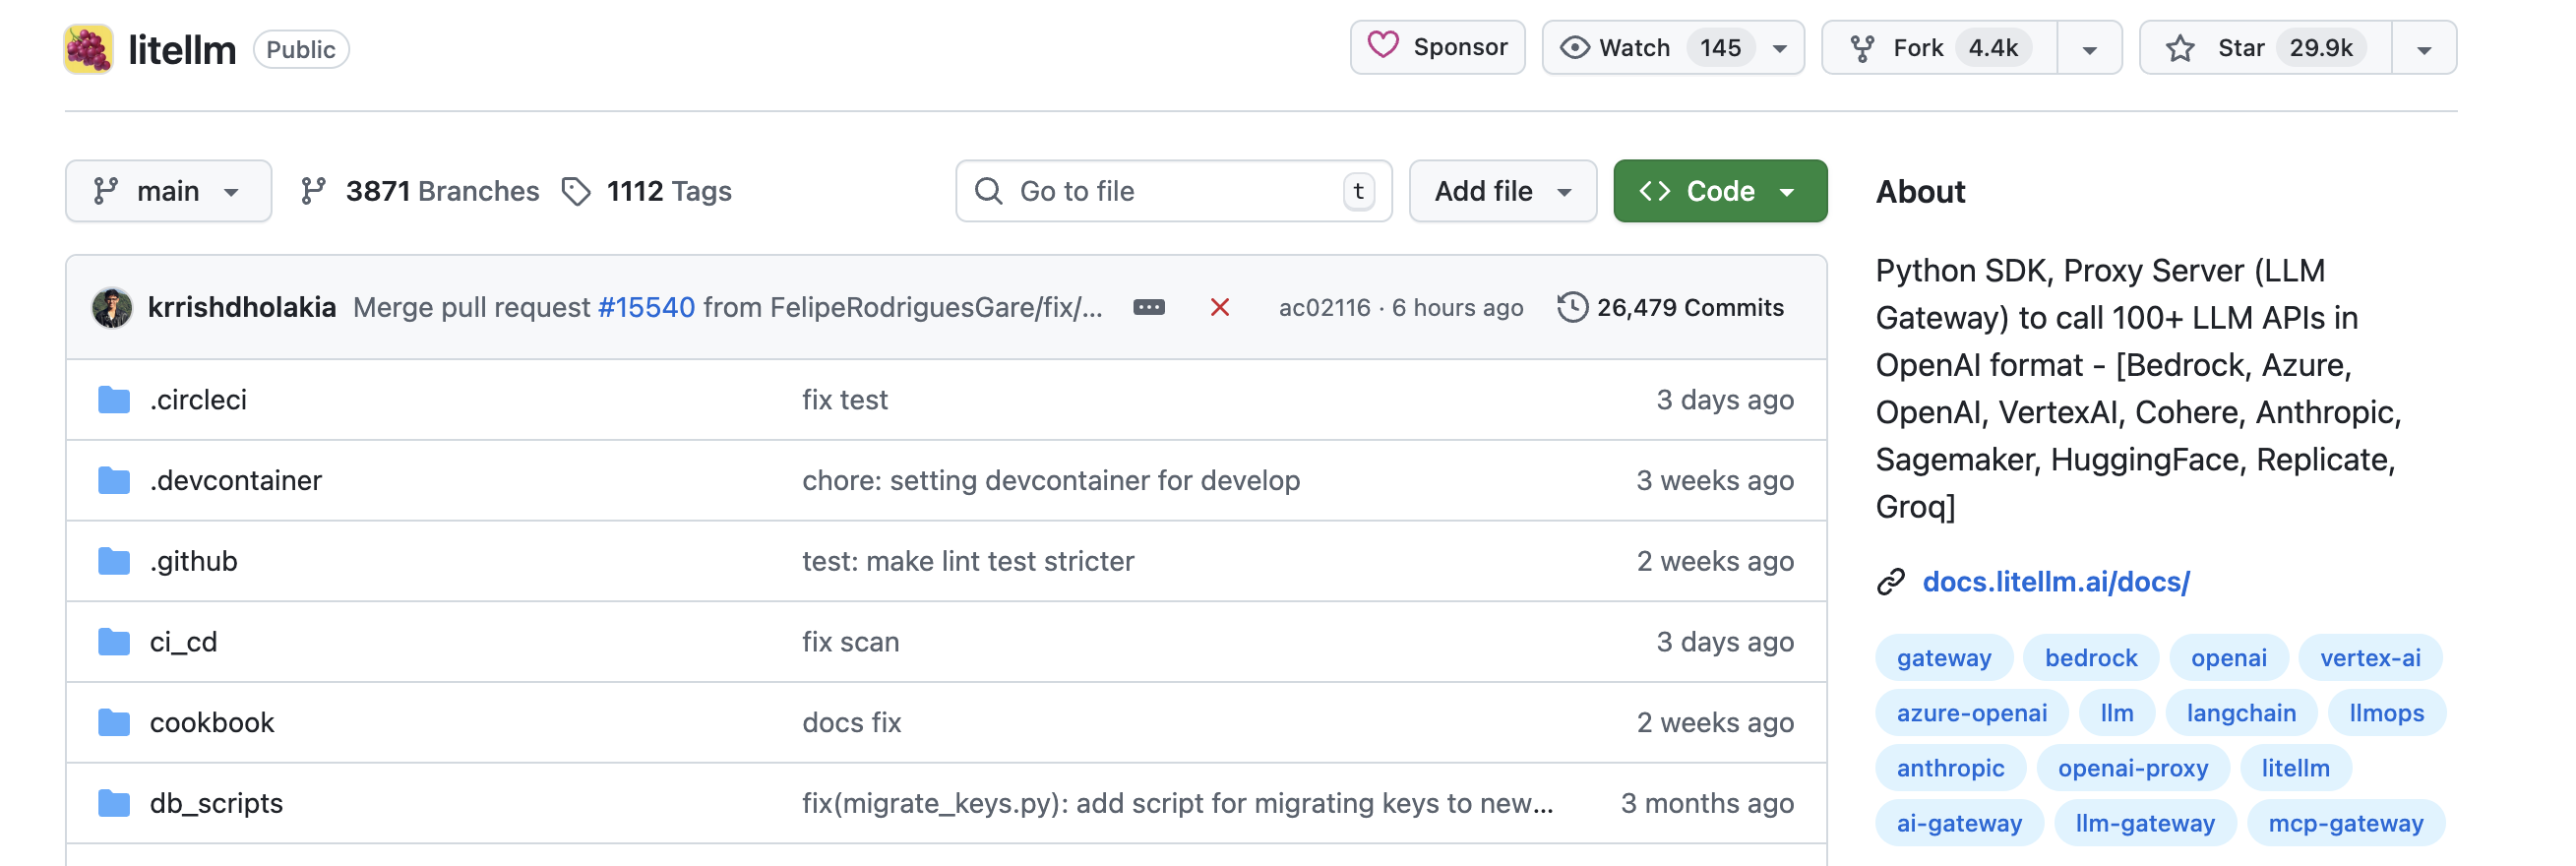
https://github.com/BerriAI/litellm
核心优势
-
统一接口 :将各种LLM提供商的
completion、embedding和image_generation端点输入进行转换,输出格式保持一致,文本响应始终可在['choices'][0]['message']['content']获取。 -
可靠性增强:支持跨多个部署(如Azure/OpenAI)的重试和 fallback 逻辑,通过路由功能提高系统稳定性。
-
可观测性:集成多种日志和监控工具(如Langsmith、Literal AI、Langtrace等),方便跟踪和优化LLM应用。
-
成本管理:提供代理服务器功能,可跟踪支出并为每个项目设置预算,支持虚拟密钥管理。
-
性能优化:持续改进性能,最新版本在RPS、内存使用和CPU占用等方面都有显著提升。
适用场景
无论是构建聊天机器人、开发AI驱动的内容生成工具,还是需要在多个LLM之间进行比较和选择,LiteLLM都能提供简洁高效的解决方案。它的代理服务器和企业级功能使其同样适用于生产环境中的大规模部署。
通过LiteLLM,开发者可以专注于构建核心业务逻辑,而不必担心不同LLM提供商之间的接口差异,从而大大提高开发效率并降低维护成本。
LiteLLM 核心功能代码示例
1. 基础调用(支持多模型统一接口)
python
# 安装
pip install litellm
python
from litellm import completion
import os

# OpenAI调用
os.environ["OPENAI_API_KEY"] = "your-key"
response = completion(
    model="openai/gpt-4o",
    messages=[{"content": "Hello", "role": "user"}]
)

# Anthropic调用
os.environ["ANTHROPIC_API_KEY"] = "your-key"
response = completion(
    model="anthropic/claude-sonnet-4-20250514",
    messages=[{"content": "Hello", "role": "user"}]
)

# Azure调用
os.environ["AZURE_API_KEY"] = "your-key"
os.environ["AZURE_API_BASE"] = "your-endpoint"
response = completion(
    model="azure/your-deployment",
    messages=[{"content": "Hello", "role": "user"}]
)

# Ollama本地调用
response = completion(
    model="ollama/llama2",
    messages=[{"content": "Hello", "role": "user"}],
    api_base="http://localhost:11434"
)
2. 流式响应(Streaming)
python
# OpenAI流式
response = completion(
    model="openai/gpt-3.5-turbo",
    messages=[{"content": "讲个故事", "role": "user"}],
    stream=True
)
for chunk in response:
    print(chunk.choices[0].delta.content or "", end="")

# HuggingFace流式
os.environ["HUGGINGFACE_API_KEY"] = "your-key"
response = completion(
    model="huggingface/WizardLM/WizardCoder-Python-34B-V1.0",
    messages=[{"content": "写段Python代码", "role": "user"}],
    api_base="https://your-endpoint.huggingface.cloud",
    stream=True
)
for chunk in response:
    print(chunk.choices[0].delta.content or "", end="")
3. 代理服务器(Proxy Server)
bash
# 启动代理服务器(支持多种模型)
# OpenAI
export OPENAI_API_KEY=your-key
litellm --model gpt-3.5-turbo

# Anthropic
export ANTHROPIC_API_KEY=your-key
litellm --model claude-instant-1

# 本地VLLM
litellm --model vllm/facebook/opt-125m
python
# 通过代理调用(兼容OpenAI SDK)
from openai import OpenAI

client = OpenAI(
    api_key="temp-key",
    base_url="http://localhost:4000"  # LiteLLM代理地址
)
response = client.chat.completions.create(
    model="gpt-3.5-turbo",
    messages=[{"content": "Hello", "role": "user"}]
)
4. 嵌入模型调用(Embeddings)
python
from langchain.embeddings import OpenAIEmbeddings

# 通过代理使用Sagemaker嵌入模型
embeddings = OpenAIEmbeddings(
    model="sagemaker-embeddings",
    openai_api_base="http://localhost:4000",
    openai_api_key="temp-key"
)
text = "这是一段测试文本"
query_result = embeddings.embed_query(text)
print(query_result[:5])  # 输出嵌入向量前5个值
5. 函数调用(Function Calling)
python
import os
from litellm import completion

os.environ["LLAMA_API_KEY"] = "your-key"

# 定义工具函数
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "获取指定地点天气",
            "parameters": {
                "type": "object",
                "properties": {
                    "location": {"type": "string", "description": "城市,如北京"},
                    "unit": {"type": "string", "enum": ["celsius", "fahrenheit"]}
                },
                "required": ["location"]
            }
        }
    }
]

# 调用模型并请求工具调用
response = completion(
    model="llama3-70b",
    messages=[{"content": "北京天气如何?", "role": "user"}],
    tools=tools,
    tool_choice="auto"
)
print(response.choices[0].message.tool_calls)  # 获取函数调用指令
6. 与LangChain集成
python
from langchain_community.chat_models import ChatLiteLLM
from langchain_core.messages import HumanMessage

# 使用Cohere模型
os.environ['COHERE_API_KEY'] = "your-key"
chat = ChatLiteLLM(model="command-nightly")
messages = [HumanMessage(content="你是什么模型?")]
response = chat.invoke(messages)
print(response.content)
7. 模型路由与重试(Router)
python
from litellm import Router

# 配置路由策略(故障转移)
model_list = [
    {"model_name": "gpt-3.5-turbo", "model": "azure/gpt-35-turbo"},
    {"model_name": "gpt-3.5-turbo", "model": "openai/gpt-3.5-turbo"}  # 备用
]

router = Router(model_list=model_list)
response = router.completion(
    model="gpt-3.5-turbo",
    messages=[{"content": "Hello", "role": "user"}]
)
8. 成本管理与监控
python
# 配置日志和成本跟踪
from litellm import completion
os.environ["LITELLM_LOG"] = "true"  # 启用日志
os.environ["LANGSMITH_API_KEY"] = "your-key"  # 集成LangSmith监控

response = completion(
    model="openai/gpt-3.5-turbo",
    messages=[{"content": "Hello", "role": "user"}],
    callbacks=["langsmith"]  # 启用LangSmith回调
)
以上示例涵盖了LiteLLM的核心功能:多模型统一调用、流式响应、代理服务、嵌入模型、函数调用、第三方框架集成、路由重试和成本监控。所有调用均保持一致的输入输出格式,简化了多模型场景下的开发复杂度。