目录
问题描述
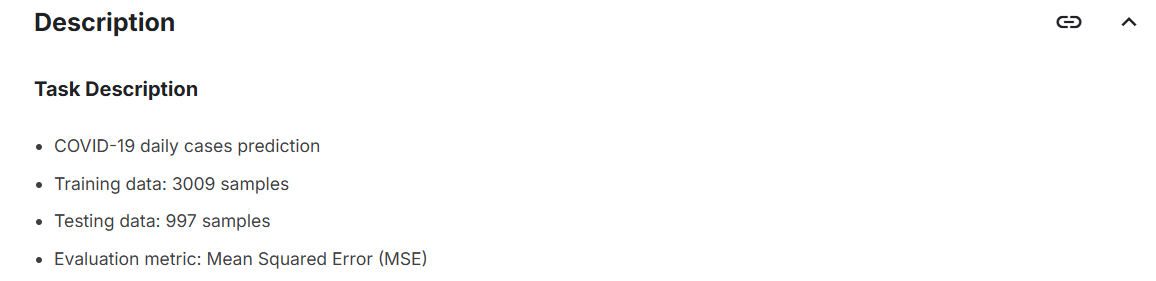
首先我们来看training_set

第一列是id,第二列到第三十五列是城市,然后后面就是feature了,将excel拖到最后一列可以看见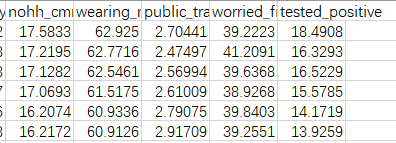
tested_positive就是我们需要预测的值,我们可以将最后一列作为label,将第一列到倒数第二列作为feature,这里我们先考虑全部feature,后面再做优化
代码
模块部分
python
# 数组操作和文件操作
import pandas as pd
import numpy as np
# 写入数据和读取
import os
import csv
import math
# 进度条
from tqdm import tqdm
# pytorch
import torch
import torch.nn as nn
from torch.utils.data import DataLoader,Dataset,random_split
# 绘制图像
from torch.utils.tensorboard import SummaryWriter
上面是我们需要用到的模块
设置种子
为了复现实验结果,我们将随机种子固定
python
ef same_seed(seed):
    # 固定随机种子,使实验可复现
    torch.backends.cudnn.deterministic = True
    # 开启cuDNN的自动优化,加速训练
    torch.backends.cudnn.benchmark = False
    # 固定numpy的随机种子
    np.random.seed(seed)
    # 固定torch的随机种子
    torch.manual_seed(seed)
    # 固定cuda的随机种子
    if torch.cuda.is_available():
        torch.cuda.manual_seed_all(seed)
划分训练集
python
# 划分数据集
def train_valid_split(data_set,valid_ratio,seed):
    # 对验证集进行数据划分
    valid_data_size = int(len(data_set) * valid_ratio)
    train_data_size = len(data_set) - valid_data_size
    train_data,valid_data = random_split(data_set,[train_data_size,valid_data_size],generator = torch.Generator().manual_seed(seed))
    return np.array(train_data),np.array(valid_data)
在PyTorch的random_split函数中,generator参数用于控制数据分割的随机性。它是一个torch.Generator对象,用于确保结果可复现。如果不指定generator,每次运行会得到不同的分割结果。
选择训练的label和feature
python
 选择训练的feature
def select_feat(train_data,valid_data,test_data,select_all = True):
    # 定义train的label,最后一列数据
    y_train = train_data[:,-1]
    # 定义valid的label,最后一列数据
    y_valid = valid_data[:,-1]

    # 定义train和valid和test的feature
    x_train = train_data[:,:-1]
    x_valid = valid_data[:,:-1]
    # 因为test数据没有最后一列所以可以直接选择feature
    x_test = test_data
    if select_all == True:
        feat_idx = list(range(x_train.shape[1]))
    else:
        feat_idx = [0,1,2,3,4]
    # 训练集的label和feature
    return y_train,x_train[:,feat_idx],y_valid,x_valid[:,feat_idx],x_test[:,feat_idx]
当select_all为False的时候我们先随便选一点,之后再做调整
封装数据集类
python
# 初始化Dataset
class COVID19Dataset(Dataset):
    # 初始化数据集
    def __init__(self,features,targets = None):
        # target为None表示是测试集
        if targets is None:
            self.targets = targets
        # 否则为训练集
        else:
            self.targets = torch.FloatTensor(targets)
        # 转换为FloatTensor
        # FloatTensor 是32位浮点数,用于存储模型的输入和输出
        self.features = torch.FloatTensor(features)
    # 获取数据集的一个样本
    def __getitem__(self, idx):
        # 如果为测试集直接返回feature
        if self.targets is None:
            return self.features[idx]
        # 否则为训练集,返回feature和label
        else:
            return self.features[idx], self.targets[idx]
    # 返回数据集的大小
    def __len__(self):
        return len(self.features)
封装model
这里model中用的函数是用的Relu作为激活函数
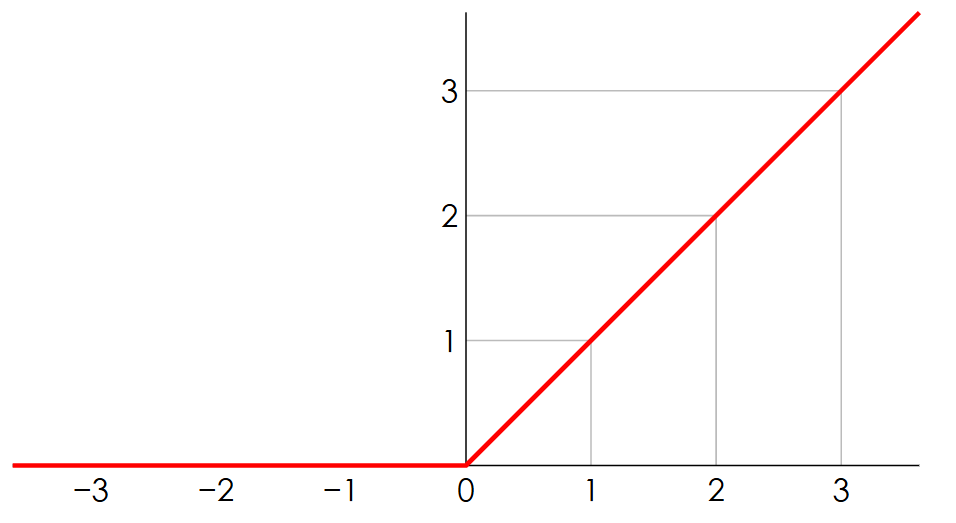
这里model继承nn当中的类
python
class My_model(nn.Module):
    def __init__(self,input_dim):
        super(My_model,self).__init__()
        self.layers = nn.Sequential(
            # 输入层到隐藏层1
            nn.Linear(input_dim, out_features = 16),
            nn.ReLU(),
            # 隐藏层1到隐藏层2
            nn.Linear(in_features = 16, out_features = 8),
            nn.ReLU(),
            # 隐藏层2到输出层
            nn.Linear(in_features = 8, out_features = 1)
        )
    def forward(self,x):
        # 前向传播
        x = self.layers(x)
        # 由于最后一层是线性层,输出的维度为1,需要 squeeze 掉最后一维
        x = x.squeeze(1)
        # 由于是回归任务,输出的结果为连续值,不需要 sigmoid 激活函数
        return x
定义参数集
python
# 如果有 GPU 可用,将模型移动到 GPU 上
device = 'cuda' if torch.cuda.is_available() else 'cpu'
config = {
    'seed' : 5201314,
    'select_all' : True,
    'valid_ratio' : 0.2,
    'n_epochs' : 3000,
    'batch_size' : 256,
    'learning_rate' : 1e-5,
    'early_stop' : 400,
    'save_path' : './model.ckpt'
}
定义训练函数
训练当中用的梯度下降法是最基础的随机梯度下降算法(可以加 momentum),这里我们就加上了momentum,最基础的梯度下降算法也就是对每个feature求偏导,然后进行验证梯度的方向下降
这里我们用的损失函数是均方误差函数

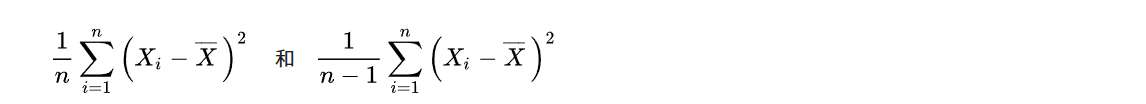
python
# 开始训练
def trainer(train_loader, valid_loader, model, config, device):
    # 定义损失函数
    criterion = nn.MSELoss(reduction='mean')
    # 定义优化器
    optimizer = torch.optim.Adam(model.parameters(), lr=config['learning_rate'])
    # 定义梯度算法
    optimizer = torch.optim.SGD(model.parameters(), lr=config['learning_rate'], momentum=0.9)
    # 定义TensorBoard,用于记录训练过程
    writer = SummaryWriter()
    if not os.path.exists('./model'):
        os.makedirs('./model')
    n_epochs = config['n_epochs']
    # 将最开始的loss设置为无穷大
    best_loss = math.inf
    # 定义早停机制
    early_stop_count = 0
    step = 0
    # 开始训练
    for epoch in range(n_epochs):
        # 将model模式设置为训练模式
        model.train()
        # 定义记录训练loss的列表
        loss_record = []
        # 将train_loader中的数据转换为迭代器
        train_pbar = tqdm(train_loader, position=0, leave=True)
        for x,y in train_pbar:
            # 重置梯度
            optimizer.zero_grad()
            # 将数据放到设备上
            x,y = x.to(device), y.to(device)
            # 预测
            pred = model(x)
            # 计算loss
            loss = criterion(pred, y)
            # 反向传播
            loss.backward()
            # 更新参数
            optimizer.step()
            step += 1
            # 将loss记录到loss_record中
            loss_record.append(loss.detach().item())
            # 更新进度条
            train_pbar.set_description(f'Epoch [{epoch+1}/{n_epochs}]')
            train_pbar.set_postfix({'loss': loss.detach().item()})
        mean_train_loss = sum(loss_record)/len(loss_record)
        writer.add_scalar('Loss/train', mean_train_loss, step)
        # 对模型进行验证

        # 将模型设置为评估模式
        model.eval()
        loss_record = []
        for x,y in valid_loader:
            # 将数据放到设备上
            x,y = x.to(device), y.to(device)
            with torch.no_grad():
                # 预测
                pred = model(x)
                # 计算loss
                loss = criterion(pred, y)
                # 将loss记录到total_loss中
            # 将loss添加到loss_record中
            loss_record.append(loss.detach().item())
        mean_valid_loss = sum(loss_record)/len(loss_record)
        # 打印验证集loss
        print(f'Epoch [{epoch+1}/{n_epochs}],Train Loss:{mean_train_loss:.4f} Valid Loss: {mean_valid_loss:.4f}')
        # 这句代码用于将验证集loss添加到TensorBoard中
        writer.add_scalar('Loss/valid', mean_valid_loss, step)
        if mean_valid_loss < best_loss:
            best_loss = mean_valid_loss
            torch.save(model.state_dict(), config['save_path'])
            print(f'Save model with loss {best_loss:.4f} at epoch {epoch+1}')
            early_stop_count = 0
        else:
            early_stop_count += 1
        if early_stop_count >= config['early_stop']:
            print(f'Early stop at epoch {epoch+1}')
            return
处理数据
python
# 开始训练
# 设置种子
same_seed = config['seed']
# 读取数据
train_data =pd.read_csv('./covid_train.csv').values
test_data = pd.read_csv('./covid_test.csv').values
# 划分训练集和验证集
train_data,valid_data = train_valid_split(train_data, config['valid_ratio'], config['seed'])
print(f'train_data.shape: {train_data.shape}')
print(f'valid_data.shape: {valid_data.shape}')
# 划分feature和label
y_train,x_train,y_valid,x_valid,x_test = select_feat(train_data, valid_data, test_data, select_all=config['select_all'])

# 构造数据集
train_set = COVID19Dataset(x_train, y_train)
valid_set = COVID19Dataset(x_valid, y_valid)
test_set = COVID19Dataset(x_test)
# 准备Dataloader
train_loader = DataLoader(train_set, batch_size=config['batch_size'], shuffle=True, pin_memory=True)
valid_loader = DataLoader(valid_set, batch_size=config['batch_size'], shuffle=True, pin_memory=True)
test_loader = DataLoader(test_set, batch_size=config['batch_size'], shuffle=False, pin_memory=True)
训练数据
python
#开始训练
model = My_model(input_dim = x_train.shape[1]).to(device)
trainer(train_loader, valid_loader, model, config, device)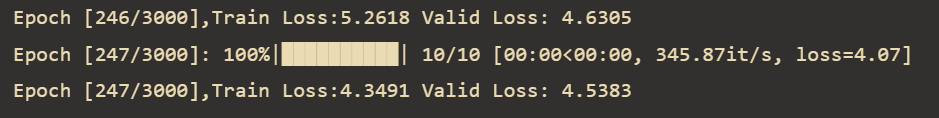
可以看到我们只训练两百多次epoch就停止训练了,valid和train的误差再0.2左右
test_set预测
python
def predict(test_loader,model,device):
    model.eval()
    predictions = []
    for x in tqdm(test_loader):
        x = x.to(device)
        with torch.no_grad():
            pred = model(x)
            predictions.append(pred.detach().cpu())
    prediction = torch.cat(predictions,dim=0).numpy()
    return prediction
python
def save_prediction(prediction,filename):
    with open(filename,'w',newline='') as f:
        writer = csv.writer(f)
        writer.writerow(['id','tested_positive'])
        for i,p in enumerate(prediction):
            writer.writerow([i,p])
进行test_set的预测
python
model = My_model(input_dim = x_train.shape[1]).to(device)
model.load_state_dict(torch.load(config['save_path']))
prediction = predict(test_loader,model,device)
save_prediction(prediction,'pred.csv')
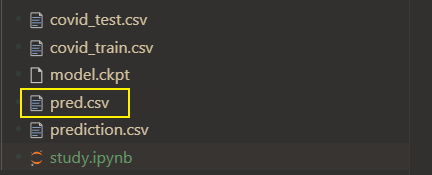
预测的csv文件我们将其保存在当前路径下,方便提交
可以看见预测的loss在1.35,也算及格了
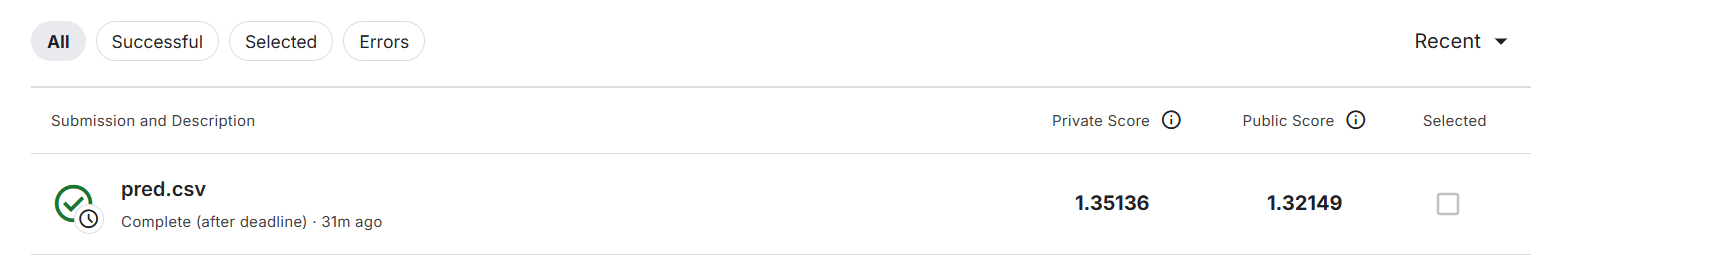
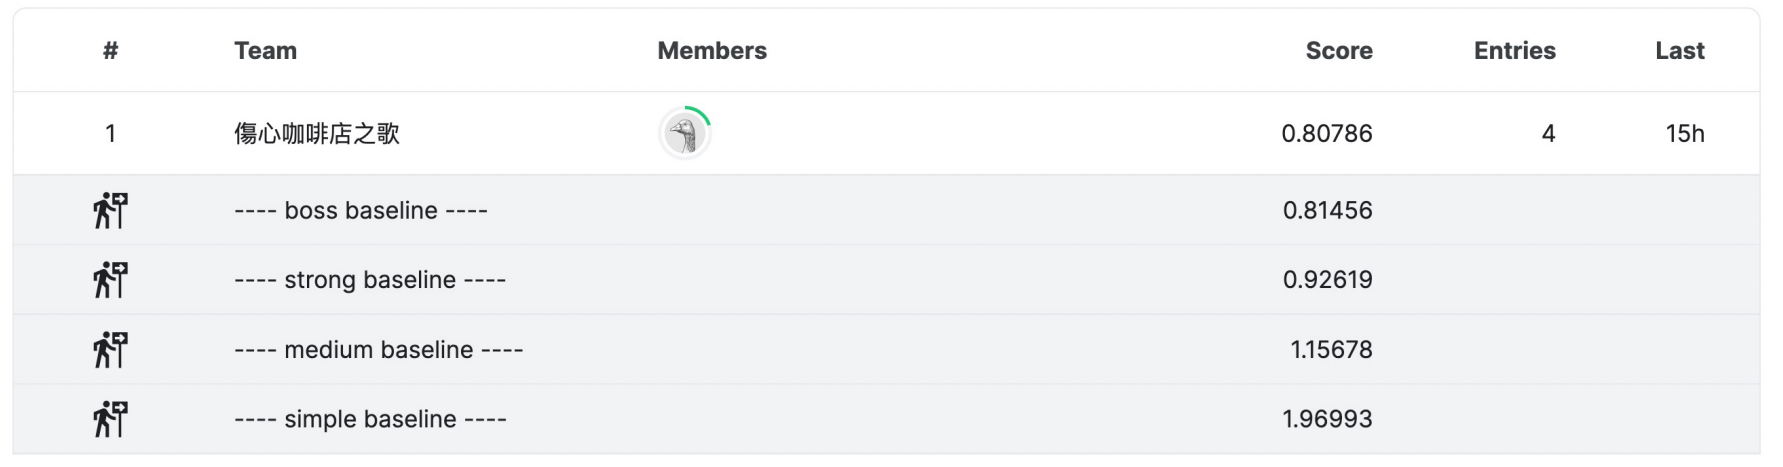
刚好达到了李宏毅的及格线