摘要
主要内容概括:
传统的FL在不同客户端数据分布不一致时常导致模型性能下降。为此,作者借助**多模态大语言模型(Multimodal Large Language Models, MLLMs)**的强大跨模态表示与知识泛化能力(如GPT-4V、LLaVA),提出了一个由服务器端MLLM辅助的联邦学习框架。
该框架的核心思想是:
-
在服务器端 利用MLLM进行跨模态预训练(visual-text pretraining),充分利用互联网上的开源多模态数据;
-
客户端只需在本地进行轻量化的模型微调,减少计算负担和隐私风险;
-
服务器端 再在MLLM监督下进行全局模型对齐(global alignment),以进一步提升性能。
⚙️ 主要创新与优势:
-
结合MLLM能力:利用其开放词汇知识和视觉语言理解能力增强联邦学习;
-
数据利用更充分:借助服务器端计算与公开数据进行大规模预训练;
-
隐私与效率兼顾:不增加客户端计算开销,也不提高隐私泄露风险;
-
性能提升显著:在存在数据异质性与长尾分布的典型场景中取得了更好的实验结果。
引言
一、研究背景与问题动机
-
问题核心 :联邦学习(Federated Learning, FL)面临**数据异质性(heterogeneity)和长尾分布(long-tail distribution)**问题。
-
各客户端的数据分布不同,导致模型偏向常见类别、总体精度下降。
-
现有方法要么增加隐私风险(如传输梯度、参数可能泄露图像信息),要么增加客户端计算负担(如需部署大型模型)。
-
-
挑战总结:
-
如何在不泄露隐私的前提下缓解数据异质性?
-
如何避免让资源受限的客户端承担过高计算负荷?
-
⚙️ 二、提出的方法:MLLM-LLaVA-FL 框架
论文借助多模态大语言模型(Multimodal Large Language Models, MLLMs) (如 LLaVA、GPT-4V)的跨模态理解和知识泛化能力,提出了一个三阶段联邦学习框架,充分利用服务器端算力与网络公开数据资源:
-
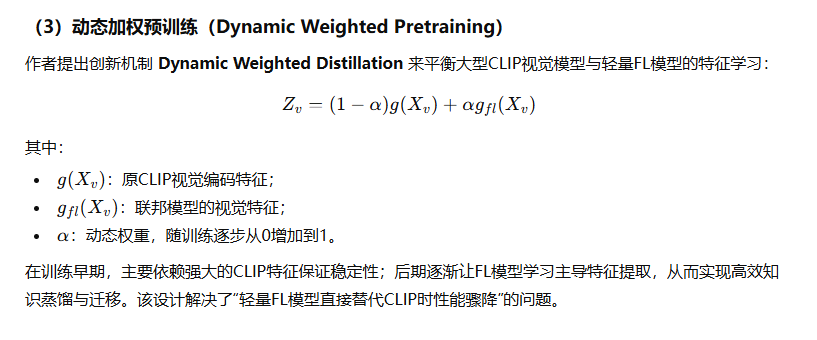
全局多模态预训练(Global Multimodal Pretraining)
-
使用MLLM为互联网上的无标签图像生成详细文本描述;
-
提出**动态加权预训练(Dynamic Weighted Pretraining, DWP)**策略,使轻量级FL模型能高效学习多模态特征。
-
-
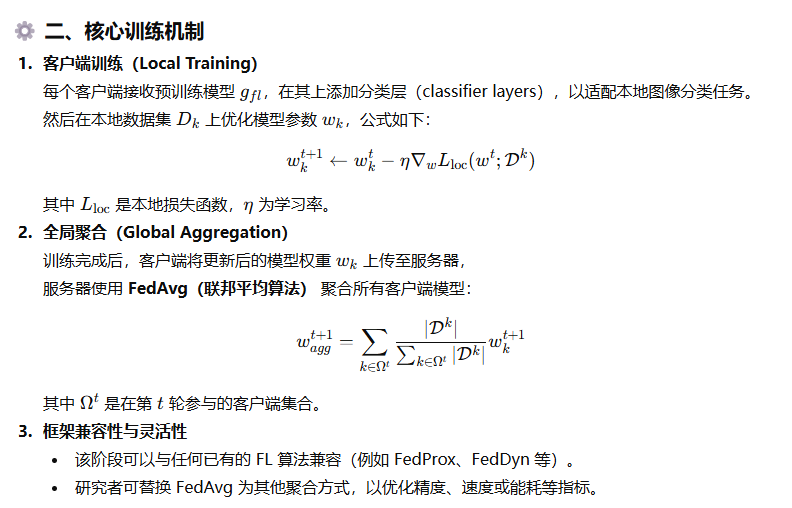
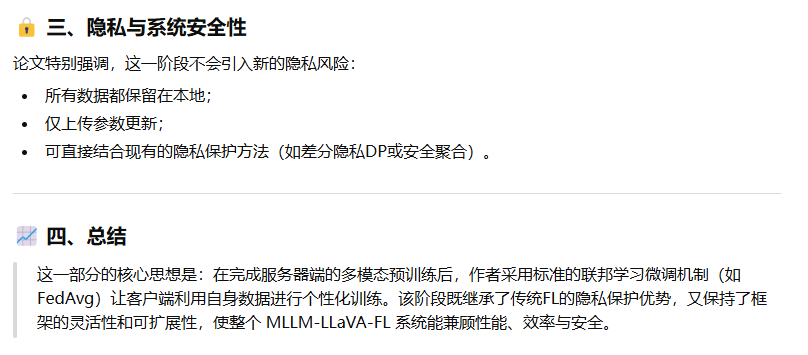
联邦微调(Federated Fine-Tuning)
-
将预训练模型下发给各客户端,进行本地微调;
-
兼容现有各种FL算法,保持框架灵活性。
-
-
全局对齐(Global Alignment)
-
聚合客户端模型后,在服务器端由MLLM监督进行全局模型对齐(类似LLM中的"对齐"过程);
-
进一步提高模型在异质与长尾数据下的泛化与公平性。
-
🚀 三、主要贡献与创新点
-
首次将多模态大语言模型引入FL
-
充分利用互联网开放数据和服务器算力,实现跨模态知识辅助训练;
-
缓解了数据异质性和长尾分布问题。
-
-
隐私友好且计算高效
-
不需要上传梯度或参数,避免隐私泄露风险;
-
客户端仅做轻量本地训练,大幅降低计算与内存压力。
-
-
实验结果显著
- 在多个联邦学习基准数据集上,MLLM-LLaVA-FL 在异质数据和类别不均衡场景中均显著优于现有方法。
相关工作
🧠 第一部分:2.1 Multimodal Large Language Model(多模态大语言模型)
这一部分回顾了多模态大模型在视觉、文本、视频和音频等跨模态任务中的发展与代表性工作,强调了它们在"理解+生成"两方面的强大能力。
主要内容:
-
发展背景: GPT-4(Vision) 与 Gemini 等模型的推出,展示了多模态大模型在视觉理解、图像描述、视频分析和语音-文本理解上的强大性能。
-
主要研究方向:
-
图像-文本理解(image-text comprehension)
-
视频-文本理解(video-text understanding)
-
音频-文本理解(audio-text understanding)
-
-
代表性模型:
-
Visual ChatGPT:结合多种视觉基础模型,通过多轮反馈实现视觉与文本的协同推理。
-
MM-REACT:融合ChatGPT与视觉模型,用于多模态问答(VQA)。
-
BLIP-2:通过Q-former实现高效的视觉-语言配对学习,在零样本和微调任务上表现出色。
-
LLaMA-Adapter:通过可调节提示向量提升多模态微调效率。
-
MiniGPT-4:结合BLIP-2与Vicuna,在图像描述与模型精调上效果突出。
-
LLaVA:以GPT-4为核心,采用双阶段指令微调策略,实现从图像描述到多轮问答的广泛任务能力。
-
👉 小结:
这一节说明多模态大语言模型能跨越视觉与语言边界,为多模态理解和生成提供强大支持,也为后文中"MLLM辅助联邦学习"提供了理论依据和可用工具(如LLaVA、BLIP-2等)。
⚙️ 第二部分:2.2 Federated Learning with Heterogeneous Data(异质数据下的联邦学习)
这一部分系统梳理了当前联邦学习在应对数据异质性 与长尾分布方面的主要思路及其不足。
主要内容:
-
主流方法分类:
-
优化方法类(Optimization-based) :
同时改进客户端与服务器模型优化过程(如10,17,18,26),但仍难兼顾性能与隐私。
-
知识迁移类(Knowledge Transfer) :
通过在客户端间传播知识缓解异质性(如4,55,61),模型无关但对语义指导不足。
-
模型聚合类(Aggregation-based) :
在服务器端改进聚合策略(如2,30)。
-
调度策略类(Client Scheduling) :
通过控制客户端参与频率减少模型偏向常见类别(如56,63)。
-
-
局限性:
现有方法多集中于优化异质性,但对长尾分布(少数类样本不足)问题应对不足。
-
代表性新方法:
-
CReFF:通过解耦策略生成平衡的联邦特征,但依赖梯度信息,存在两大缺陷:
-
梯度与样本间一对多关系导致问题不适定;
-
缺乏语义指导,生成特征判别性差。
-
-
CLIP2FL:尝试用多模态模型(CLIP)提供语义指导,但问题依旧:
-
CLIP模型太大,部署在设备上计算/内存成本高;
-
上传梯度和参数带来隐私风险(可被反推恢复图像)。
-
-
👉 小结:
这一节指出现有FL方法要么牺牲隐私,要么计算代价高,且无法充分解决异质性与长尾分布问题,因此需要一种结合强语义理解、轻客户端负担、隐私友好 的新框架------这正是后续MLLM-LLaVA-FL提出的动机。
方法
一、总体框架结构:三阶段式联邦学习
作者在传统联邦学习(FL)框架的基础上,增加了两个额外阶段,以更贴近实际应用需求并解决数据异质性问题:
-
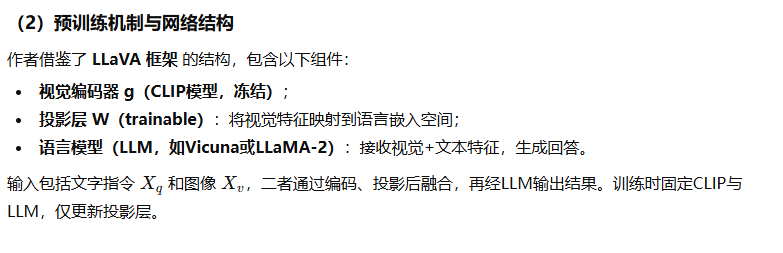
全局多模态预训练(Global Multimodal Pretraining) :
在本地训练前,于服务器端利用多模态大语言模型(MLLM)对公开多模态数据(如图像+文本)进行预训练,以增强模型的表示能力和泛化性。
-
联邦本地微调(Federated Local Fine-tuning) :
将预训练模型下发至各客户端进行个性化微调,类似传统FL流程。
-
全局对齐(Global Alignment) :
在聚合后,服务器端进一步基于MLLM进行模型对齐(alignment),以满足企业或系统对性能与安全的综合要求。
⚙️ 二、全局多模态预训练(Global Multimodal Pretraining)
(1)预训练数据构建
利用 GPT-4(类似LLaVA方法)自动为互联网上的无标注图像生成三类高质量文本数据,从而将原本噪声大、难以直接使用的数据转化为可用于预训练的多模态样本:
-
Conversation(对话类):基于图像的问答式对话,涉及识别、计数、空间位置等内容;
-
Detailed Description(详细描述):通过精心设计的问题,引导模型生成对图像的细致文字描述;
-
Complex Reasoning(复杂推理):围绕图像内容生成需要逻辑推演和深度理解的问答。
这三类数据能帮助模型获得更强的图文语义对齐与推理能力。
联邦微调
全局对齐
🧩 一、阶段背景与动机
作者指出:在联邦学习中,经过各客户端训练与模型聚合后,最终的全局模型仍可能存在以下问题:
-
隐私风险:模型可能间接泄露用户数据特征。
-
性能偏差:由于客户端数据分布不均(长尾分布),模型容易偏向高频类别。
-
技能不足:模型可能需要在新数据或任务上进一步优化。
这些问题与大型语言模型在"对齐"阶段的挑战类似,因此作者借鉴了**人类反馈强化学习(RLHF)等对齐理念,提出在联邦聚合后增加全局对齐阶段(Global Alignment)**来提升模型的整体表现和安全性。
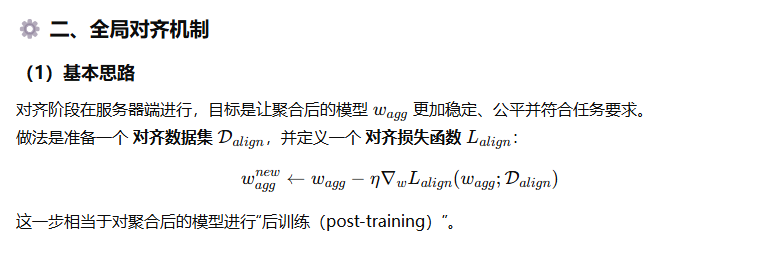
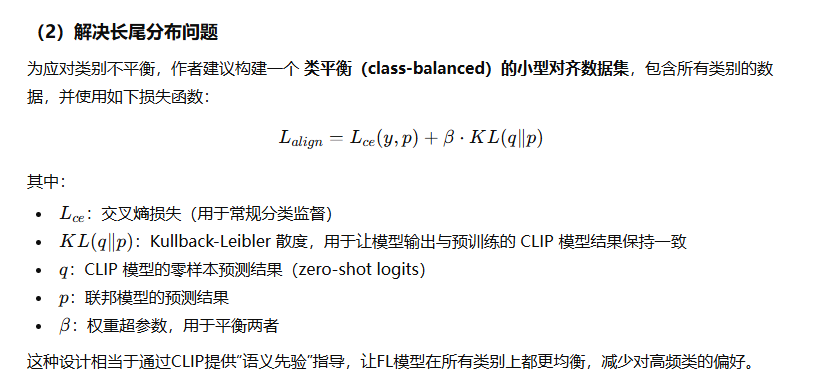
三、数据来源与可行性
作者指出,这种对齐数据集在实际中可由服务器端构建,理由包括:
-
在FL聚合时,服务器本身知道所有类别的定义;
-
企业可从公开网络数据或**生成式模型(如Stable Diffusion、Midjourney)**中收集平衡数据样本;
-
若部分场景中难以收集到足够数据,可设计更有针对性的损失函数 LalignL_{align}Lalign 来替代。
实验设置
一、实验目的与框架应用
作者将他们提出的 MLLM-LLaVA-FL 框架应用于典型的长尾(long-tailed)图像分类任务,以验证其在非独立同分布(non-IID)数据环境下的鲁棒性和性能表现。
实验重点在于评估该框架在数据异质性和类别不平衡条件下,相比其他联邦学习方法能否取得更优的分类精度与稳定性。
🧠 二、数据集与划分策略
作者选用了三个具有代表性的长尾视觉数据集(Long-Tailed Datasets):
-
CIFAR-10-LT / CIFAR-100-LT
-
来自经典 CIFAR 数据集,通过不均衡采样得到长尾版本;
-
使用与文献 7 相同的采样方法;
-
设定不同的不平衡因子(Imbalance Factor, IF = 100, 50, 10);
-
使用 Dirichlet 分布(α=0.5) 来生成异质客户端数据划分(即每个客户端拥有不同类别比例)。
-
-
ImageNet-LT
-
含有约 115,800 张图像,共 1000 类,每类图像数从 1280 到 5 不等;
-
使用 α=0.1 的 Dirichlet 分布 进行划分。
-
这种划分方式保证了实验能模拟真实联邦环境中常见的数据不均衡与分布差异。
⚙️ 三、模型与训练细节
-
特征提取器(Feature Extractor):
-
CIFAR-10/100-LT 使用 ResNet-8
-
ImageNet-LT 使用 ResNet-50
-
在每个模型后添加一个 MLP 层 来匹配 CLIP 的特征维度(实现模态对齐)。
-
-
联邦学习设置:
-
客户端总数:20 个;
-
每轮选取其中 40% 客户端参与训练;
-
本地批量大小(Batch Size):32;
-
共进行 200 轮通信(communication rounds);
-
使用标准的交叉熵损失(cross-entropy loss)。
-
-
预训练(Pretraining)设置:
-
采用 LLaVA 的公开预训练数据集 CC-595K;
-
训练 4 个 epoch;学习率为 2e-3,batch size 为 128;
-
预训练中的动态加权因子 α 在前 2 个 epoch 从 0 到 1(余弦调度),后 2 个 epoch 固定为 1;
-
全部实验使用 PyTorch 框架,在 NVIDIA A100 80G GPU 上运行。
-
📊 四、对比方法(Baselines)
为了全面验证框架性能,作者选取了 13 种联邦学习算法进行对比,分为两类:
(1)面向异质性(Heterogeneity-Oriented)方法:
-
FedAvg 36
-
FedAvgM 16
-
FedProx 29
-
FedDF 46
-
FedBE 2
-
CCVR 34
-
FedNova 50
(2)面向类别不平衡(Imbalance-Oriented)方法:
-
Fed-Focal Loss 43
-
Ratio Loss 51
-
FedAvg with τ-norm 23
-
CReFF 44
-
CLIP2FL 45
前一类方法着重缓解客户端间数据分布不一致问题,后一类则针对长尾数据的类别不平衡。
实验结果
一、实验总体目标
作者通过在 CIFAR-10-LT、CIFAR-100-LT 和 ImageNet-LT 三个标准长尾数据集上的实验,系统评估了 MLLM-LLaVA-FL 相较于现有方法(包括 CLIP2FL、CReFF 等)的分类性能,以验证其在联邦学习场景下处理非IID与长尾分布问题的有效性。
📊 二、CIFAR-10/100-LT 实验结果
结果展示在 Table 2 中,主要结论如下:
-
整体表现优异:
MLLM-LLaVA-FL 在 CIFAR-10-LT 和 CIFAR-100-LT 上的分类准确率均超过了所有其他对比方法。
-
严重不平衡场景(Imbalance Factor = 100):
-
在 CIFAR-10-LT 上准确率提升 约 2.12%;
-
在 CIFAR-100-LT 上提升 约 1.94% ;
相比 CLIP2FL(此前最强基线),在极度数据不平衡的情况下仍保持明显优势。
-
-
中等不平衡场景(IF = 50, 10):
即使类别分布较为平衡时,MLLM-LLaVA-FL 依然取得约 1% 的准确率提升,证明其稳定的泛化与鲁棒性。
🔹 结论:
该结果说明引入多模态大模型(MLLM)的辅助预训练与全局对齐机制,能显著增强联邦模型在非IID、长尾数据环境下的性能表现。
🧠 三、ImageNet-LT 实验结果
结果展示在 Table 3 中,采用更复杂、更大规模的数据集以验证模型的泛化能力。
-
实验按照每类样本数量划分为四个区间:
-
Many(>100样本)
-
Medium(20--100样本)
-
Few(<20样本)
-
All(总体准确率)
-
-
结果分析:
-
在 "Many" 类别(样本充足)中,MLLM-LLaVA-FL 略低于 CReFF;
-
但在 "Medium" 与 "Few" 类别 (数据稀缺)上表现显著优于其他方法;
-
在总体准确率(All)上,MLLM-LLaVA-FL 实现了最佳性能。
-
🔹 结论:
该框架不仅能提升整体分类准确率,还特别改善了样本稀缺类别(long-tail classes)的性能,证明其在解决长尾分布挑战方面的有效性。
✅ 四、总结
本段的核心结论是:
MLLM-LLaVA-FL 在多个长尾联邦学习基准数据集上均显著优于现有方法,尤其在样本稀缺与异质数据场景下表现突出。其结合了大模型的跨模态知识与联邦框架的隐私优势,实现了在精度、稳定性与泛化性方面的全面提升。
未来分析
一、章节概览
本节包含三个小节,核心目的是:
-
验证 全局预训练机制(global pretraining) 的作用;
-
验证 全局对齐机制(global alignment) 的重要性;
-
从 隐私性、计算效率与兼容性 三个角度探讨整个框架的实际价值。
🧠 4.3.1 全局预训练机制的消融实验
✳️ 实验设计
-
为验证"预训练"的作用,作者对比了:
-
使用全局预训练的模型;
-
未经过预训练、直接在客户端本地数据上训练的模型。
-
-
实验采用 CIFAR-10 和 CIFAR-100 数据集,并模拟"小样本学习(few-shot)"场景,模拟现实中每个设备可用数据量有限的情况。
-
对两个模型在不同数据规模下进行了 30 个 epoch 的训练,记录:
-
达到目标精度所需的 epoch 数;
-
在 30 轮内的最高准确率。
-
📊 实验结果
-
在 CIFAR-10 上:预训练模型达到 25% 准确率所需 epoch 显著更少;
-
在 CIFAR-100 上:达到 15% 准确率也更快、更高效;
-
图 3 显示,预训练模型整体精度明显优于从零训练(scratch)模型。
✅ 结论:
全局预训练阶段能显著加快模型收敛速度、提升小样本条件下的表现,有效缓解联邦学习中由于数据稀疏和异质性造成的性能下降。
🎯 4.3.2 全局对齐机制的消融实验
✳️ 实验设计
-
在 CIFAR-10-LT(IF=100) 上比较两种模型:
-
含有全局对齐机制的 MLLM-LLaVA-FL;
-
不含对齐机制的基线联邦模型。
-
-
通过绘制**混淆矩阵(confusion matrix)**观察不同类别的分类准确性。
📈 实验结果
-
含对齐机制的模型能使每个类别的数据更准确地被分类;
-
未对齐的模型在"少样本类"上误分类明显,尤其容易将少数类误判为多数类;
-
对齐机制显著改善了长尾类别的识别效果,使整体模型更公平(fair)与稳定(robust)。
✅ 结论:
全局对齐阶段不仅提升整体精度,还有效缓解了长尾分布带来的类别偏差问题,增强了模型在联邦环境中的公平性。
🔒 4.3.3 综合讨论(Discussion)
本节从三个实际角度分析了框架的现实优势:
🛡️ (1)隐私性(Privacy)
-
与 CReFF、CLIP2FL 等方法不同,本框架不需要客户端上传梯度(gradients);
-
避免了梯度反向推理攻击(gradient inversion attack)的风险;
-
提高了数据保密性与隐私安全性,符合联邦学习"数据不出端"的核心理念。
⚙️ (2)计算效率(Computational Efficiency)
-
其他方法(如 CLIP2FL)要求在客户端部署大型多模态模型(如 CLIP),内存与计算开销巨大;
-
本框架将 MLLM 完全部署在服务器端,客户端只保留轻量级的 FL 模型;
-
优势:
-
显著降低计算与存储压力;
-
减少本地训练时间与能耗;
-
更适合边缘设备(edge devices)与资源受限场景。
-
🔄 (3)兼容性(Compatibility)
-
本框架设计灵活,可与多种现有 FL 算法结合使用,包括不同的:
-
客户端选择策略;
-
隐私增强机制;
-
聚合算法(如 FedAvg、FedProx 等);
-
-
与 CReFF、CLIP2FL 这类对特定流程依赖强的模型不同,MLLM-LLaVA-FL 具备模块化和可扩展性。
✅ 结论:
该框架不仅在性能上表现优越,也在隐私保护、计算资源占用和算法兼容性方面展现出高度的实用性与工程价值。