锋哥原创的PyTorch2 Python深度学习视频教程:
https://www.bilibili.com/video/BV1eqxNzXEYc
课程介绍
基于前面的机器学习Scikit-learn,深度学习Tensorflow2课程,我们继续讲解深度学习PyTorch2,所以有些机器学习,深度学习基本概念就不再重复讲解,大家务必学习好前面两个课程。本课程主要讲解基于PyTorch2的深度学习核心知识,主要讲解包括PyTorch2框架入门知识,环境搭建,张量,自动微分,数据加载与预处理,模型训练与优化,以及卷积神经网络(CNN),循环神经网络(RNN),生成对抗网络(GAN),模型保存与加载等。
PyTorch2 Python深度学习 - 数据集与数据加载
在 PyTorch 的训练流程中,数据读取与预处理 通常分为两部分:
-
Dataset(数据集类) 负责定义样本获取方式,即"如何读一条数据"。
-
DataLoader(数据加载器) 负责批量加载与并行加速,即"如何读多条数据"。
这两者的配合实现了高效的数据输入管线。
PyTorch 领域库提供了许多预加载的数据集(例如 FashionMNIST),这些数据集可以子类化torch.utils.data.Dataset并实现特定于特定数据的函数。它们可用于对模型进行原型设计和基准测试。
1,加载数据
以下是如何从 TorchVision 加载Fashion-MNIST数据集的示例。Fashion-MNIST 是 Zalando 商品图片的数据集,包含 60,000 个训练样本和 10,000 个测试样本。每个样本包含一张 28×28 的灰度图像以及 10 个类别中对应类别的标签。
Dataset 是一个抽象类。 自定义数据集时需重写两个关键方法:
| 方法 | 作用 |
|---|---|
__len__(self) |
返回数据集中样本数量 |
__getitem__(self, index) |
根据索引返回单个样本 (data, label) |
示例代码:
import torch
from torch.utils.data import Dataset
from torchvision import datasets
training_data = datasets.FashionMNIST(
root="data",
train=True,
download=True
)
print('训练集:')
print(training_data.__len__())
print(training_data.__getitem__(0))
print(training_data.targets)
test_data = datasets.FashionMNIST(
root="data",
train=False,
download=True
)
print('测试集:')
print(test_data.__len__())
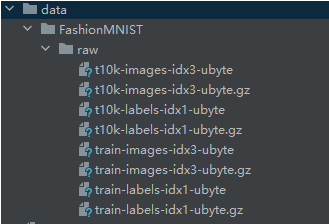
print(test_data.__getitem__(0))运行后,下载数据集到相对目录
运行输出:
训练集:
60000
(<PIL.Image.Image image mode=L size=28x28 at 0x1601FE917D0>, 9)
tensor([9, 0, 0,  ..., 3, 0, 5])
测试集:
10000
(<PIL.Image.Image image mode=L size=28x28 at 0x1602387ED90>, 9)
2,遍历和可视化数据
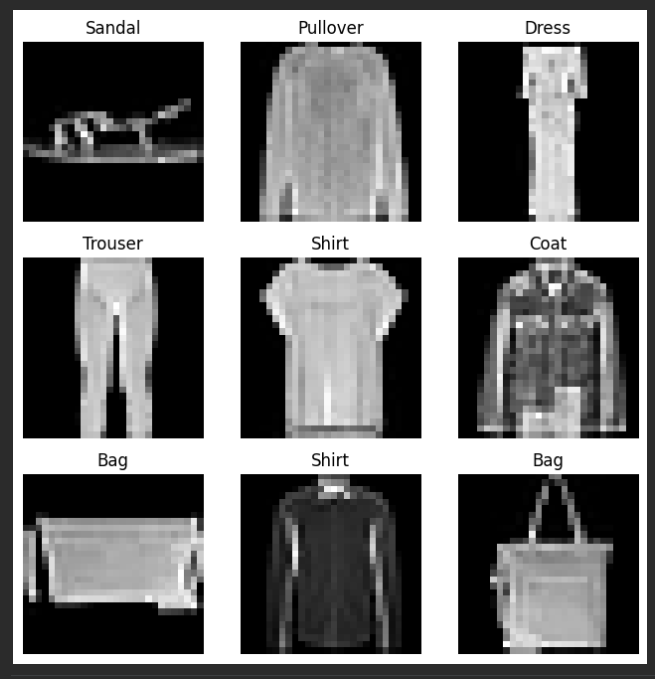
Datasets我们可以像列表一样手动索引: training_data[index]。我们用它matplotlib来可视化训练数据中的某些样本。
我们先安装下matplotlib,和 jupyter
pip install matplotlib -i https://pypi.tuna.tsinghua.edu.cn/simple

pip install jupyter -i https://pypi.tuna.tsinghua.edu.cn/simple
示例:
import matplotlib.pyplot as plt
labels_map = {
0: "T-Shirt",
1: "Trouser",
2: "Pullover",
3: "Dress",
4: "Coat",
5: "Sandal",
6: "Shirt",
7: "Sneaker",
8: "Bag",
9: "Ankle Boot",
}
figure = plt.figure(figsize=(8, 8))
cols, rows = 3, 3
for i in range(1, cols * rows + 1):
sample_idx = torch.randint(len(training_data), size=(1,)).item()
img, label = training_data[sample_idx]
figure.add_subplot(rows, cols, i)
plt.title(labels_map[label])
plt.axis("off")
plt.imshow(img, cmap="gray")
plt.show()运行输出:
3,使用 DataLoaders 准备训练
它Dataset会检索数据集的特征,并一次标记一个样本。在训练模型时,我们通常希望以"小批量"的形式传递样本,在每个周期重新调整数据以减少模型过拟合,并使用 Pythonmultiprocessing来加速数据检索。
DataLoader是一个可迭代对象,它通过一个简单的 API 为我们抽象了这种复杂性。
DataLoader是PyTorch中用于批量加载数据的工具类,它将training_data数据集按照指定的batch_size=64进行分批处理,并通过shuffle=True参数在每个训练周期开始时随机打乱数据顺序,以提高模型训练效果。
train_dataloader = DataLoader(training_data, batch_size=64, shuffle=True)
test_dataloader = DataLoader(test_data, batch_size=64, shuffle=True)