小白中文Python-双色球LSTM模型出号程序
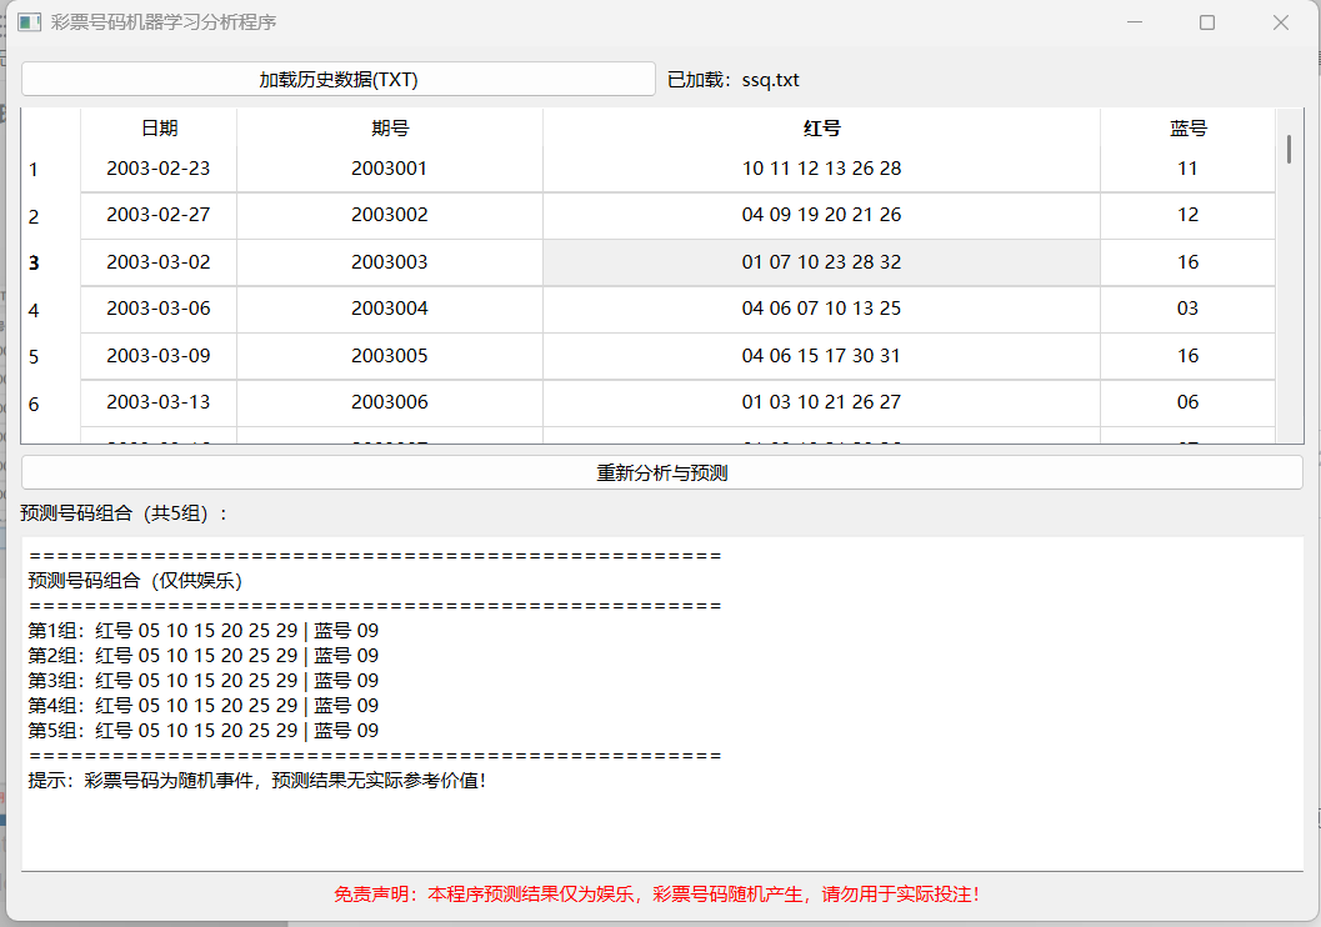
本文介绍了一个基于LSTM神经网络的双色球号码预测程序,采用Python+PySide6开发,具有以下功能: 支持加载历史开奖数据(TXT格式)并展示 使用LSTM模型对红球(6个)和蓝球(1个)分别建模预测 提供5组预测号码供参考,含可视化界面 包含数据标准化、滑动窗口处理等技术细节 特别注明预测结果仅供娱乐,强调彩票的随机性 程序采用Keras构建神经网络,通过Qt实现交互界面,适合机器学习初学者研究时序预测应用。
python
import sys
import random
import numpy as np
import pandas as pd
from PySide6.QtWidgets import (QApplication, QMainWindow, QWidget, QVBoxLayout, QHBoxLayout,
                               QTableWidget, QTableWidgetItem, QPushButton, QTextEdit, QLabel,
                               QFileDialog, QMessageBox)
from PySide6.QtCore import Qt
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import LSTM, Dense, Dropout
from sklearn.preprocessing import MinMaxScaler
from sklearn.utils import shuffle

class LotteryAnalysisWindow(QMainWindow):
    def __init__(self):
        super().__init__()
        self.setWindowTitle("彩票号码机器学习分析程序")
        # 窗口大小缩小30%(原1200x800 → 840x560)
        self.setGeometry(100, 100, 840, 560)

        # 初始化数据
        self.raw_data = None
        self.scaler_red = MinMaxScaler(feature_range=(0, 1))
        self.scaler_blue = MinMaxScaler(feature_range=(0, 1))

        # 构建界面
        self.init_ui()

    def init_ui(self):
        # 中心部件
        central_widget = QWidget()
        self.setCentralWidget(central_widget)

        # 主布局
        main_layout = QVBoxLayout(central_widget)

        # 1. 数据加载区域
        load_layout = QHBoxLayout()
        self.load_btn = QPushButton("加载历史数据(TXT)")
        self.load_btn.clicked.connect(self.load_data)
        self.file_label = QLabel("未加载文件")
        load_layout.addWidget(self.load_btn)
        load_layout.addWidget(self.file_label)
        main_layout.addLayout(load_layout)

        # 2. 数据表格区域
        self.table = QTableWidget()
        self.table.setColumnCount(4)
        self.table.setHorizontalHeaderLabels(["日期", "期号", "红号", "蓝号"])
        self.table.horizontalHeader().setStretchLastSection(True)
        main_layout.addWidget(self.table)

        # 3. 功能按钮区域
        btn_layout = QHBoxLayout()
        self.analyze_btn = QPushButton("重新分析与预测")
        self.analyze_btn.clicked.connect(self.analyze_and_predict)
        self.analyze_btn.setEnabled(False)
        btn_layout.addWidget(self.analyze_btn)
        main_layout.addLayout(btn_layout)

        # 4. 预测结果显示区域
        result_label = QLabel("预测号码组合(共5组):")
        main_layout.addWidget(result_label)
        self.result_text = QTextEdit()
        self.result_text.setReadOnly(True)
        main_layout.addWidget(self.result_text)

        # 添加免责声明
        disclaimer = QLabel('<font color="red">免责声明:本程序预测结果仅为娱乐,彩票号码随机产生,请勿用于实际投注!</font>')
        disclaimer.setAlignment(Qt.AlignCenter)
        main_layout.addWidget(disclaimer)

    def load_data(self):
        """加载TXT格式的历史数据"""
        file_path, _ = QFileDialog.getOpenFileName(
            self, "选择历史数据文件", "", "Text Files (*.txt)"
        )
        if not file_path:
            return

        try:
            # 读取文件并解析
            data = []
            with open(file_path, 'r', encoding='utf-8') as f:
                lines = f.readlines()
                for line in lines:
                    line = line.strip()
                    if not line:
                        continue
                    # 按逗号分割(处理逗号前后的空格)
                    parts = [p.strip() for p in line.split(',')]
                    if len(parts) >= 6:
                        date = parts[0]
                        period = parts[1]
                        red_balls = parts[2]
                        blue_ball = parts[3]
                        data.append([date, period, red_balls, blue_ball])

            # 更新表格
            self.table.setRowCount(len(data))
            for row_idx, row_data in enumerate(data):
                for col_idx, value in enumerate(row_data):
                    item = QTableWidgetItem(value)
                    item.setTextAlignment(Qt.AlignCenter)
                    self.table.setItem(row_idx, col_idx, item)

            # 保存原始数据用于分析
            self.raw_data = data
            self.file_label.setText(f"已加载:{file_path.split('/')[-1]}")
            self.analyze_btn.setEnabled(True)
            self.result_text.clear()

            # 加载成功信息输出到信息框
            self.result_text.append(f"✅ 成功加载 {len(data)} 条历史数据!")

        except Exception as e:
            # 错误信息用print输出
            print(f"加载数据失败:{str(e)}")
            self.result_text.append(f"❌ 加载数据失败,请检查文件格式!")

    def preprocess_data(self):
        """数据预处理:将号码转换为模型输入格式"""
        if not self.raw_data:
            return None, None

        # 提取红号和蓝号的数值数据
        red_sequences = []
        blue_sequences = []

        for row in self.raw_data:
            # 解析红号(6个数字)
            red_nums = list(map(int, row[2].split()))
            # 解析蓝号(1个数字)
            blue_num = int(row[3])

            red_sequences.append(red_nums)
            blue_sequences.append(blue_num)

        # 转换为numpy数组
        red_data = np.array(red_sequences)  # (n_samples, 6)
        blue_data = np.array(blue_sequences)  # (n_samples,)

        # 数据归一化(红号:1-33,蓝号:1-16)
        red_scaled = self.scaler_red.fit_transform(red_data)

        # 构建时间序列输入(使用前look_back期预测下一期)
        look_back = 5  # 用前5期数据预测下一期
        X_red, y_red = [], []
        X_blue, y_blue = [], []

        # 构建红号的时间序列数据
        for i in range(look_back, len(red_scaled)):
            X_red.append(red_scaled[i-look_back:i])
            y_red.append(red_scaled[i])

        # 构建蓝号的时间序列数据
        blue_scaled = self.scaler_blue.fit_transform(blue_data.reshape(-1, 1)).flatten()
        for i in range(look_back, len(blue_scaled)):
            X_blue.append(blue_scaled[i-look_back:i].reshape(-1, 1))
            y_blue.append(blue_scaled[i])

        # 转换为模型输入格式
        X_red = np.array(X_red)  # (samples, look_back, 6)
        y_red = np.array(y_red)  # (samples, 6)
        X_blue = np.array(X_blue)  # (samples, look_back, 1)
        y_blue = np.array(y_blue)  # (samples,)

        return (X_red, y_red, X_blue, y_blue)

    def build_lstm_model(self, input_shape, output_dim):
        """构建LSTM模型"""
        model = Sequential([
            LSTM(64, return_sequences=True, input_shape=input_shape),
            Dropout(0.2),
            LSTM(32),
            Dropout(0.2),
            Dense(output_dim, activation='linear')
        ])
        model.compile(optimizer='adam', loss='mse')
        return model

    def train_models(self):
        """训练红号和蓝号的LSTM模型"""
        preprocessed = self.preprocess_data()
        if not preprocessed:
            return None, None

        X_red, y_red, X_blue, y_blue = preprocessed

        try:
            # 训练红号模型
            red_model = self.build_lstm_model((X_red.shape[1], X_red.shape[2]), 6)
            red_model.fit(X_red, y_red, epochs=50, batch_size=8, verbose=0, validation_split=0.2)

            # 训练蓝号模型
            blue_model = self.build_lstm_model((X_blue.shape[1], X_blue.shape[2]), 1)
            blue_model.fit(X_blue, y_blue, epochs=50, batch_size=8, verbose=0, validation_split=0.2)

            return red_model, blue_model
        except Exception as e:
            # 错误信息用print输出
            print(f"模型训练失败:{str(e)}")
            return None, None

    def predict_numbers(self, red_model, blue_model, n_groups=5):
        """预测号码组合"""
        if not self.raw_data or not red_model or not blue_model:
            return []

        # 获取最新的look_back期数据用于预测
        look_back = 5
        latest_red = []
        latest_blue = []

        # 提取最新的look_back期数据
        for i in range(-look_back, 0):
            if len(self.raw_data) + i >= 0:
                # 红号
                red_nums = list(map(int, self.raw_data[i][2].split()))
                latest_red.append(red_nums)
                # 蓝号
                latest_blue.append(int(self.raw_data[i][3]))

        # 数据归一化
        latest_red_scaled = self.scaler_red.transform(np.array(latest_red))
        latest_blue_scaled = self.scaler_blue.transform(np.array(latest_blue).reshape(-1, 1)).flatten()

        predictions = []

        try:
            for _ in range(n_groups):
                # 预测红号
                red_input = latest_red_scaled.reshape(1, look_back, 6)
                red_pred_scaled = red_model.predict(red_input, verbose=0)[0]
                red_pred = self.scaler_red.inverse_transform(red_pred_scaled.reshape(1, -1))[0]

                # 处理红号:四舍五入到整数,去重,确保在1-33之间,排序
                red_pred = np.round(red_pred).astype(int)
                red_pred = np.clip(red_pred, 1, 33)  # 限制范围
                red_pred = np.unique(red_pred)  # 去重

                # 如果不足6个,补充随机数(确保不重复)
                while len(red_pred) < 6:
                    new_num = random.randint(1, 33)
                    if new_num not in red_pred:
                        red_pred = np.append(red_pred, new_num)

                # 取前6个并排序
                red_pred = np.sort(red_pred[:6])

                # 预测蓝号
                blue_input = latest_blue_scaled.reshape(1, look_back, 1)
                blue_pred_scaled = blue_model.predict(blue_input, verbose=0)[0][0]
                blue_pred = self.scaler_blue.inverse_transform(np.array([blue_pred_scaled]).reshape(-1, 1))[0][0]
                blue_pred = int(np.round(blue_pred))
                blue_pred = np.clip(blue_pred, 1, 16)  # 限制范围

                # 格式化输出
                red_str = " ".join(f"{num:02d}" for num in red_pred)
                blue_str = f"{blue_pred:02d}"

                predictions.append((red_str, blue_str))
        except Exception as e:
            # 错误信息用print输出
            print(f"号码预测失败:{str(e)}")

        return predictions

    def analyze_and_predict(self):
        """重新分析并预测"""
        self.result_text.clear()
        self.result_text.append("🔄 正在进行数据分析和模型训练...")
        QApplication.processEvents()  # 刷新界面

        # 训练模型
        red_model, blue_model = self.train_models()
        if not red_model or not blue_model:
            self.result_text.append("❌ 模型训练失败,请检查数据!")
            return

        self.result_text.append("✅ 模型训练完成,正在预测号码...")
        QApplication.processEvents()

        # 预测5组号码
        predictions = self.predict_numbers(red_model, blue_model, 5)

        # 显示结果
        self.result_text.clear()
        self.result_text.append("=" * 50)
        self.result_text.append("预测号码组合(仅供娱乐)")
        self.result_text.append("=" * 50)
        if predictions:
            for i, (red, blue) in enumerate(predictions, 1):
                self.result_text.append(f"第{i}组:红号 {red} | 蓝号 {blue}")
        else:
            self.result_text.append("❌ 未能生成预测号码,请重试!")
            print("预测号码生成失败,可能是数据不足或模型训练异常")

        self.result_text.append("=" * 50)
        self.result_text.append("提示:彩票号码为随机事件,预测结果无实际参考价值!")

if __name__ == "__main__":
    app = QApplication(sys.argv)
    window = LotteryAnalysisWindow()
    window.show()
    sys.exit(app.exec())
下面是程序统计出的号码,仅供娱乐!
python
红号 05 10 15 20 24 29 | 蓝号 09点赞和关注我的博客!
超越自己是我的每一步,我的进步就是你的进步!