学AI大模型也有一段时间了,之前学大模型一直都是东一榔头,西一棒槌,这学一点那学一点,网上很多名义上说是系统化大模型教程的,到后面也是零零散散,拼拼凑凑的教程,我花了几个月的时间才构建起对大模型的整体认知,但不够细致......
所以,为了让大家避免我之前踩过的坑,今天特地梳理了一下大致的学习框架,让大家有目的有方向的学习,这样可以节省很多的时间。
首先,大家应该明白一件事,大模型技术是人工智能技术的一个分支,是目前主流的一个研究方向,但并不是唯一的方向。
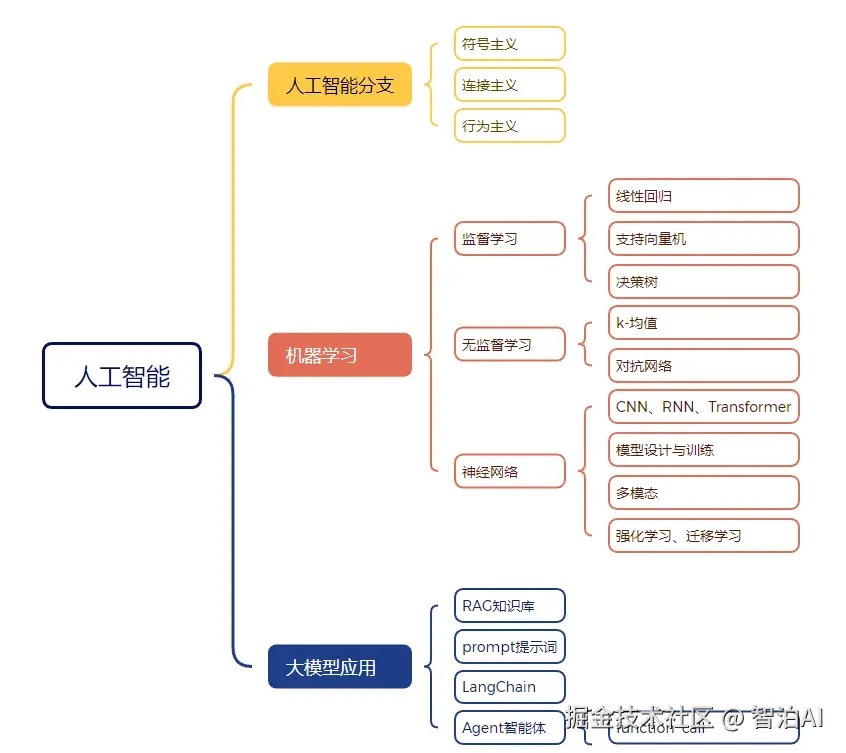
以上都是可以深入学习的方向。
下面来给大家讲讲AI大模型入门手册的具体内容,主要分为六个部分:
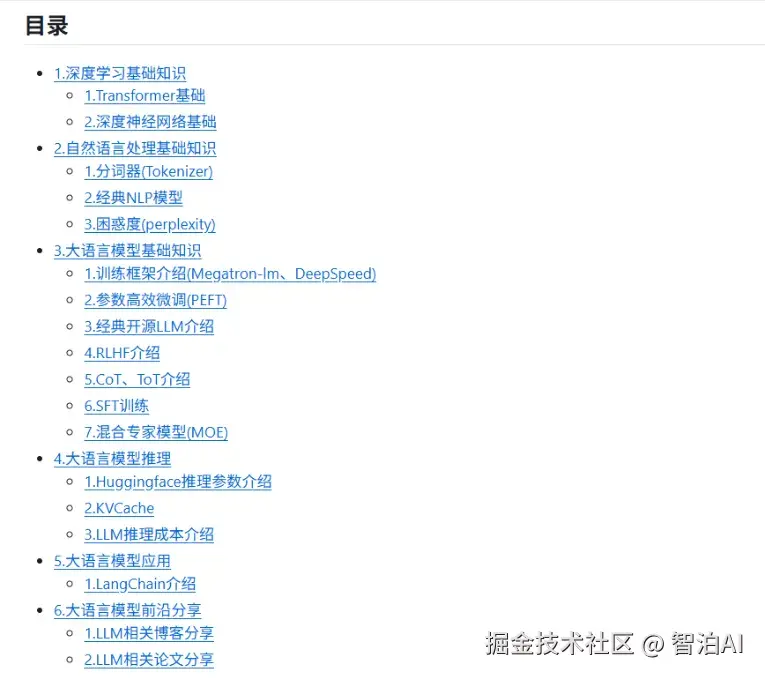
第一章:深度学习基础知识 (难度⭐⭐)
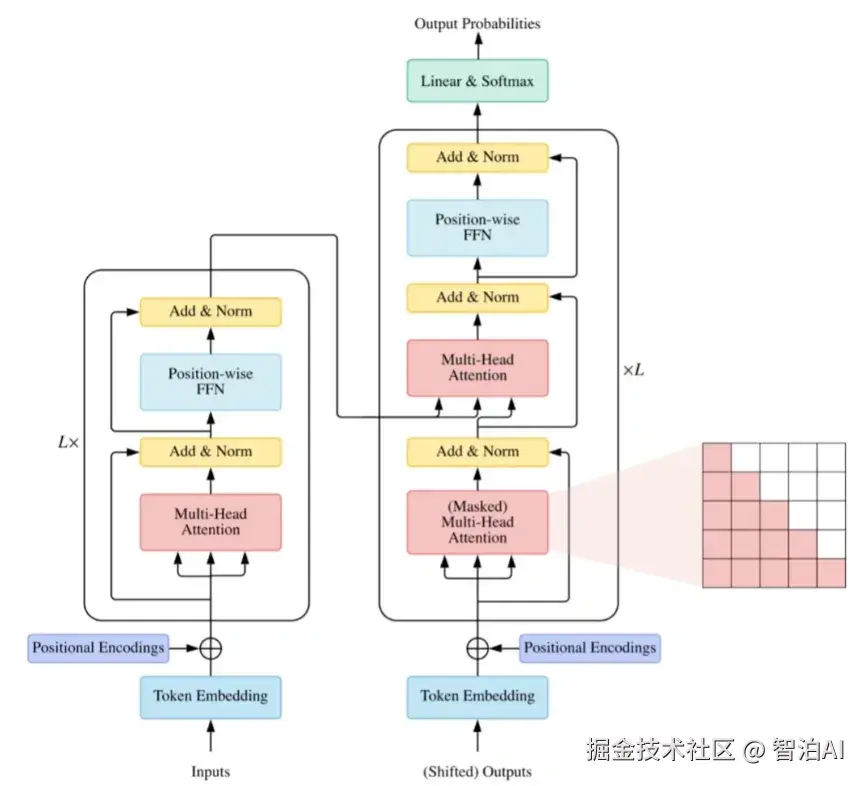
Transformer作为当前大模型的核心基础框架,主流大模型均围绕Transformer架构进行衍生改进。此外,还需掌握神经网络的基础知识,例如Batch Normalization(BN)与Layer Normalization(LN)的差异、不同优化器的性能对比等。相较于初级的深度学习入门内容,这部分知识的复杂度有所提升。
第二章:自然语言处理基础知识 (难度⭐⭐⭐)
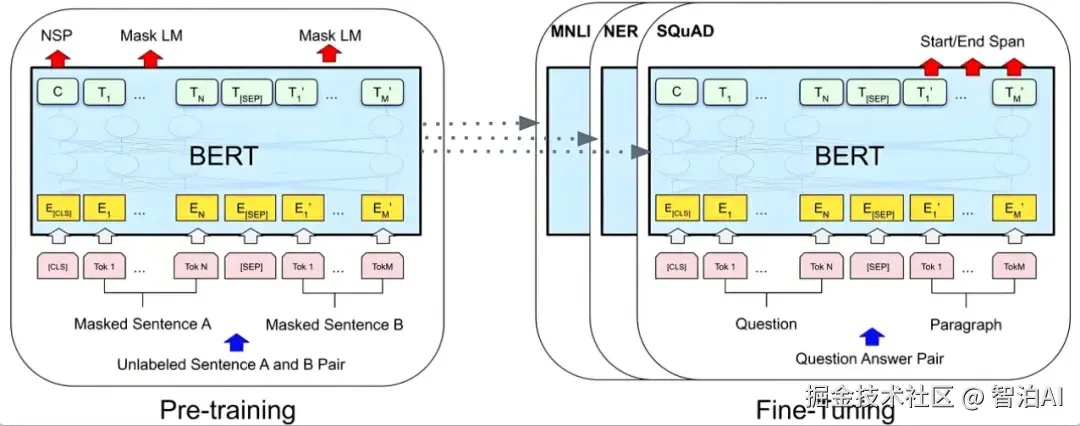
掌握NLP的基础知识是学习LLM的前提条件,例如需要熟悉分词器(Tokenizer)的工作原理。此外,当前主流的NLP模型如Bert(Bidirectional Encoder Representations from Transformers)具有里程碑意义------该模型的问世验证了大模型通过预训练(Pre-training)与微调(Fine-tuning)相结合的范式可行性。最后,在自然语言处理任务中,困惑度(Perplexity)作为核心评估指标,其重要性不可忽视。
第三章:大语言模型基础知识 (难度⭐⭐⭐⭐)
这部分的内容包括大模型训练框架,比如Megatron-LM, DeepSpeed, 高效参数微调的方法,当前主流的开源大模型,RLHF流程的介绍,COT和TOT的介绍,监督微调的训练,最后是混合专家模型MOE。
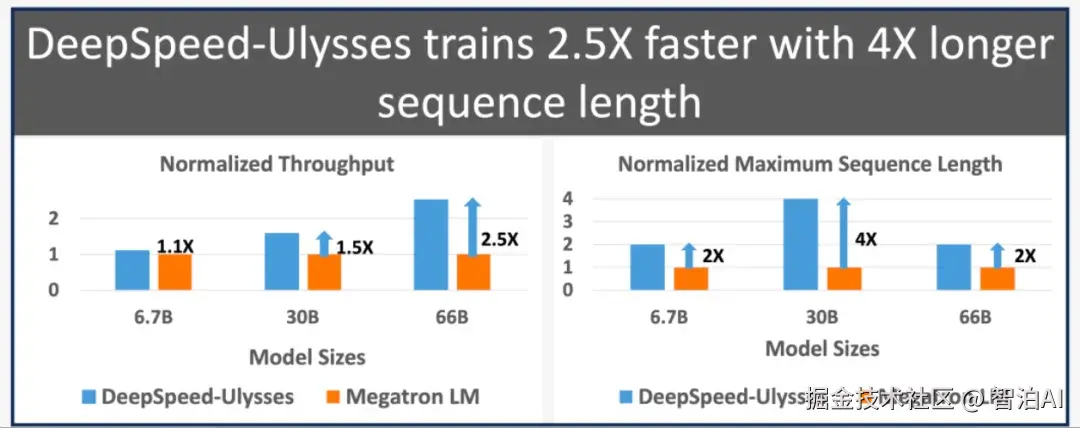
第四章:大语言模型推理 (难度⭐⭐⭐)
在完成模型训练后,大模型的输出结果即构成推理流程。本节将重点说明HuggingFace的推理参数配置、推理过程中KVCache机制的作用,以及LLM推理所需付出的成本代价。实际应用中的核心考量因素始终在于推理速度与资源消耗的平衡。
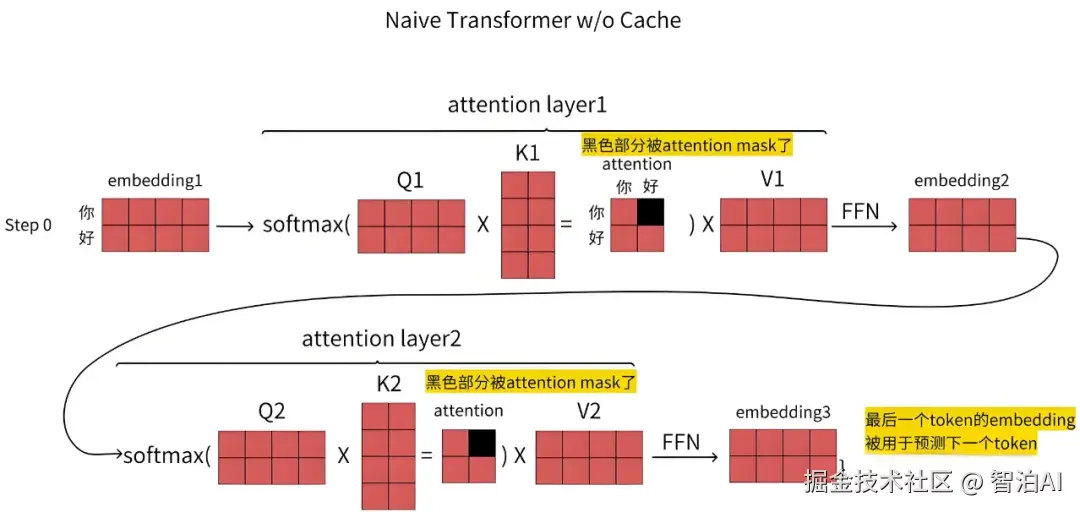
第五章:大语言模型应用(难度 * ⭐⭐⭐)*
不同大模型的数据格式,API接口等都不一样,可以通过Langchain来统一管理这些,支持大模型的统一化调用,支持便捷的prompt模版设置,还有智能体的高阶应用,建议结合相关视频教程来学习langchain
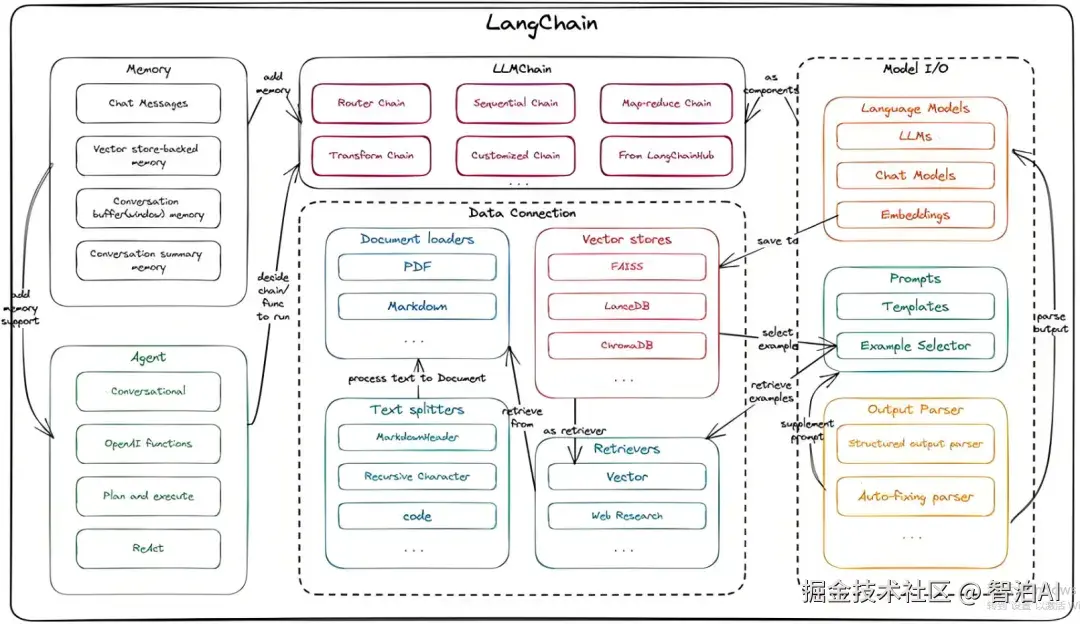
第六章:大语言模型前沿(难度⭐⭐⭐)
本部分聚焦于LLM(大语言模型)相关博客的推荐。由于大模型技术迭代迅速,建议通过阅读专业博客主动跟进学习,同时关注顶会(如NeurIPS、ACL等)的前沿论文。当前可参考的资料较为有限,后续可逐步补充完善。
更多AI大模型学习视频及资源,都在智泊AI。