文章目录
- 前言
- [一. 了解硬件](#一. 了解硬件)
-
- [1.1 磁盘](#1.1 磁盘)
- [1.2 磁盘的物理结构](#1.2 磁盘的物理结构)
- [1.3 磁盘的存储结构](#1.3 磁盘的存储结构)
- [1.4 磁盘的逻辑结构](#1.4 磁盘的逻辑结构)
- [1.5 CHS地址和LBA地址](#1.5 CHS地址和LBA地址)
- [二. 引入文件系统](#二. 引入文件系统)
-
- [2.1 块](#2.1 块)
- [2.2 分区](#2.2 分区)
- [2.3 inode](#2.3 inode)
- [三. ext2文件系统](#三. ext2文件系统)
-
- [3.1 宏观认识](#3.1 宏观认识)
- [3.2 Block Group](#3.2 Block Group)
- [3.3 块组内部构成](#3.3 块组内部构成)
-
- [超级块(Super Block)](#超级块(Super Block))
- [GDT(Group Descriptor Table)](#GDT(Group Descriptor Table))
- [块位图(Block Bitmap)](#块位图(Block Bitmap))
- [inode位图(Inode Bitmap)](#inode位图(Inode Bitmap))
- i节点表 (Inode Table)
- [Data Block](#Data Block)
- [3.4 inode和datablock映射(弱化)](#3.4 inode和datablock映射(弱化))
- [3.5 目录与文件名](#3.5 目录与文件名)
- [3.6 路径解析](#3.6 路径解析)
- [3.7 路径缓存](#3.7 路径缓存)
- [3.8 挂载分区](#3.8 挂载分区)
- [四. 软硬链接](#四. 软硬链接)
-
- [4.1 硬链接](#4.1 硬链接)
- [4.2 软链接](#4.2 软链接)
- [4.3 软硬链接的对比](#4.3 软硬链接的对比)
- [4.4 软硬链接的用途](#4.4 软硬链接的用途)
- 最后
前言
在上一篇文章中,我们详细介绍了基础IO的内容,内容还是挺多的,希望大家可以多去练习熟悉一下,那么本篇文章将带大家详细讲解文件系统的内容,接下来一起看看吧!
一. 了解硬件
1.1 磁盘
磁盘是计算机中用于长期存储数据的主要设备之一,即使在断电后,数据仍然保留。它类似于一个文件柜,可以保存操作系统、程序、文档、图片、视频等各种信息。
磁盘主要分为两大类:
| 类型 | 全称 | 特点 | 举例 |
|---|---|---|---|
| HDD | 机械硬盘 | 容量大、价格低、速度较慢、有噪音 | 传统电脑硬盘 |
| SSD | 固态硬盘 | 速度快、抗震、无噪音、价格较高 | 现代笔记本硬盘 |
简单来说:
- 磁盘 = 数据的"仓库"
- 没有磁盘,计算机就无法保存任何信息,包括操作系统本身。
如果你把CPU比作"大脑",内存比作"临时工作台",那么磁盘就是"文件柜",所有重要的资料都存放在这里。
1.2 磁盘的物理结构
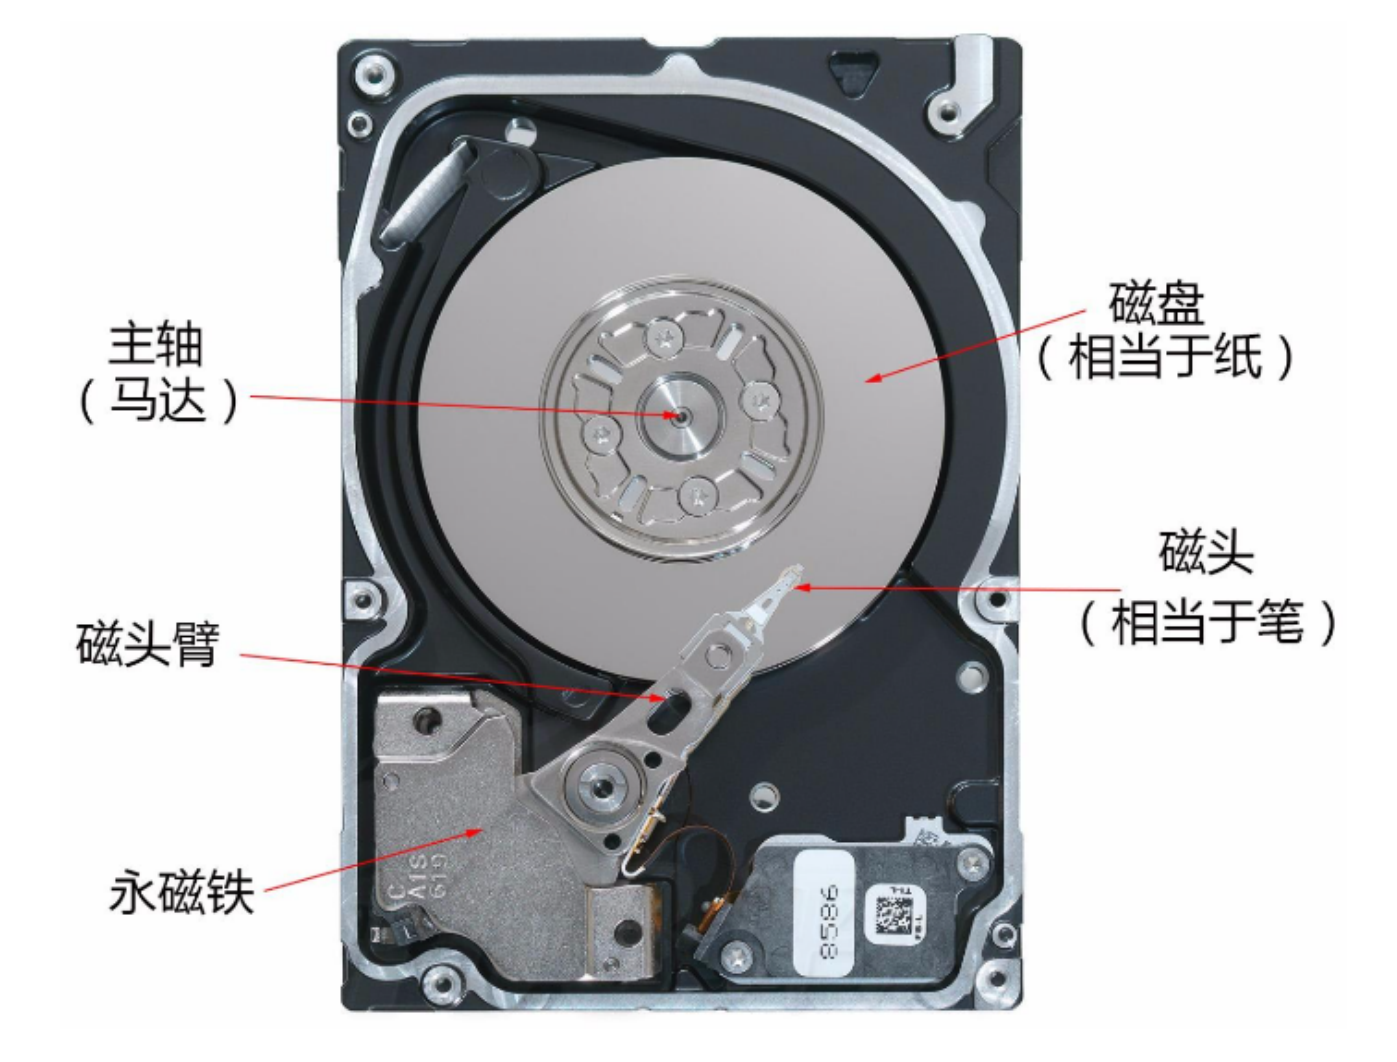
| 图中标注 | 对应部件 | 作用说明 |
|---|---|---|
| 磁盘("相当于纸") | 盘片(platter) | 表面涂有磁性材料,数据就"写"在这些同心圆的磁道上。一张盘片两面都能存数据,整个硬盘里通常有多张盘片叠在一起。 |
| 主轴("马达") | 主轴电机(spindle motor) | 带动所有盘片以恒定高速(5400/7200/10000 RPM)旋转,让磁头能在极短时间内扫过任意磁道。 |
| 磁头("相当于笔") | 磁头(read/write head) | 悬浮在盘片表面约几纳米高处,利用电磁感应把 0/1 信号"写"到磁性涂层上,或把磁性变化"读"回来。 |
| 磁头臂 | 磁头臂(actuator arm) | 像唱机的唱臂一样,在盘片表面来回摆动,把磁头精准定位到目标磁道。 |
| 永磁铁 | 音圈电机磁体(VCM magnet) | 与磁头臂上的线圈组成"音圈电机",通电后产生力矩,快速、精确地驱动磁头臂整体转动。 |
1.3 磁盘的存储结构
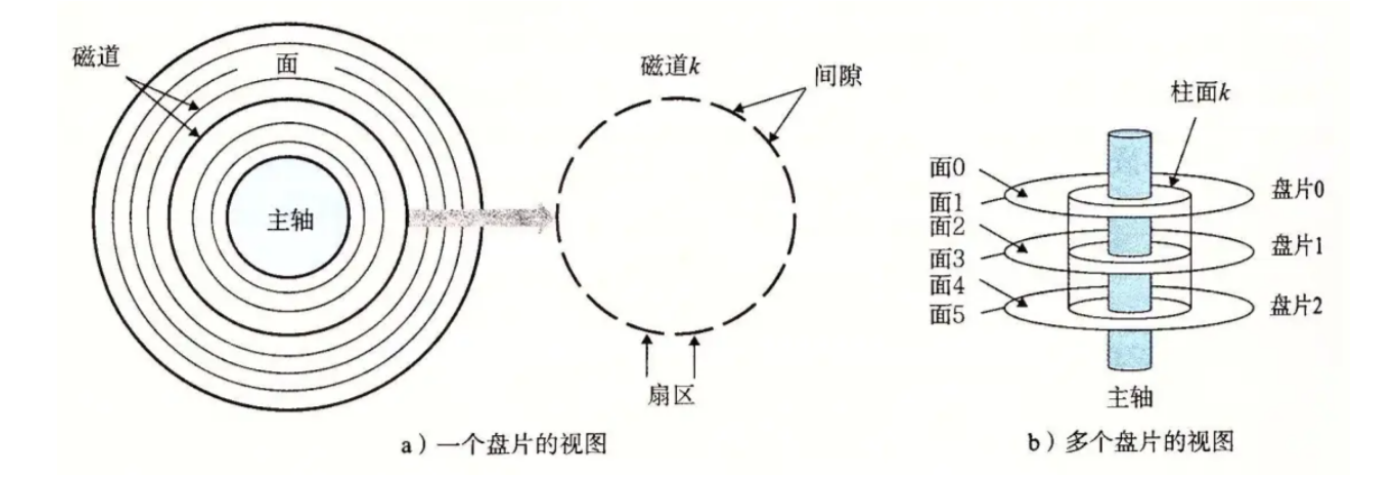
扇区:是磁盘存储数据的基本单位,512字节,块设备。
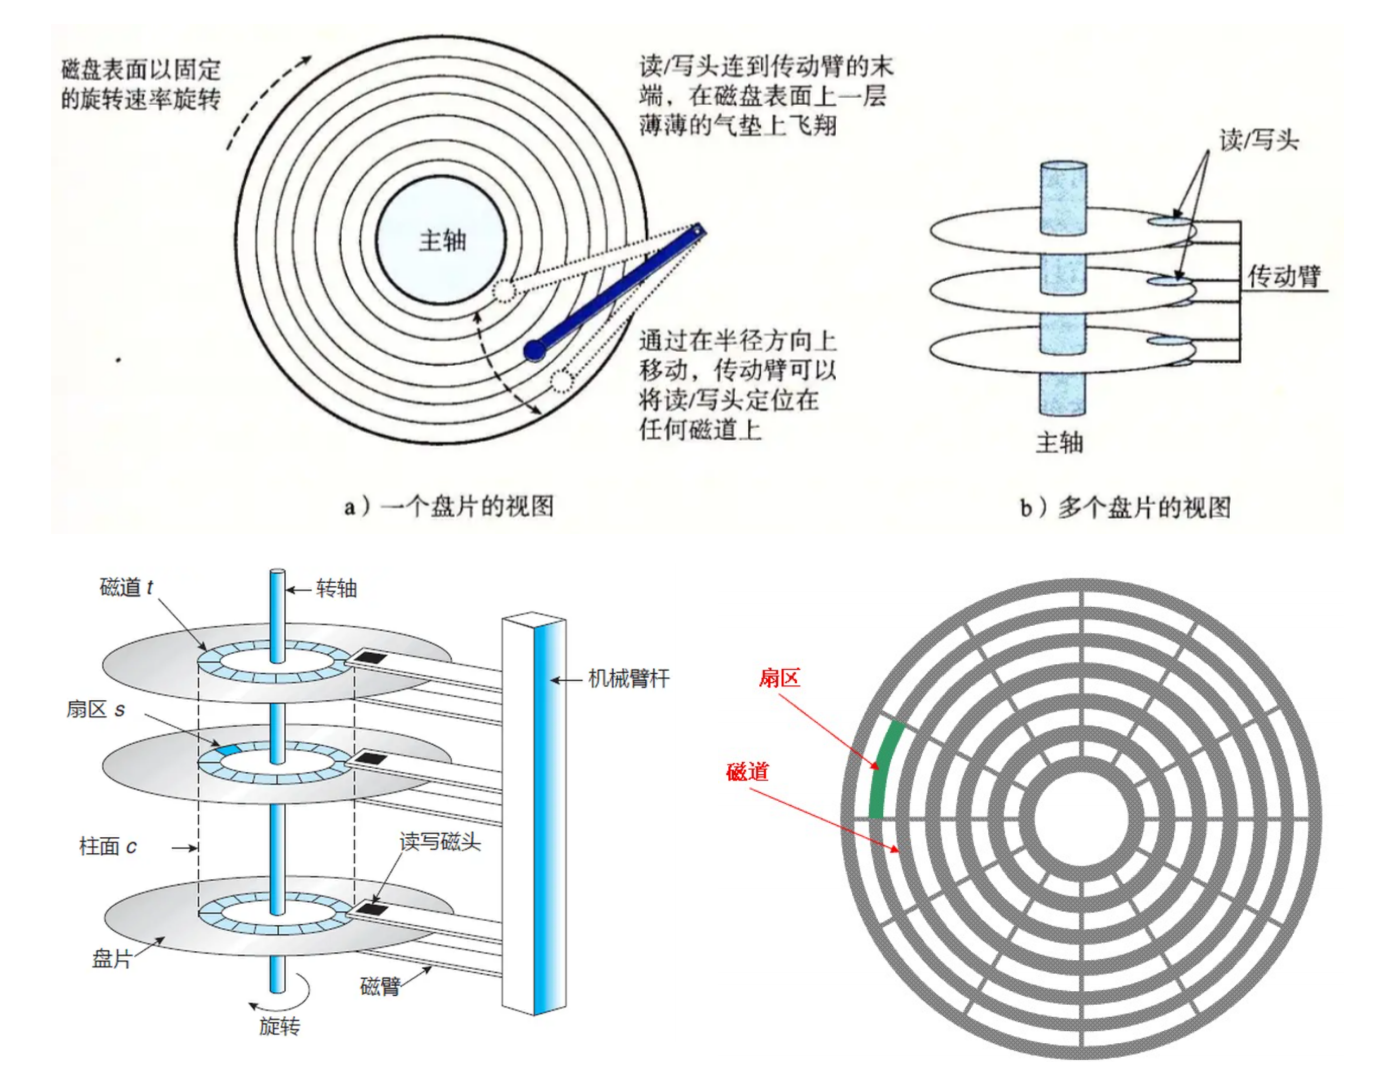
如何定位一个扇区呢?
- 可以先定位磁头(header)
- 确定磁头要访问哪一个柱面(磁道)(cylinder)
- 定位一个扇区(sector)
- CHS地址定位
磁盘容量怎么计算?
- 扇区是从磁盘读出和写入信息的最小单位,通常大小为 512 字节。
- 磁头(head)数:每个盘片一般有上下两面,分别对应1个磁头,共2个磁头
- 磁道(track)数:磁道是从盘片外圈往内圈编号0磁道,1磁道...,靠近主轴的同心圆用于停靠磁头,不存储数据
- 柱面(cylinder)数:磁道构成柱面,数量上等同于磁道个数
- 扇区(sector)数:每个磁道都被切分成很多扇形区域,每道的扇区数量相同
- 圆盘(platter)数:就是盘片的数量
磁盘容量 = 磁头数 × 磁道(柱面)数 × 每道扇区数 × 每扇区字节数
柱面(cylinder),磁头(head),扇区(sector),显然可以定位数据了,这就是数据定位(寻址)方式之一,CHS寻址方式。
1.4 磁盘的逻辑结构
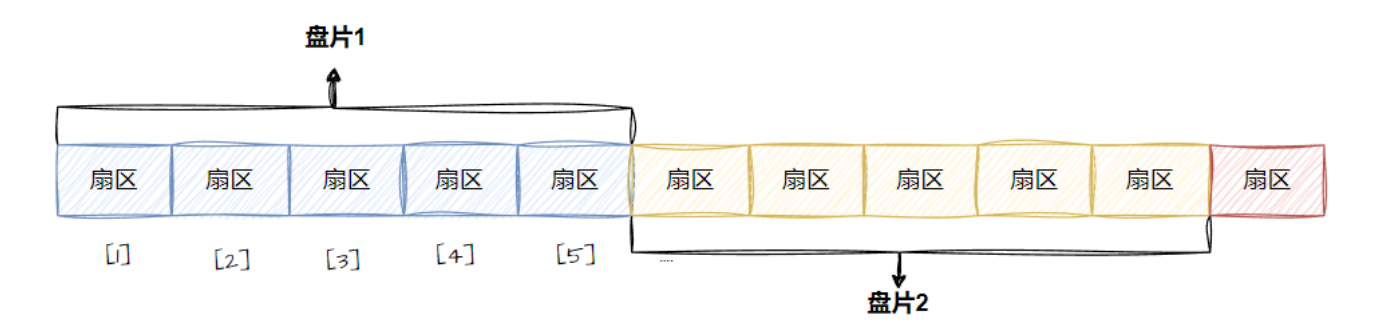
磁盘本质上虽然是硬质的,但是逻辑上我们可以把磁盘想象成为卷在一起的磁带,那么磁盘的逻辑存储结构我们也可以类似于:
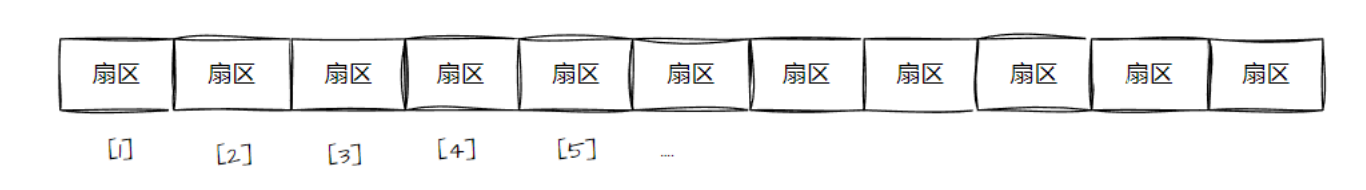
这样每一个扇区,就有了一个线性地址(其实就是数组下标),这种地址叫做LBA
柱面是一个逻辑上的概念,其实就是每一面上,相同半径的磁道逻辑上构成柱面 。
所以,磁盘物理上分了很多面,但是在我们看来,逻辑上,磁盘整体是由"柱面"卷起来的。
磁道 :
某一盘面的某一个磁道展开:
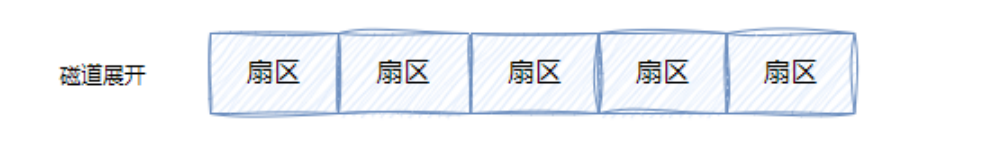
即:一维数组
柱面 :
整个磁盘所有盘面的同一个磁道,即柱面展开:
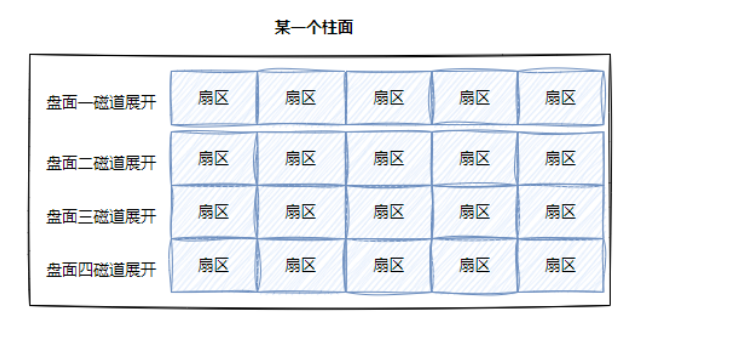
- 柱面上的每个磁道,扇区个数是一样的
- 这就是二维数组
整盘 :
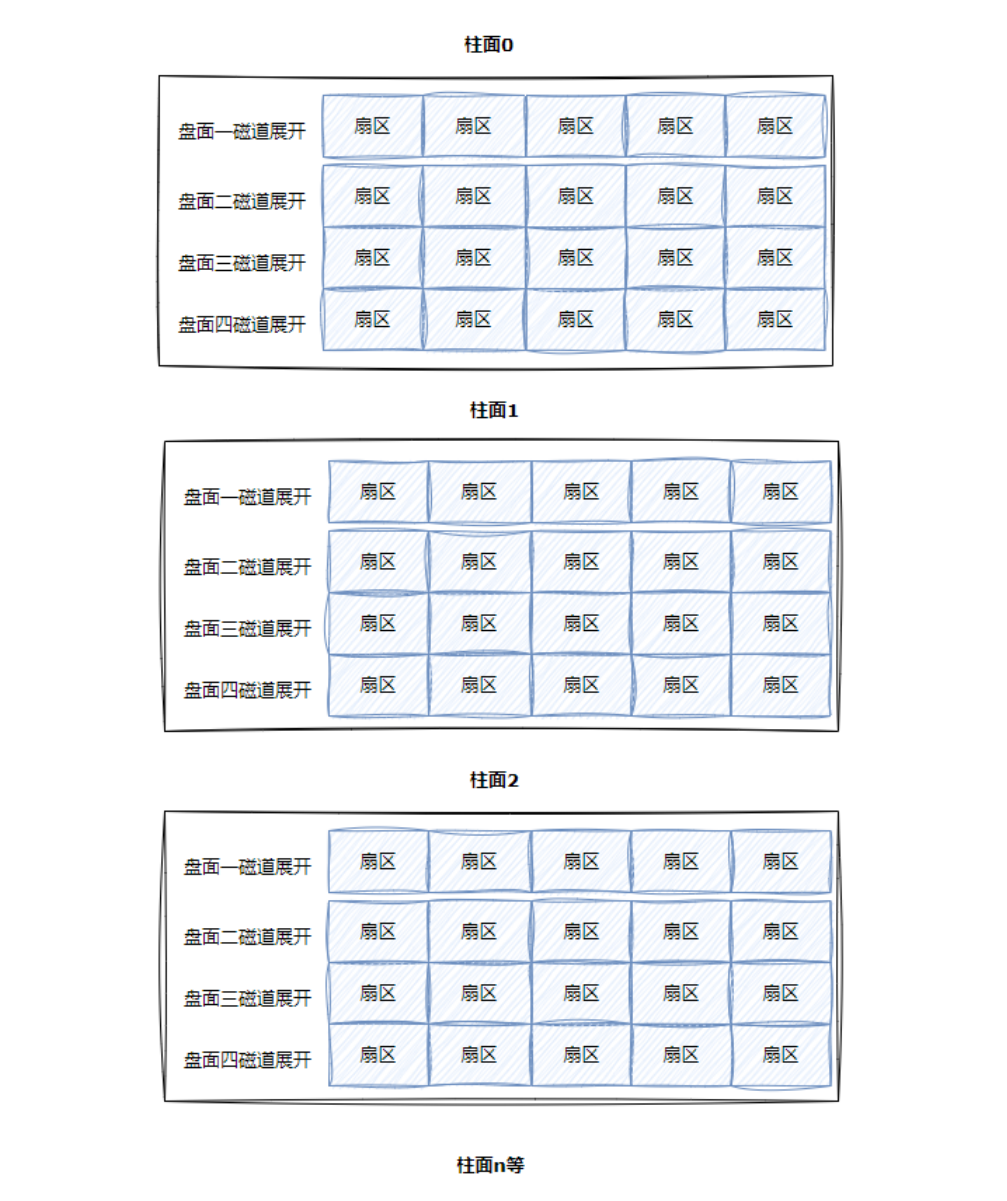
整个磁盘不就是多张二维的扇区数组表(三维数组?)
所有,寻址一个扇区:先找到哪一个柱面(Cylinder) ,在确定柱面内哪一个磁道(其实就是磁头位置,Head),在确定扇区(Sector),所以就有了 CHS 。
我们之前学过C/C++的数组,在我们看来,其实全部都是一维数组:
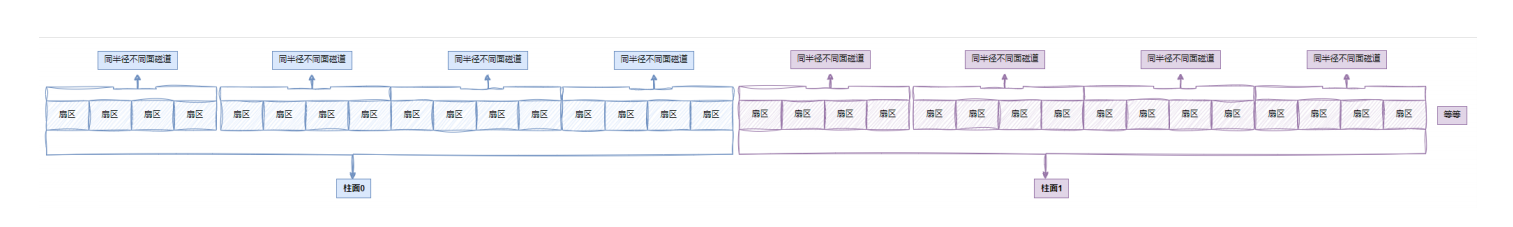
所以,每一个扇区都有一个下标,我们叫做LBA(Logical Block Address)地址,其实就是线性地址,那么如何实现LBA地址和CHS地址的相互转化呢?
这个过程谁做啊??磁盘自己来做!固件(硬件电路,伺服系统)
1.5 CHS地址和LBA地址
CHS转成LBA:
- 磁头数 * 每磁道扇区数 = 单个柱面的扇区总数
LBA = 柱面号C * 单个柱面的扇区总数 + 磁头号H * 每磁道扇区数 + 扇区号S - 1- 即:LBA = 柱面号C * (磁头数 * 每磁道扇区数) + 磁头号H * 每磁道扇区数 + 扇区号S - 1
- 扇区号通常是从1开始的,而在LBA中,地址是从0开始的
- 柱面和磁道都是从0开始编号的
- 总柱面,磁道个数,扇区总数等信息,在磁盘内部会自动维护,上层开机的时候,会获取到这些参数。
LBA转成CHS:
- 柱面号C = LBA // (磁头数 * 每磁道扇区数)【就是单个柱面的扇区总数】
磁头号H = (LBA % (磁头数 * 每磁道扇区数)) // 每磁道扇区数- 扇区号S = (LBA % 每磁道扇区数) + 1
- "//": 表示除取整
所以:从此往后,在磁盘使用者看来,根本就不关心CHS地址,而是直接使用LBA地址,磁盘内部自己转换。
从现在开始,磁盘就是一个 元素为扇区 的一维数组,数组的下标就是每一个扇区的LBA地址。OS使用磁盘,就可以用一个数字访问磁盘扇区了。
二. 引入文件系统
2.1 块
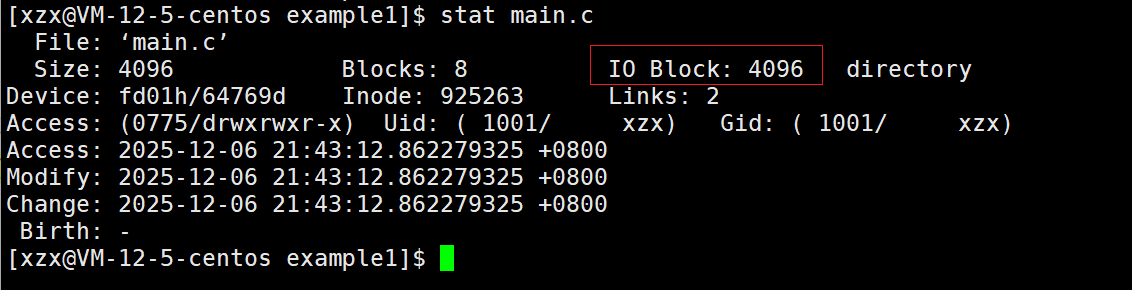
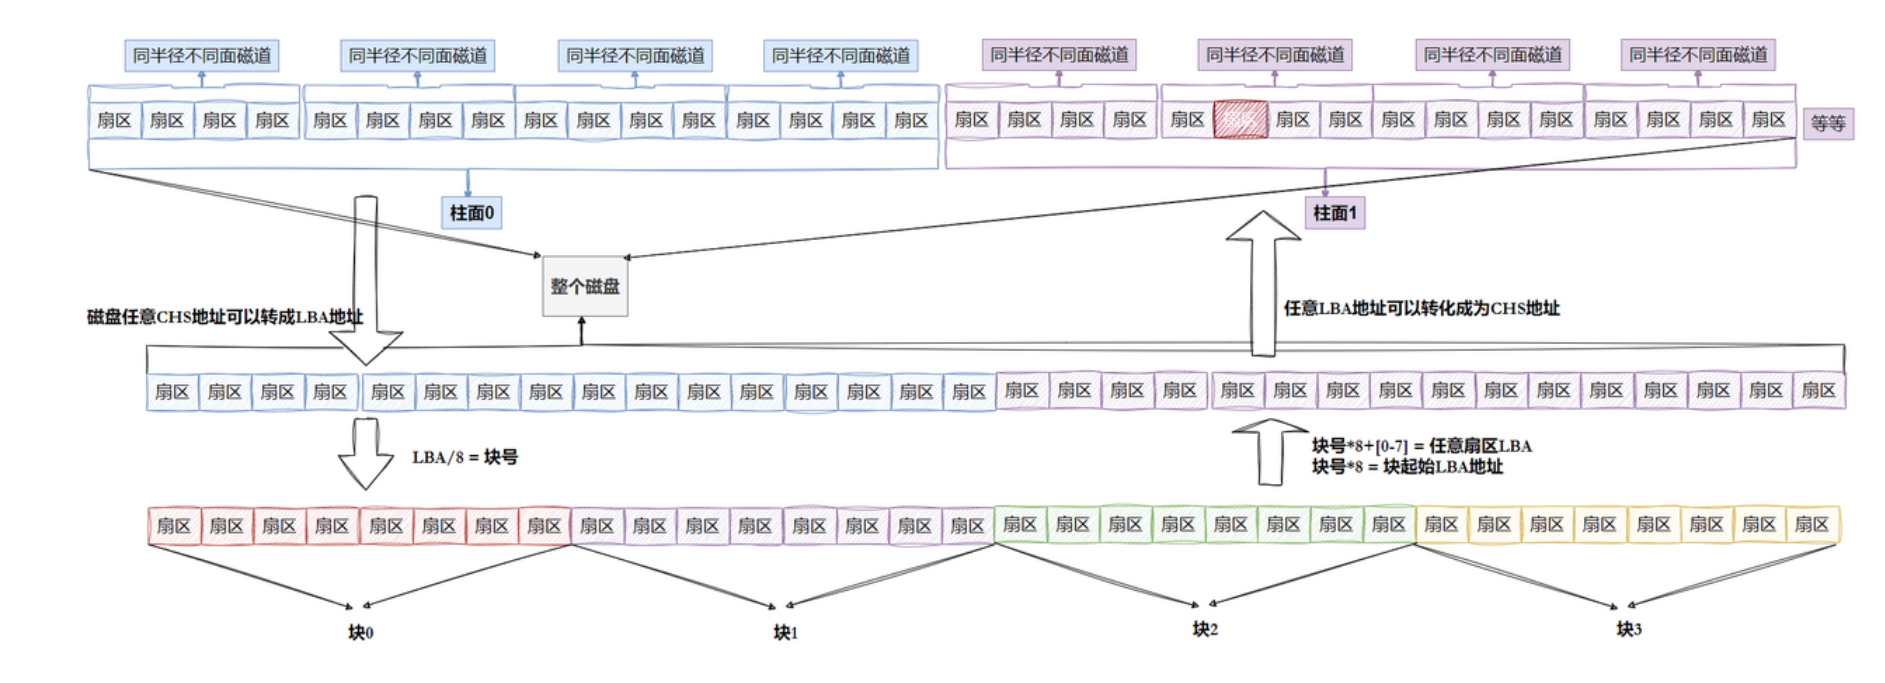
其实硬盘是典型的"块"设备,操作系统读取硬盘数据的时候,其实是不会一个个扇区地读取,这样效率太低,而是一次性连续读取多个扇区,即一次性读取一个"块"(block)。
硬盘的每个分区是被划分为一个个的"块"。一个"块"的大小是由格式化的时候确定的,并且不可
以更改,最常见的是4KB,即连续八个扇区组成一个 "块"。"块"是文件存取的最小单位。
- 磁盘就是一个三维数组,我们把它看待成为一个"一维数组",数组下标就是LBA,每个元素都是扇区
- 每个扇区都有LBA,那么8个扇区一个块,每一个块的地址我们也能算出来。
- 知道LBA:
块号 = LBA / 8- 知道块号:
LAB= 块号 * 8 + n. (n是块内第几个扇区)
2.2 分区
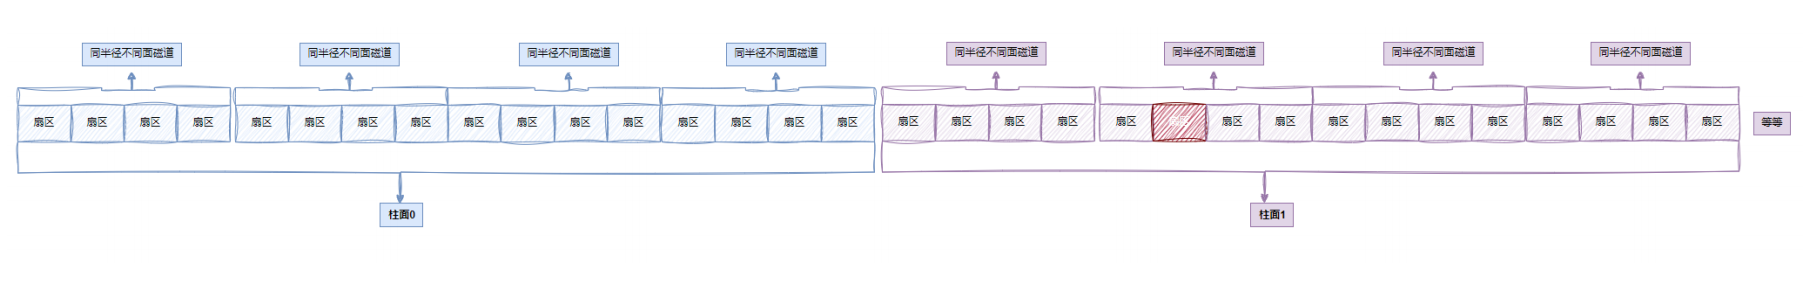
其实磁盘是可以被分成多个分区(partition)的,以Windows观点来看,你可能会有一块磁盘并且将它分区成C,D,E盘。那个C,D,E就是分区。分区从实质上说就是对硬盘的一种格式化。但是Linux的设备都是以文件形式存在,那是怎么分区的呢?
柱面是分区的最小单位,我们可以利用参考柱面号码的方式来进行分区,其本质就是设置每个区的起始柱面和结束柱面号码。 此时我们可以将硬盘上的柱面(分区)进行平铺,将其想象成一个大的平面,如下图所示:
2.3 inode
之前我们说过 文件 = 数据 + 属性 ,我们使用 ls -l 的时候看到的除了看到文件名,还能看到文件元数据(属性)。
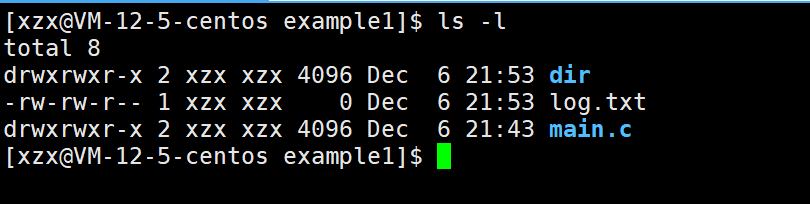
每行包含7列:模式、硬链接数、文件所有者、组、大小、最后修改时间、文件名
其实这个信息除了通过这种方式来读取,还有一个stat命令能够看到更多信息
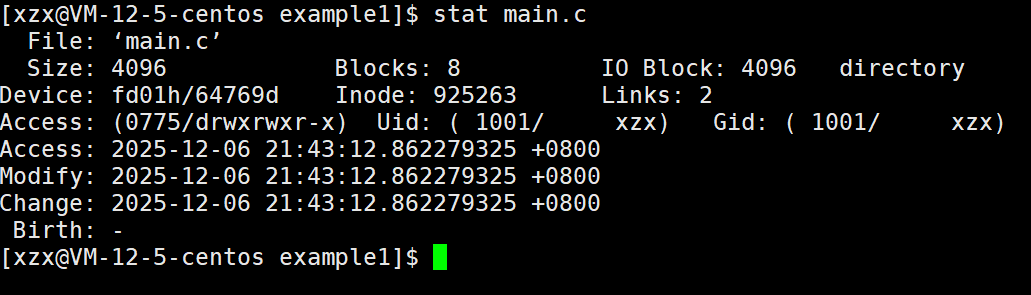
文件数据都储存在"块"中,那么很显然,我们还必须找到一个地方储存文件的元信息(属性信息),比如文件的创建者、文件的创建日期、文件的大小等等。这种储存文件元信息的区域就叫做inode,中文译名为"索引节点"。
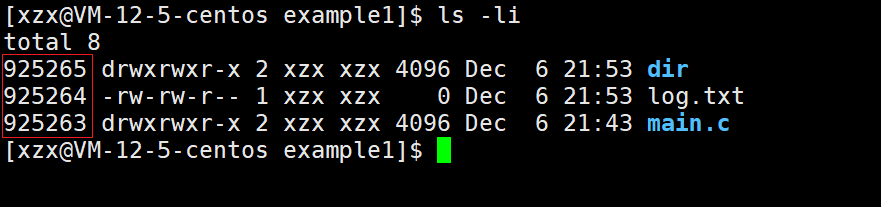
每一个文件都有对应的inode,里面包含了与该文件有关的一些信息。为了能解释清楚inode,我们需要是深入了解一下文件系统。
注意:
- Linux下文件的存储是属性和内容分离存储的
- Linux下,保存文件属性的集合叫做
inode,一个文件,一个inode,inode内有一个唯一的标识符,叫做inode号
所以一个文件的属性inode长什么样子呢?
c
/*
* Structure of an inode on the disk
*/
struct ext2_inode {
	__le16 i_mode; /* File mode */
	__le16 i_uid; /* Low 16 bits of Owner Uid */
	__le32 i_size; /* Size in bytes */
	__le32 i_atime; /* Access time */
	__le32 i_ctime; /* Creation time */
	__le32 i_mtime; /* Modification time */
	__le32 i_dtime; /* Deletion Time */
	__le16 i_gid; /* Low 16 bits of Group Id */
	__le16 i_links_count; /* Links count */
	__le32 i_blocks; /* Blocks count */
	__le32 i_flags; /* File flags */
	union {
		struct {
			__le32 l_i_reserved1;
		} linux1;
		struct {
			__le32 h_i_translator;
		} hurd1;
		struct {
			__le32 m_i_reserved1;
		} masix1;
	} osd1; /* OS dependent 1 */
	__le32 i_block[EXT2_N_BLOCKS];/* Pointers to blocks */
	__le32 i_generation; /* File version (for NFS) */
	__le32 i_file_acl; /* File ACL */
	__le32 i_dir_acl; /* Directory ACL */
	__le32 i_faddr; /* Fragment address */
	union {
		struct {
			__u8 l_i_frag; /* Fragment number */
			__u8 l_i_fsize; /* Fragment size */
			__u16 i_pad1;
			__le16 l_i_uid_high; /* these 2 fields */
			__le16 l_i_gid_high; /* were reserved2[0] */
			__u32 l_i_reserved2;
		} linux2;
		struct {
			__u8 h_i_frag; /* Fragment number */
			__u8 h_i_fsize; /* Fragment size */
			__le16 h_i_mode_high;
			__le16 h_i_uid_high;
			__le16 h_i_gid_high;
			__le32 h_i_author;
		} hurd2;
		struct {
			__u8 m_i_frag; /* Fragment number */
			__u8 m_i_fsize; /* Fragment size */
			__u16 m_pad1;
			__u32 m_i_reserved2[2];
		} masix2;
	} osd2; /* OS dependent 2 */
};
/*
* Constants relative to the data blocks
*/
#define EXT2_NDIR_BLOCKS 12
#define EXT2_IND_BLOCK EXT2_NDIR_BLOCKS
#define EXT2_DIND_BLOCK (EXT2_IND_BLOCK + 1)
#define EXT2_TIND_BLOCK (EXT2_DIND_BLOCK + 1)
#define EXT2_N_BLOCKS (EXT2_TIND_BLOCK + 1)
注意:
- 文件名属性并未纳入到
inode数据结构内部inode的大小一般是128字节或者256,我们后面统一128字节- 任何文件的内容大小可以不同,但是属性大小一定是相同的
三. ext2文件系统
3.1 宏观认识
现在我们来认识下文件系统了。我们想要在硬盘上储文件,必须先把硬盘格式化为某种格式的文件系统,才能存储文件 。文件系统的目的就是组织和管理硬盘中的文件。在Linux 系统中,最常见的是 ext2 系列的文件系统。其早期版本为 ext2,后来又发展出 ext3 和 ext4。ext3 和 ext4 虽然对 ext2 进行了增强,但是其核心设计并没有发生变化,我们仍是以较老的 ext2 作为演示对象。
ext2文件系统将整个分区划分成若干个同样大小的块组 (Block Group),如下图所示。只要能管理一个分区就能管理所有分区,也就能管理所有磁盘文件。
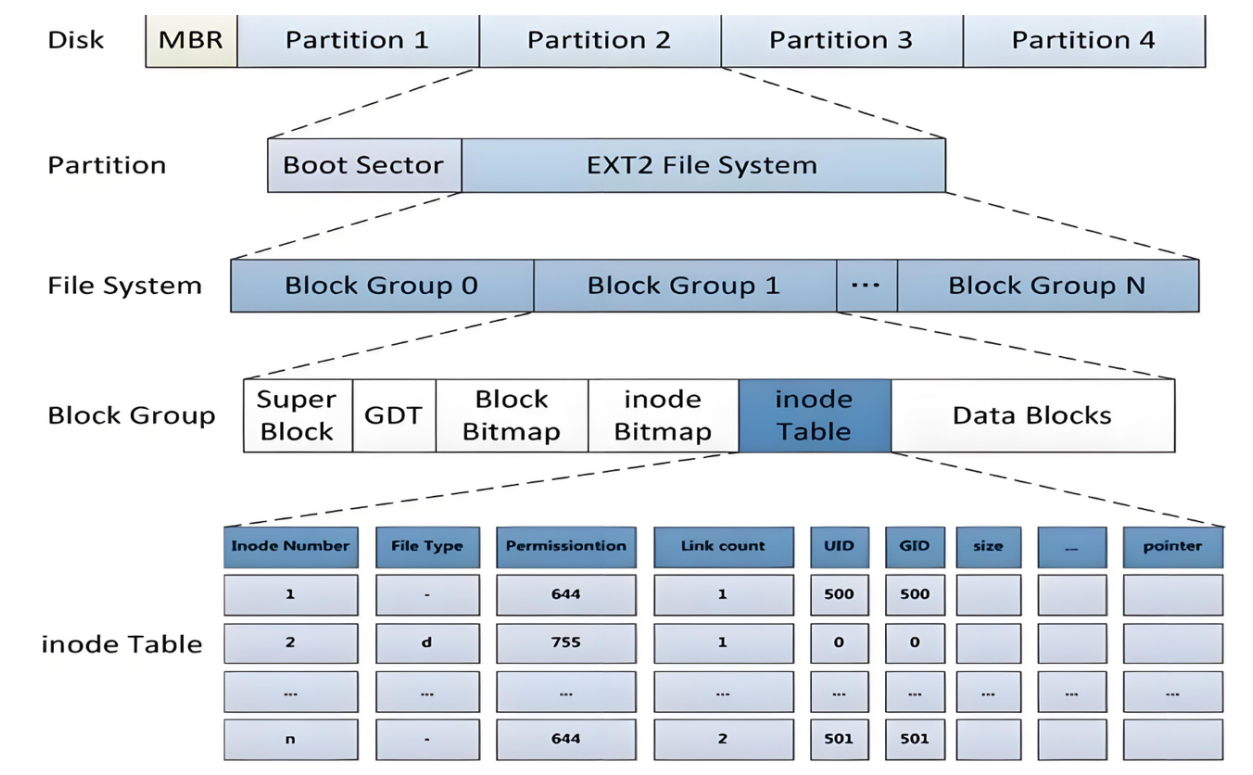
上图中启动块(Boot Block/Sector)的大小是确定的,为1KB,由PC标准规定,用来存储磁盘分区信息和启动信息,任何文件系统都不能修改启动块。启动块之后才是ext2文件系统的开始。
3.2 Block Group
ext2文件系统会根据分区的大小划分为数个Block Group。而每个Block Group都有着相同的结构组成。政府管理各区的例子。
3.3 块组内部构成
超级块(Super Block)
存放文件系统本身的结构信息,描述整个分区的文件系统信息。记录的信息主要有:bolck 和 inode的总量,未使用的block和inode的数量,一个block和inode的大小,最近一次挂载的时间,最近一次写入数据的时间,最近一次检验磁盘的时间等其他文件系统的相关信息。Super Block的信息被破坏,可以说整个文件系统结构就被破坏了。
超级块在每个块组的开头都有一份拷贝(第一个块组必须有,后面的块组可以没有)。 为了保证文件系统在磁盘部分扇区出现物理问题的情况下还能正常工作,就必须保证文件系统的super block信息在这种情况下也能正常访问。所以一个文件系统的super block会在多个block group中进行备份,这些super block区域的数据保持一致。
GDT(Group Descriptor Table)
块组描述符表,描述块组属性信息,整个分区分成多个块组就对应有多少个块组描述符。每个块组描述符存储一个块组 的描述信息,如在这个块组中从哪里开始是inode Table,从哪里开始是Data Blocks,空闲的inode和数据块还有多少个等等。块组描述符在每个块组的开头都有一份拷贝。
c
// 磁盘级blockgroup的数据结构
/*
* Structure of a blocks group descriptor
*/
struct ext2_group_desc
{
	__le32 bg_block_bitmap; /* Blocks bitmap block */
	__le32 bg_inode_bitmap; /* Inodes bitmap */
	__le32 bg_inode_table; /* Inodes table block*/
	__le16 bg_free_blocks_count; /* Free blocks count */
	__le16 bg_free_inodes_count; /* Free inodes count */
	__le16 bg_used_dirs_count; /* Directories count */
	__le16 bg_pad;
	__le32 bg_reserved[3];
};
块位图(Block Bitmap)
- Block Bitmap中记录着Data Block中哪个数据块已经被占用,哪个数据块没有被占用
inode位图(Inode Bitmap)
- 每个bit表示一个inode是否空闲可用。
i节点表 (Inode Table)
- 存放文件属性 如:文件大小,所有者,最近修改时间等
- 当前分组所有inode属性的集合
- inode编号以分区为单位,整体划分,不可跨分区
Data Block
数据区:存放文件内容,也就是一个一个的Block。根据不同的文件类型有以下几种情况:
- 对于普通文件,文件的数据存储在数据块中。
- 对于目录,该目录下的所有文件名和目录名存储在所在目录的数据块中,除了文件名外,
ls -l命令看到的其它信息保存在该文件的inode中。 - Block 号按照分区划分,不可跨分区
3.4 inode和datablock映射(弱化)
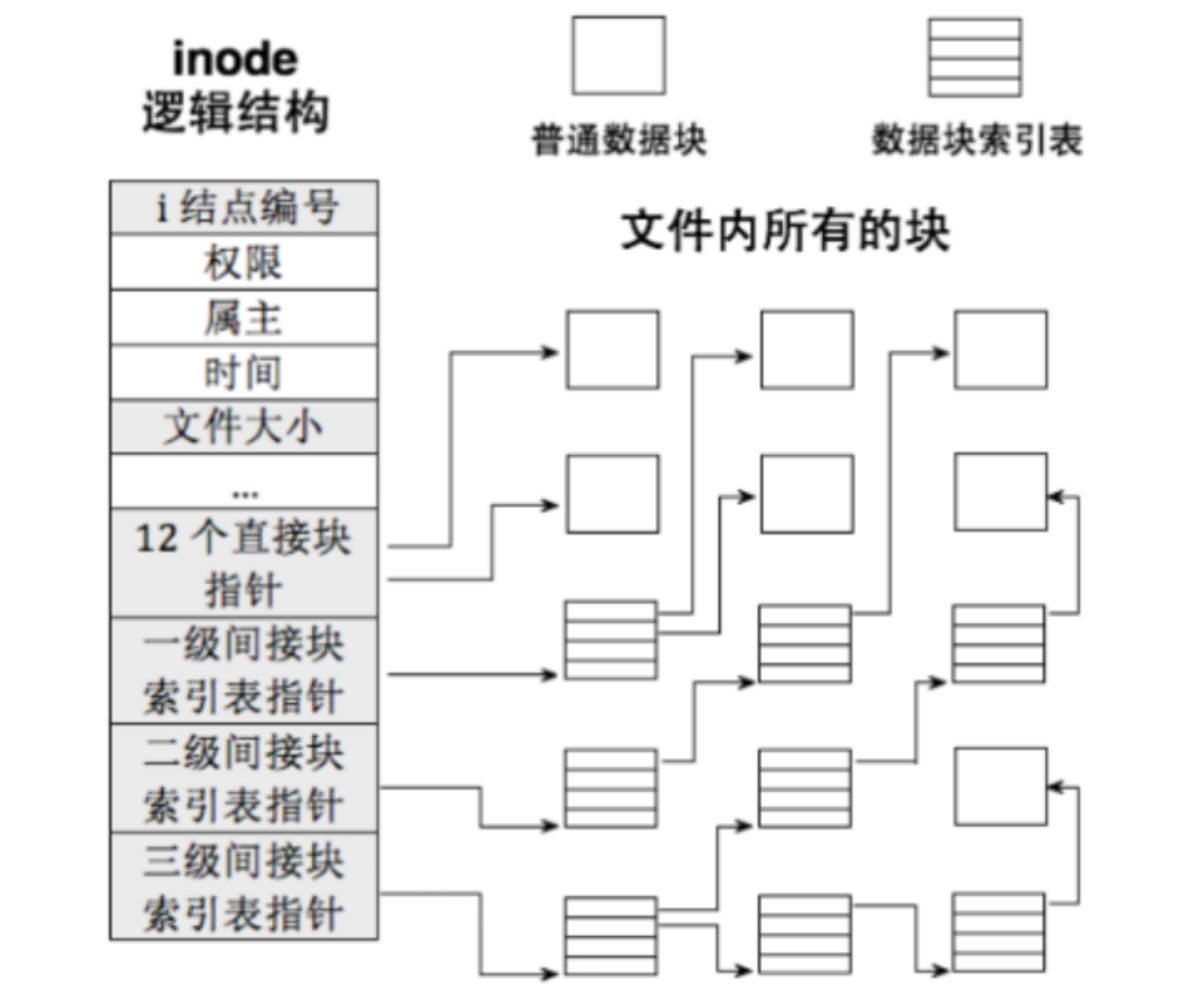
c
/*
* Structure of an inode on the disk
*/
struct ext2_inode {
	__le16 i_mode; /* File mode */
	__le16 i_uid; /* Low 16 bits of Owner Uid */
	__le32 i_size; /* Size in bytes */
	__le32 i_atime; /* Access time */
	__le32 i_ctime; /* Creation time */
	__le32 i_mtime; /* Modification time */
	__le32 i_dtime; /* Deletion Time */
	__le16 i_gid; /* Low 16 bits of Group Id */
	__le16 i_links_count; /* Links count */
	__le32 i_blocks; /* Blocks count */
	__le32 i_flags; /* File flags */
	union {
		struct {
			__le32 l_i_reserved1;
		} linux1;
		struct {
			__le32 h_i_translator;
		} hurd1;
		struct {
			__le32 m_i_reserved1;
		} masix1;
	} osd1; /* OS dependent 1 */
	__le32 i_block[EXT2_N_BLOCKS];/* Pointers to blocks */
	__le32 i_generation; /* File version (for NFS) */
	__le32 i_file_acl; /* File ACL */
	__le32 i_dir_acl; /* Directory ACL */
	__le32 i_faddr; /* Fragment address */
	union {
		struct {
			__u8 l_i_frag; /* Fragment number */
			__u8 l_i_fsize; /* Fragment size */
			__u16 i_pad1;
			__le16 l_i_uid_high; /* these 2 fields */
			__le16 l_i_gid_high; /* were reserved2[0] */
			__u32 l_i_reserved2;
		} linux2;
		struct {
			__u8 h_i_frag; /* Fragment number */
			__u8 h_i_fsize; /* Fragment size */
			__le16 h_i_mode_high;
			__le16 h_i_uid_high;
			__le16 h_i_gid_high;
			__le32 h_i_author;
		} hurd2;
		struct {
			__u8 m_i_frag; /* Fragment number */
			__u8 m_i_fsize; /* Fragment size */
			__u16 m_pad1;
			__u32 m_i_reserved2[2];
		} masix2;
	} osd2; /* OS dependent 2 */
};
#define EXT2_NDIR_BLOCKS 12
#define EXT2_IND_BLOCK EXT2_NDIR_BLOCKS
#define EXT2_DIND_BLOCK (EXT2_IND_BLOCK + 1)
#define EXT2_TIND_BLOCK (EXT2_DIND_BLOCK + 1)
#define EXT2_N_BLOCKS (EXT2_TIND_BLOCK + 1)
//inode 的⼤⼩通常是 128 字节 或 256 字节
问题:知道inode号的情况下,在指定分区,请解释:对文件进行增、删、查、改是在做什么?
结论:
- 分区之后的格式化操作,就是对分区进行分组,在每个分组中写入SB、GDT、Block
Bitmap、Inode Bitmap等管理信息,这些管理信息统称:文件系统- 只要知道文件的inode号,就能在指定分区中确定是哪一个分组,进而在哪一个分组确定
是哪一个inode- 拿到inode文件属性和内容就全部都有了
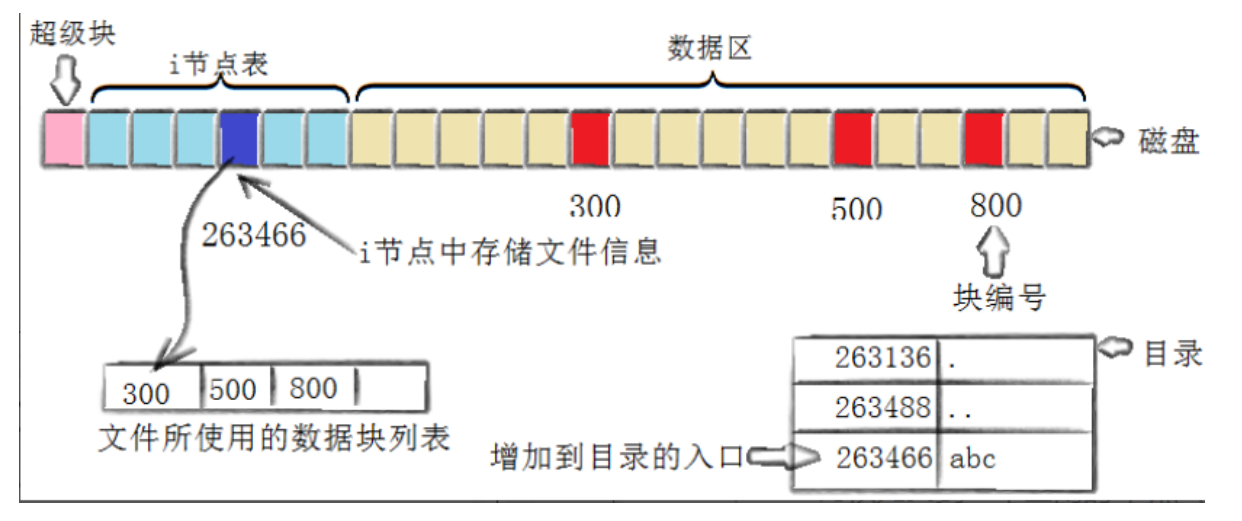
创建一个新文件主要有以下4个操作:
- 存储属性
内核先找到一个空闲的i节点(这里是263466)。内核把文件信息记录到其中。- 存储数据
该文件需要存储在三个磁盘块,内核找到了三个空闲块:300, 500,800。将内核缓冲区的第一块数据复制到300,下一块复制到500,以此类推。- 记录分配情况
文件内容按顺序300, 500, 800存放。内核在inode上的磁盘分布区记录了上述块列表。- 添加文件名到目录
新的文件名abc。linux如何在当前的目录中记录这个文件?内核将人口(263466,abc)添加到目录文件。文件名和inode之间的对应关系将文件名和文件的内容及属性连接起来。
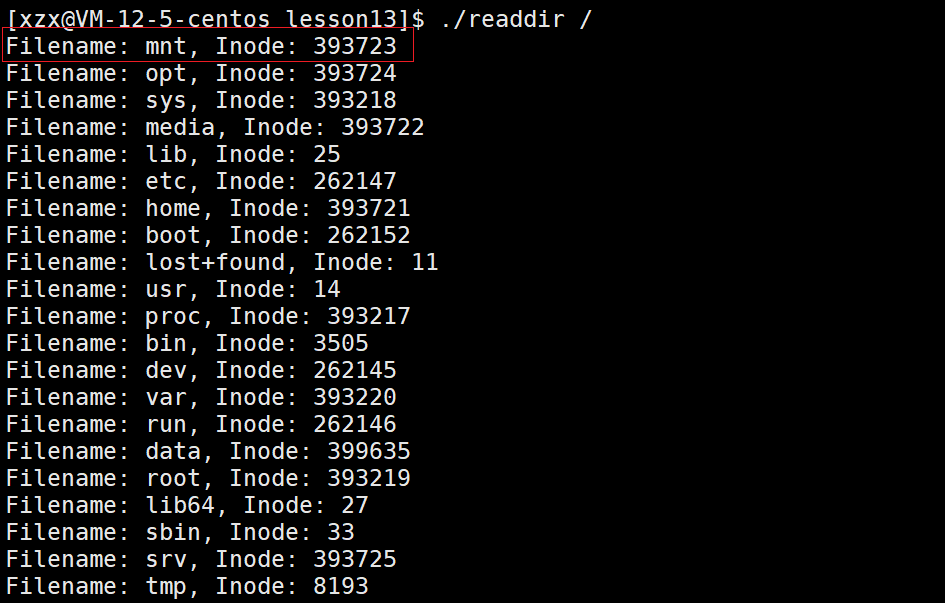
3.5 目录与文件名
- 目录也是文件,但是磁盘上没有目录的概念,只有文件属性+文件内容的概念。
- 目录的属性不用多说,内容保存的是:文件名和inode号的映射关系。
c
#include <stdio.h>
#include <string.h>
#include <stdlib.h>
#include <dirent.h>
#include <sys/types.h>
#include <unistd.h>
int main(int argc, char *argv[]) {
    if (argc != 2) {
        fprintf(stderr, "Usage: %s <directory>\n", argv[0]);
        exit(EXIT_FAILURE);
    }
    DIR *dir = opendir(argv[1]);
    if (!dir) {
        perror("opendir");
        exit(EXIT_FAILURE);
    }
    struct dirent *entry;
    while ((entry = readdir(dir)) != NULL) {
        if (strcmp(entry->d_name, ".") == 0 || strcmp(entry->d_name, "..") == 0) {
            continue;
        }
        printf("Filename: %s, Inode: %lu\n", entry->d_name, (unsigned long)entry->d_ino);
    }
    closedir(dir);
    return 0;
}
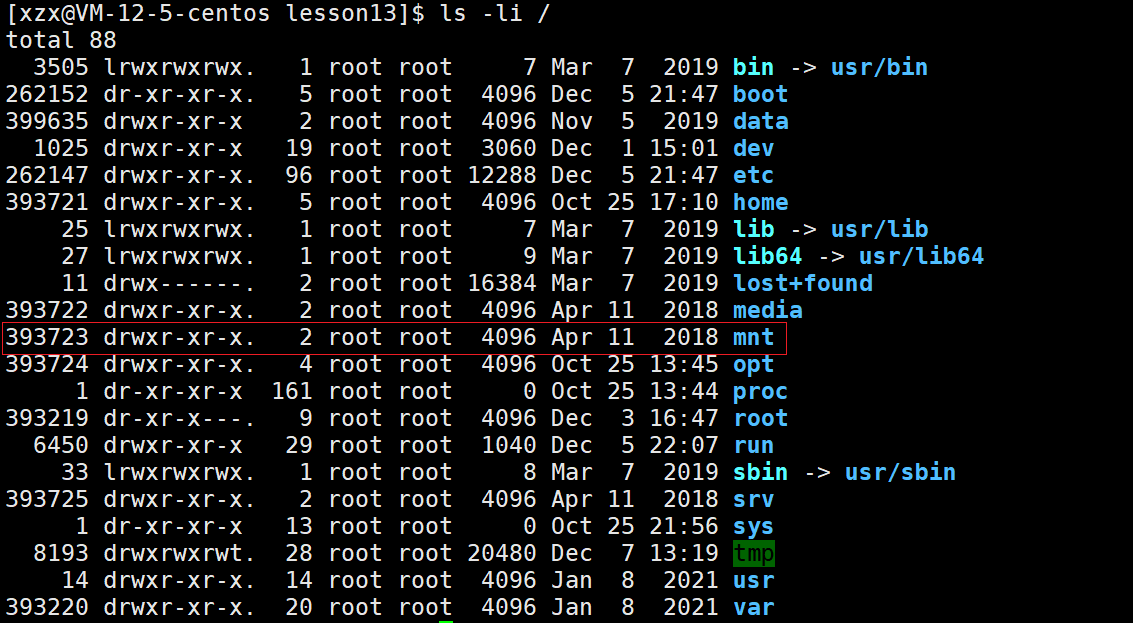
- 所以,访问文件,必须打开当前目录,根据文件名,获得对应的inode号,然后进行文件访问。
- 所以,访问文件必须要知道当前工作目录,本质是必须打开当前工作目录文件,查看目录文件的内容。
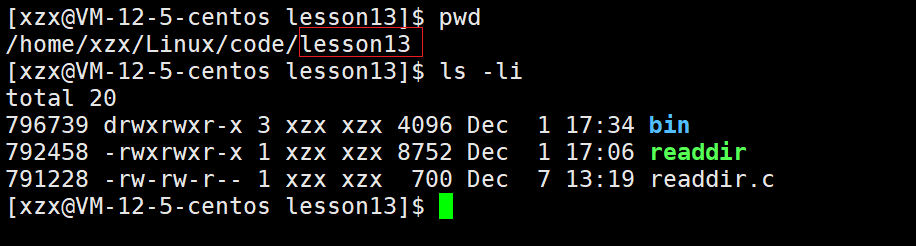
比如:要访问readdir.c,就必须打开lesson13(当前工作目录),然后才能获取readdir.c对应的inode进而对文件进行访问。
3.6 路径解析
我们要查看当前目录下文件的内容,当前工作目录存的是文件名与inode号的映射关系,但是当前工作目录也是文件啊,那么怎么获取当前工作目录文件的inode号呢?
那么就要查看上级目录文件内容,那上级目录也是文件啊,要打开它也要知道它的inode号,那也要打开它的上级目录啊?
所以类似"递归"的过程,需要把路径中所有的目录全部解析,出口是"/"根目录。
实际上,任何文件,都有路径,访问目标文件,比如:/home/xzx/Linux/code/lesson13/readdir.c
都要从根目录开始,依次打开每一个目录,根据目录名,依次访问每个目录下指定的目录,直到访问到readdir.c。这个过程叫做Linux路径解析。
- 所以,我们知道了:访问文件必须要有:目录 + 文件名 = 路径的原因
- 根目录固定文件名,inode号,无需查找,系统开机之后就必须知道
路径由谁提供?
- 你访问文件,都是指令/工具访问,本质是进程访问,进程有CWD!进程提供路径。
- 你打开文件,提供了路径。
可是最开始的路径从哪里来?
- 新建目录、家目录等等,本质就是在磁盘文件系统中,新建目录文件。而你新建的任何文件,都在你或者系统指定的目录下新建,这不就是天然就有路径了嘛!
- 系统+用户共同构建Linux路径结构。
3.7 路径缓存
Linux磁盘中,存在真正的目录吗?
不存在,只有文件。只保存文件属性+文件内容
访问任何文件,都要从根目录/开始进行路径解析?
原则上是,但是这样太慢,所以Linux会缓存历史路径结构
Linux目录的概念,怎么产生的?
打开的文件是目录的话,由OS自己在内存中进行路径维护
Linux中,在内核中维护树状路径结构的内核结构体叫做:struct dentry
c
struct dentry {
    atomic_t d_count;
    unsigned int d_flags; /* protected by d_lock */
    spinlock_t d_lock; /* per dentry lock */
    struct inode* d_inode; /* Where the name belongs to - NULL is
    * negative */
    /*
    * The next three fields are touched by __d_lookup. Place them here
    * so they all fit in a cache line.
    */
    struct hlist_node d_hash; /* lookup hash list */
    struct dentry* d_parent; /* parent directory */
    struct qstr d_name;
    struct list_head d_lru; /* LRU list */
    /*
    * d_child and d_rcu can share memory
    */
    union {
        struct list_head d_child; /* child of parent list */
        struct rcu_head d_rcu;
    } d_u;
    struct list_head d_subdirs; /* our children */
    struct list_head d_alias; /* inode alias list */
    unsigned long d_time; /* used by d_revalidate */
    struct dentry_operations* d_op;
    struct super_block* d_sb; /* The root of the dentry tree */
    void* d_fsdata; /* fs-specific data */
#ifdef CONFIG_PROFILING
    struct dcookie_struct* d_cookie; /* cookie, if any */
#endif
    int d_mounted;
    unsigned char d_iname[DNAME_INLINE_LEN_MIN]; /* small names */
};
注意:
- 每个文件其实都要有对应的dentry结构,包括普通文件。这样所有被打开的文件,就可以在内存中形成整个树形结构。
- 整个树形节点也同时会隶属于LRU(Least Recently Used,最近最少使用)结构中,进行节点淘汰。
- 整个树形节点也同时会隶属于Hash,方便快速查找。
- 更重要的是,这个树形结构,整体构成了Linux的路径缓存结构,打开访问任何文件,都在先在这棵树下根据路径进行查找,找到就返回属性inode和内容,没找到就从磁盘加载路径,添加dentry结构,缓存新路径。
3.8 挂载分区
我们已经能够根据inode号在指定分区找文件了,也已经能根据目录文件内容,找指定的inode了,在指定的分区内,我们可以为所欲为了。
问题:inode不是不能跨分区吗?Linux不是可以有多个分区吗?我怎么知道我在哪一个分区???
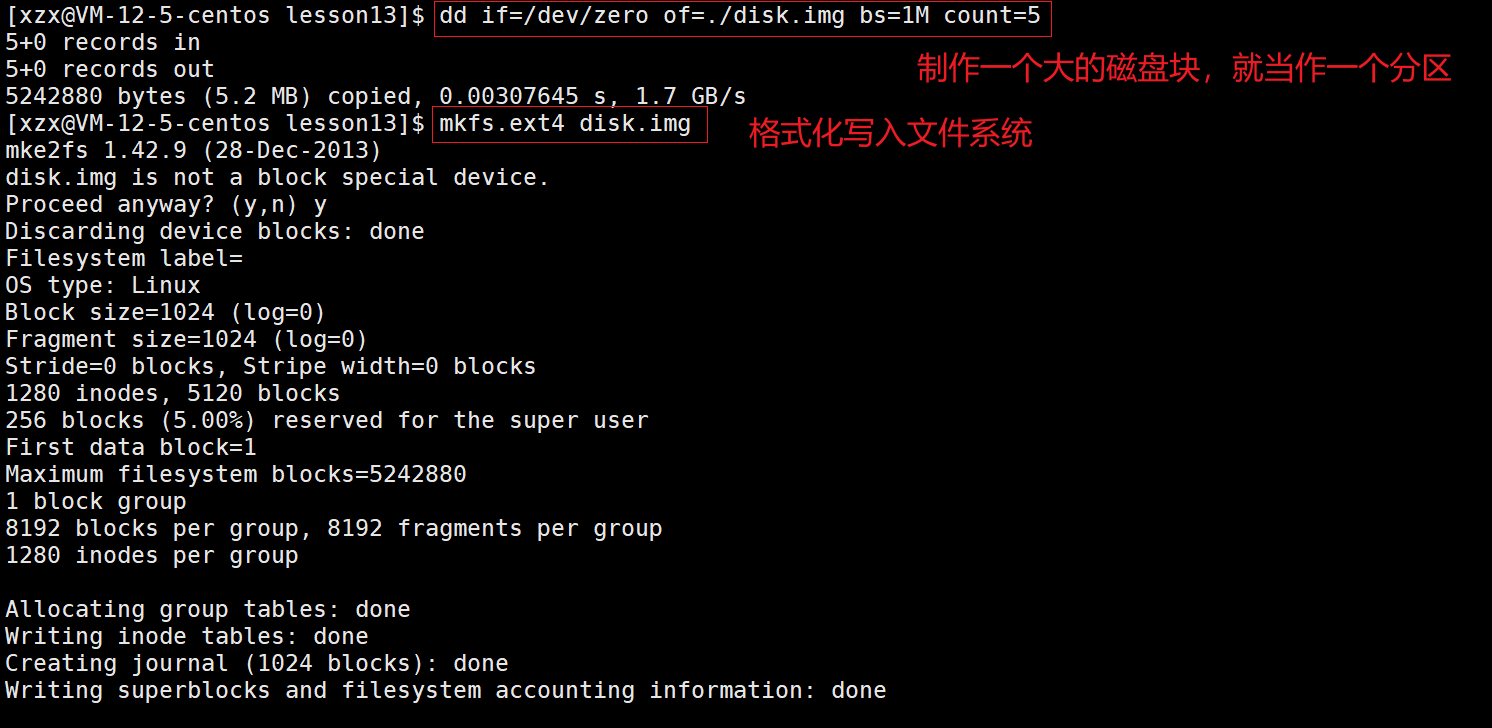
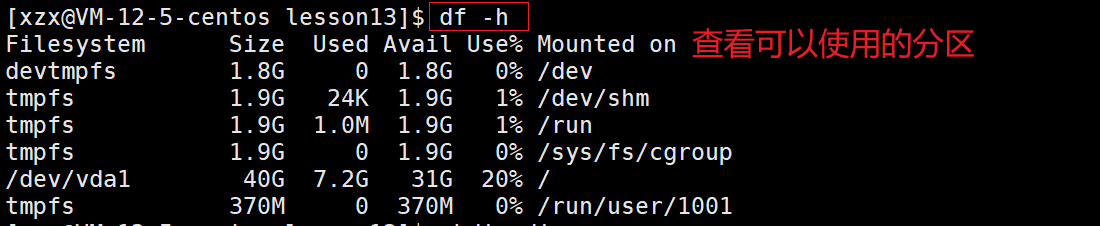
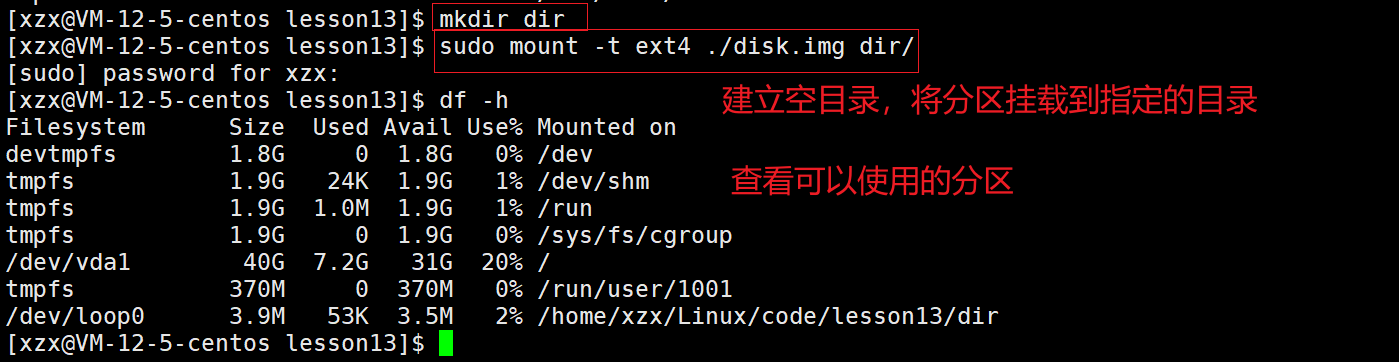
注意:
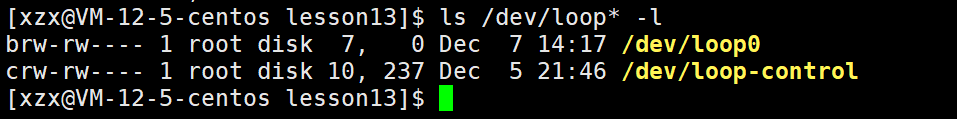
/dev/loop0 在Linux系统中代表第一个循环设备(loop device)。循环设备,也被称为
回环设备或者loopback设备,是一种伪设备(pseudo-device),它允许将文件作为块设备
(block device)来使用。这种机制使得可以将文件(比如ISO镜像文件)挂载(mount)为
文件系统,就像它们是物理硬盘分区或者外部存储设备一样。
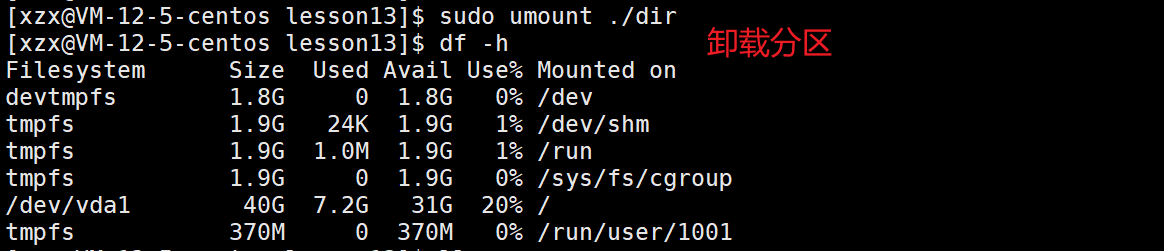
- 分区写入文件系统,无法直接使用,需要和指定的目录关联,进行挂载才能使用。
- 所以,可以根据访问目标文件的"路径前缀"准确判断我在哪一个分区。
四. 软硬链接
4.1 硬链接
我们看到,真正找到磁盘上文件的并不是文件名,而是inode。其实在linux中可以让多个文件名对应于同一个inode 。我们知道在一个目录中,存在.和. .两个隐藏文件,.指向当前目录,. .指向上级目录,它们就是典型的硬链接。
powershell
ln 已存在文件 硬链接文件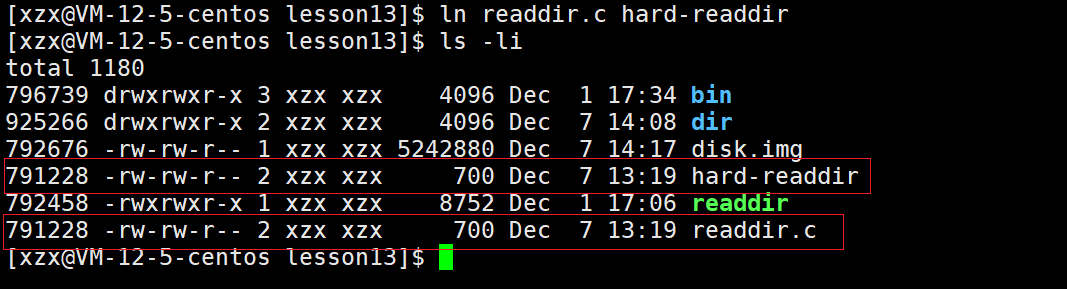
- readdir.c 和 hard-readdir 的链接状态完全相同,他们被称为指向文件的硬链接。内核记录了这个连接数,inode 791228 的硬连接数为2。
- 我们在删除文件时干了两件事情:1. 在目录中将对应的记录删除 ;2. 将硬连接数减1,如果为0,则将对应的磁盘释放。
4.2 软链接
硬链接是通过inode引用另外一个文件,软链接是通过名字引用另外一个文件,但实际上,新的文件和被引用的文件的inode不同,应用常见上可以想象成一个快捷方式。在shell中的做法:
powershell
ln -s 已存在文件 软链接文件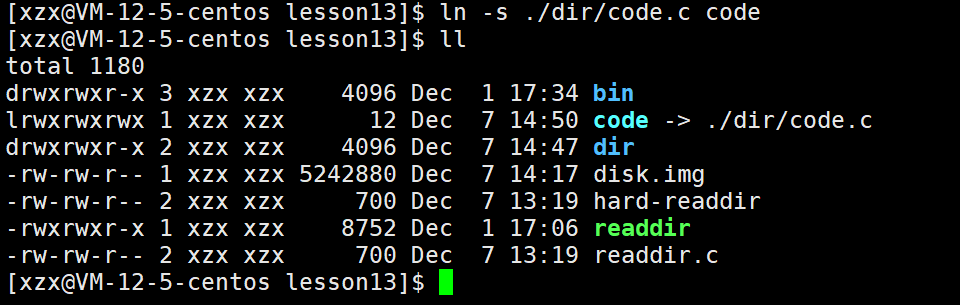
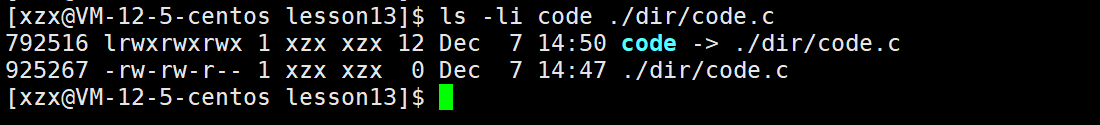
可以看到它们的inode号不一样,是两个不同的文件。
注意 :
我们只能给文件创建硬链接,不能给目录创建硬链接。
那.和. .不就是给目录创建硬链接吗?我们为什么不能创建?
这里还是为了避免循环路径问题,在内核中在路径搜索时,对
.和. .做了特殊处理,所以.和. .不会造成循环路径问题;软链接,它是一个独立的文件,在路径遍历时不会把他当做目录文件来处理。
如果我们自己创建硬链接,就有可能造成循环路径问题。
4.3 软硬链接的对比
- 软连接是独立文件
- 硬链接只是文件名和目标文件inode的映射关系
4.4 软硬链接的用途
硬链接
.和. .就是硬链接- 文件备份
软链接
- 类似快捷方式
最后
本篇关于文件系统的内容到这里就结束了,其中还有很多细节值得我们去探究,需要我们不断地学习。如果本篇内容对你有帮助的话就给一波三连吧,对以上内容有异议或者需要补充的,欢迎大家来讨论!