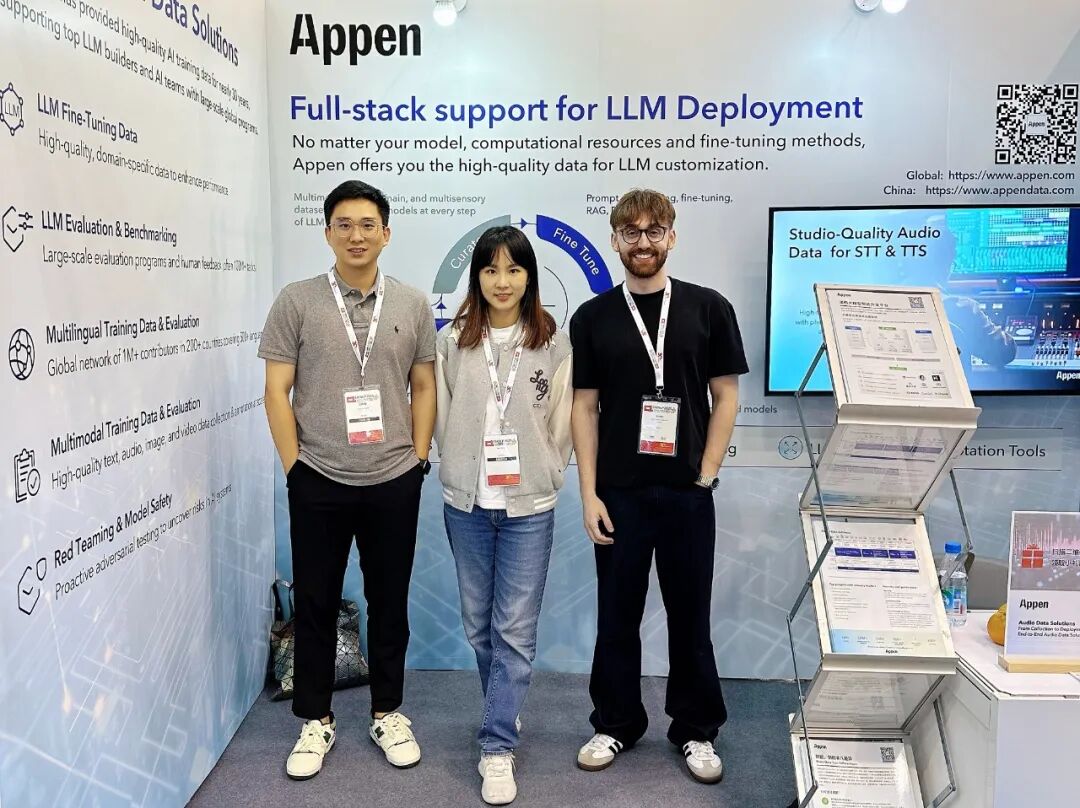
近日,自然语言处理领域的国际顶级学术会议EMNLP 2025 在苏州隆重举行。作为全球NLP领域最具影响力的学术盛会,EMNLP一直引领着语言人工智能的技术发展方向,汇聚了来自世界各地的顶尖学者和行业领军者。本届会议聚焦多语言NLP技术的前沿突破,特别关注代码切换、方言变异和区域语言多样性等关键议题,澳鹏Appen携最新研究成果再次深度参与大会。
多元语言技术:从边缘走向中心
本届EMNLP会议的一个显著趋势是:语言多样性研究已从边缘话题走向舞台中央,研究重点开始转向深入探讨方言、语言的区域变体和语码转换等现实场景。这与澳鹏长期坚持的数据理念高度契合------我们始终致力于为AI系统提供包容性强、扎根本土文化的训练数据,使其真正理解全球用户的真实语言使用习惯。
研究前沿:基于现实场景的最新成果
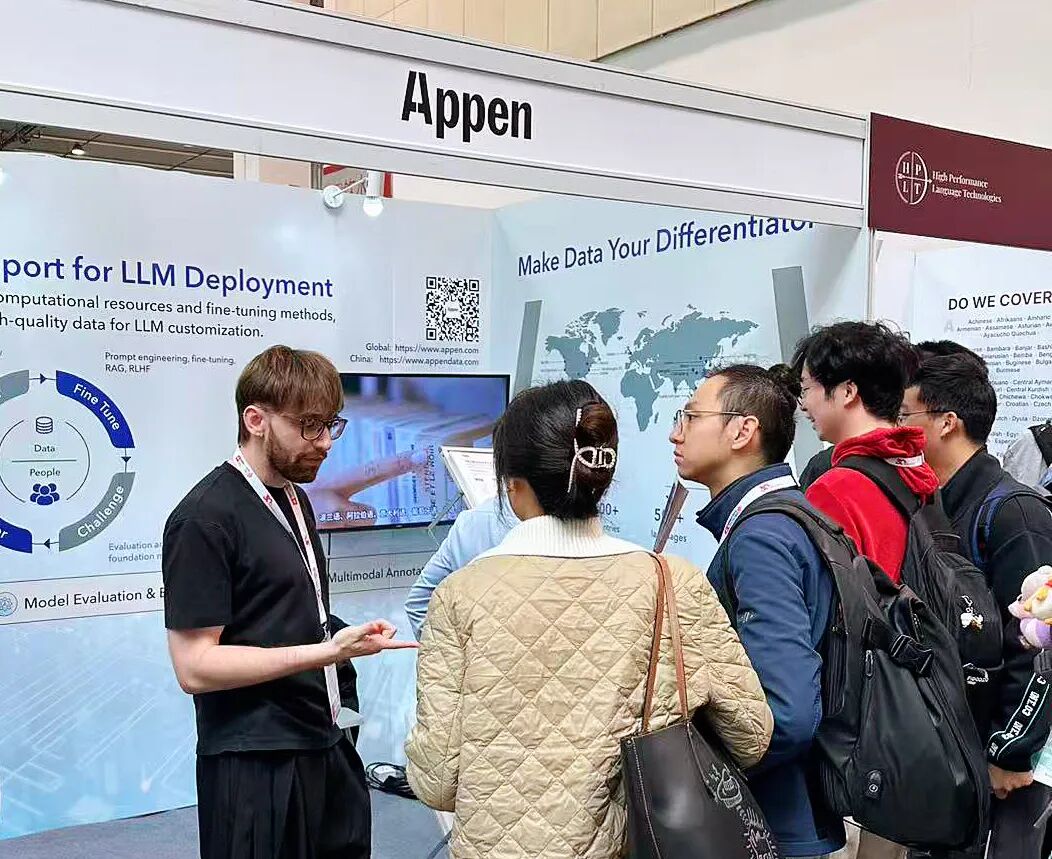
在会议期间,澳鹏研究团队分享了最新研究成果《多语言LLM翻译:评估不同文化中的细微差别》。这项先驱性研究分析了20多种语言的LLM翻译表现,从西班牙语、法语等高资源语言到古吉拉特语、伊博语等地区性语言,揭示了在文化对齐评估下翻译质量存在的显著差距。
同时,会议呈现的几个关键研究方向值得关注:
-
代码切换数据集的规模化构建
-
压力测试下的语言识别技术
-
更具包容性的数据集策划和标注标准
-
反映现实场景的评估体系等
澳鹏实践:将学术洞察落地为解决方案
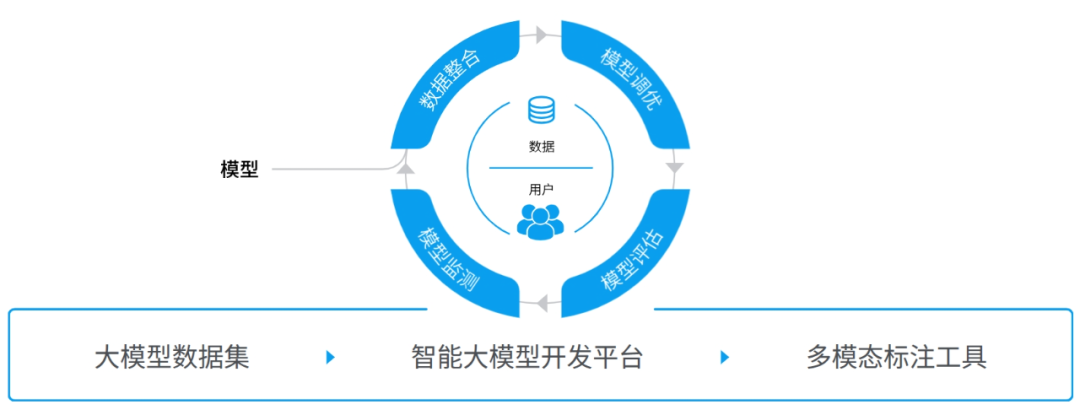
模型的性能取决于其训练数据和评估标准。要构建在方言、语言变体和语码转换等场景下表现优异的模型,必须建立能够有效捕捉这些特征的数据管道。
我们的实践方法包括:
-
方言导向的资源招募:按方言、地域、使用场景精准招募与筛选语言专家
-
文化适配的标注指南:与语言学家和母语使用者共同设计标注规范
-
平台内嵌质量保障机制:通过动态测试题、模型辅助循环等机制保障质量
-
模型在环的数据生成(Model-in-the-loop):针对难以覆盖的语言变体,通过少量经过严格审核的种子数据集,启动定向数据采集和主动学习闭环
展望未来
EMNLP2025清晰表明:方言、语言变体和语码转换正在塑造下一代语言模型的发展方向。研究界正在构建基准和方法,而产业界需要能够将其落地的数据管道。澳鹏期待与产学研伙伴携手,共同推动多语言NLP技术迈向新的高度。