爬楼梯问题:从递归到动态规划再到闭包的 "通关秘籍" 🧗♂️
一、问题描述:楼梯上的数学谜题 🧐
想象一下:你站在楼梯下,抬头望着 n 阶台阶的楼顶,每次只能迈 1 步或 2 步 ------ 请问,有多少种不同的姿势能让你成功登顶?别小看这个问题,它可是编程面试中的 "常客",藏着从递归到动态规划的全套思维密码哦!
二、问题分析:拆解楼梯的 "家族树" 🌳
咱们换个角度思考:假设你已经站在第 10 阶台阶,那上一秒你可能在哪?显然,要么是从第 9 阶迈了 1 步,要么是从第 8 阶跨了 2 步。所以爬到 10 阶的方法数 = 爬到 9 阶的方法数 + 爬到 8 阶的方法数,即 f(10) = f(9) + f(8)。
依此类推:
f(9) = f(8) + f(7)f(8) = f(7) + f(6)- ...
这就形成了一棵对称的 "递归树":
plaintext
        f(10)
   f(9)      f(8)
f(8) f(7) f(7)  f(6)
...  ...  ...   ...
看到这棵树,程序员的 DNA 是不是动了?没错!树形结构天生就适合用递归解决~ 而递归的终止条件也很明显:
- 爬 1 阶台阶:只有 1 种方法(迈 1 步),即
f(1) = 1 - 爬 2 阶台阶:两种方法(1+1 或 2),即
f(2) = 2
三、解法一:直接递归 ------ 简单但 "短命" 的解法 💥
先上代码感受下递归的直观:
javascript
function climbStairs(n) {
    // 递归终止条件:1阶1种方法,2阶2种方法
    if(n === 1) return 1;
    if(n === 2) return 2;
    // 递归公式:n阶方法数 = n-1阶 + n-2阶
    return climbStairs(n-1) + climbStairs(n-2);
}这代码够简单吧?但它有个致命问题:重复计算太疯狂 !比如算f(10)时,f(8)要算两次,f(7)要算三次... 当 n 超过 30,计算时间就肉眼可见地变慢;n 到 40,浏览器可能就开始 "卡壳";n 到 50?抱歉,大概率直接崩溃!
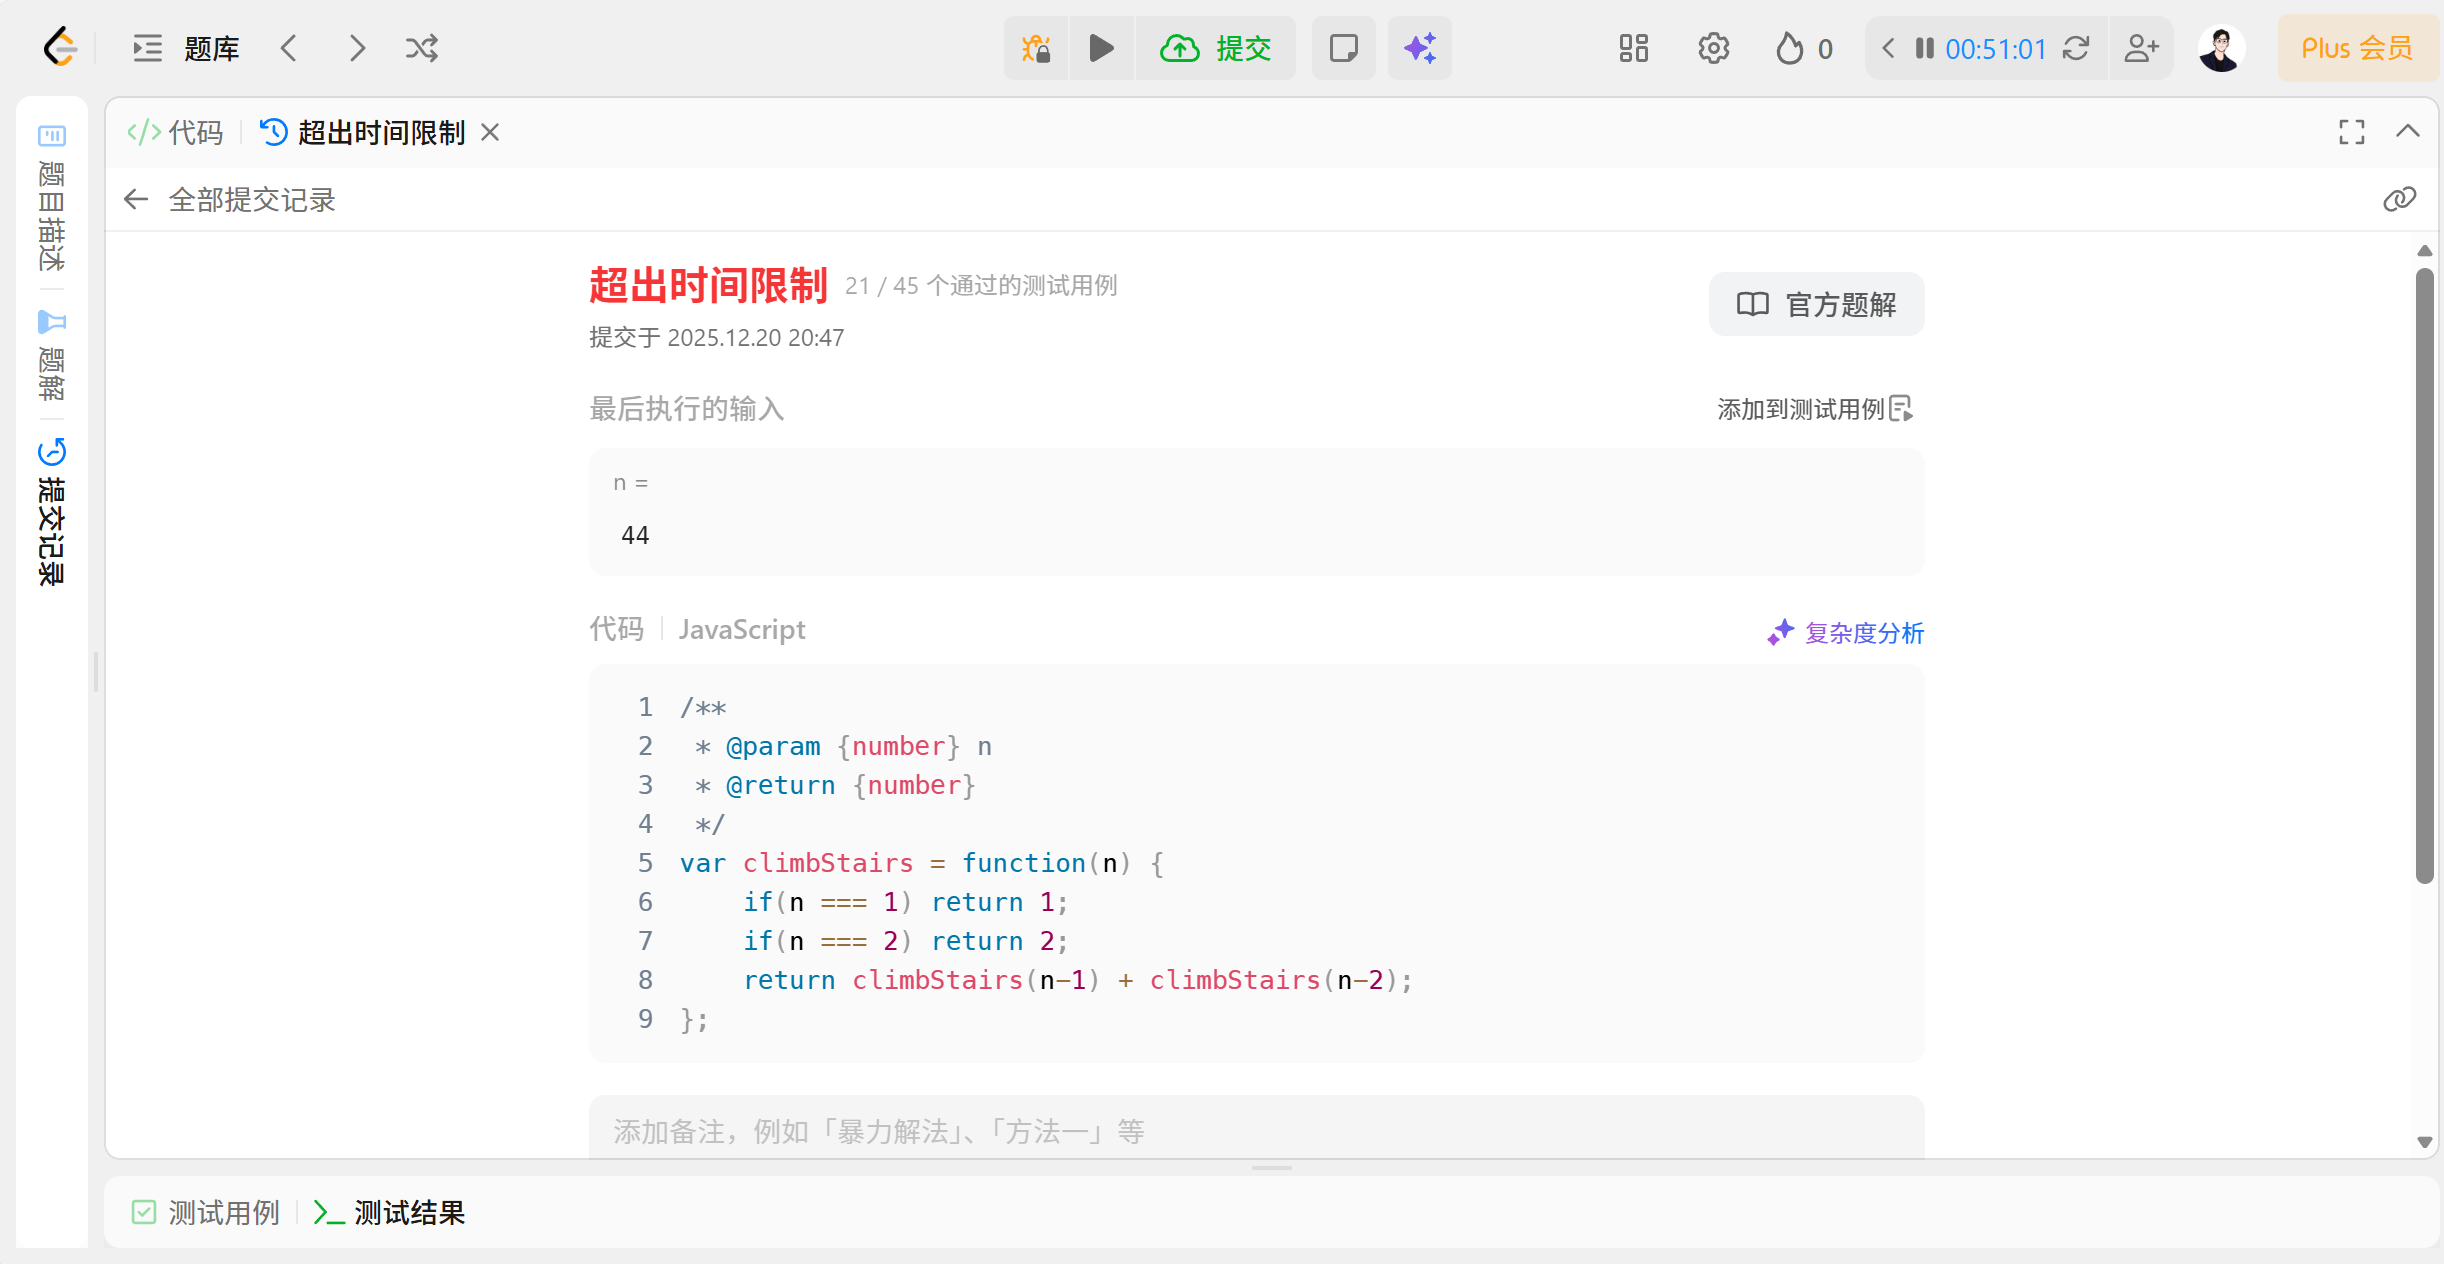
为啥会崩溃?这得从 JS 的 "调用栈" 说起。每次递归调用都会把函数压入调用栈,就像叠盘子 ------ 盘子叠得太高(递归层数太深),栈的内存就不够用了,这就是 "爆栈"。想象一下:你叠了 1000 个盘子,最后一个盘子放上去时,整个塔塌了... 这就是深递归的下场😭。
四、解法二:动态规划 ------ 用空间换时间的智慧 🧠
既然重复计算是元凶,那咱们就把算过的结果存起来!这就是动态规划的核心思路:缓存中间结果,避免重复劳动。
版本 1:数组缓存法
用一个数组dp专门存已经算好的结果,dp[i]表示爬到第i+1阶的方法数:
javascript
function climbStairs1(n) {
    // 边界条件处理
    if(n === 1) return 1;
    if(n === 2) return 2;
    // 初始化dp数组:dp[0]对应1阶,dp[1]对应2阶
    const dp = [1, 2];
    // 从3阶开始计算,直到n阶
    for(let i = 2; i < n; i++) {
        // 第i+1阶的方法数 = 第i阶 + 第i-1阶
        dp[i] = dp[i-1] + dp[i-2];
    }
    // 返回第n阶的方法数(数组索引比阶数小1)
    return dp[n-1];
}
比如 n=5 时,dp数组会变成[1,2,3,5,8],dp[4]就是 8------ 正好是爬 5 阶的方法数。这种方式把时间复杂度从递归的O(2^n)降到了O(n),效率飙升!
版本 2:HashMap 缓存法
如果觉得数组索引和阶数对应关系绕脑子,咱们可以换个更直观的方式 ------ 用Map键值对存储,key 直接存阶数,value 存对应方法数:
javascript
function climbStairs3(n) {
    // 非法输入处理
    if (n <= 0) return 0;
    // 基础情况
    if (n === 1) return 1;
    if (n === 2) return 2;

    // 初始化Map:键是阶数,值是方法数
    const dp = new Map([[1, 1], [2, 2]]);

    // 从3阶算到n阶
    for (let i = 3; i <= n; i++) {
        // 状态转移公式:当前阶数 = 前1阶 + 前2阶
        dp.set(i, dp.get(i - 1) + dp.get(i - 2));
    }

    // 直接返回n阶对应的方法数
    return dp.get(n);
}用Map的好处就像给每个台阶挂了个牌子,写着 "到这有 x 种方法",不用再纠结索引偏移,一看就懂~ 这两种动态规划方法本质一样,都是用空间换时间,只不过缓存容器不同而已📦。
五、解法三:带缓存的递归 ------ 给递归装个 "备忘录" 📝
递归虽然容易爆栈,但思路直观啊!能不能给递归加个 "备忘录",让它记住算过的结果?必须能!
版本 1:全局缓存的递归
javascript
// 全局缓存对象:key是阶数,value是方法数
const memo = {};
function climbStairs4(n) {
    // 基础情况
    if (n === 1) return 1;
    if (n === 2) return 2;
    // 缓存命中:如果算过,直接返回结果
    if (memo[n]) return memo[n];

    // 没算过就递归计算,并存入缓存
    memo[n] = climbStairs4(n - 1) + climbStairs4(n - 2);
    return memo[n];
}
缓存有多香? 以 n=5 为例:
- 第一次算
climbStairs4(5),需要算climbStairs4(4)和climbStairs4(3) - 算
climbStairs4(4)时,需要算climbStairs4(3)和climbStairs4(2) - 算
climbStairs4(3)时,得到结果 3,存入memo[3] = 3 - 回头算
climbStairs4(4)时,climbStairs4(3)直接从缓存拿,不用再算 - 最后算
climbStairs4(5)时,climbStairs4(4)和climbStairs4(3)都能从缓存拿
原本 n=5 要算 8 次的递归,现在只算 5 次!缓存就像考试时的小抄,记一次能用多次😏。
但这个版本有个坑:memo是全局变量!比如:
- 第一次调用
climbStairs4(5),memo里存了 3、4、5 的值 - 第二次调用
climbStairs4(3),会直接返回memo[3](上次存的 3) - 但如果我想 "重新计算" 呢?全局
memo不会自动清空,结果就被污染了! - 更糟的是,如果多个地方同时调用,
memo可能被并发修改,结果全乱套😱。
版本 2:闭包优化 ------ 给缓存加个 "私人空间" 🔒
怎么解决全局污染?用闭包!把memo藏在函数内部,只让递归函数访问:
javascript
// 立即执行函数表达式(IIFE):创建闭包环境
const climbStairs5 = (function() {
    // 私有缓存:被闭包持有,外界访问不到
    const memo = {};
    // 返回实际的递归函数
    return function(n) {
        if (n === 1) return 1;
        if (n === 2) return 2;
        // 缓存命中则直接返回
        if (memo[n]) return memo[n];
        // 计算后存入私有缓存
        memo[n] = climbStairs5(n - 1) + climbStairs5(n - 2);
        return memo[n];
    }
})();这里的(function() {})()叫立即执行函数表达式(IIFE) ,它会立刻执行,返回内部的递归函数。而memo被这个返回的函数 "记住" 了(形成闭包),既不会被外界修改,也不会在多次调用climbStairs5时重置 ------ 完美解决了全局污染和线程安全问题!
就像给memo建了个带锁的小房间,只有climbStairs5有钥匙,安全又省心🔑。
六、面试官会问啥?------ 这些坑你得知道 🕵️
-
递归为什么效率低? 答:因为存在大量重复计算(比如
f(5)会算两次f(3)),时间复杂度是O(2^n),而且深递归会爆栈。 -
动态规划的核心思想是什么? 答:把大问题拆成小问题,缓存小问题的解(空间换时间),避免重复计算,时间复杂度优化到
O(n)。 -
数组缓存和 Map 缓存各有什么优劣? 答:数组更省空间、访问更快,但需要处理索引偏移;Map 逻辑更直观(键是阶数),但性能略逊于数组。
-
闭包在这里解决了什么问题? 答:把缓存
memo私有化,避免全局变量污染,同时保证多次调用时缓存有效,还能防止并发修改。 -
还能再优化吗? 答:能!动态规划中其实不需要存整个数组 / Map,只需要存前两个值(比如
prev和prevPrev),空间复杂度能降到O(1)。// 5.动态规划的再次优化 自己好好理解一下哦!
function climbStairs0(n) {
if(n === 1) return 1;
if(n === 2) return 2;
let prev = 2;
let prevPrev = 1;
for(let i = 2; i < n; i++) {
let cur = prev + prevPrev;
prevPrev = prev;
prev = cur;
}
return cur;
}
七、结语:从 "暴力" 到 "聪明" 的进化之路 🚀
爬楼梯问题虽小,却藏着编程的大智慧:从直观但低效的递归,到用空间换时间的动态规划,再到用闭包优化缓存的递归 ------ 每一步优化都体现了 "发现问题→解决问题→追求极致" 的编程思维。
下次面试官再问这个问题,你可以自信地说:"我有三种解法,从青铜到王者,您想听哪种?" 😉
记住:好的代码不只是能跑通,更要跑得快、长得美、活得久~ 爬楼梯如是,编程亦如是!