本文将介绍如何使用 ModelScope(魔搭) 平台提供的 DINOv3 预训练模型,在本地进行批量图像特征提取,并输出可用于后续融合或蒸馏的特征向量。全程无需 Hugging Face 账号验证,直接加载本地或魔搭模型即可。
一、🛠️ 环境依赖
确保已安装以下库:
bash
pip install torch modelscope pillow
注意:本文使用的是 ModelScope(魔搭) 的 AutoModel 和 AutoImageProcessor,不依赖 Hugging Face Transformers 的模型下载权限。
二、📦 代码实现:批量特征提取器
python
# huggingface还要验证,先使用魔塔的模型

import torch
from modelscope import AutoImageProcessor, AutoModel
from transformers.image_utils import load_image
from PIL import Image
from typing import List, Union

class DINOv3FeatureExtractor:
    def __init__(self, pretrained_model_name: str):
        """
        初始化DINOv3模型和处理器。

        参数:
            pretrained_model_name (str): 预训练模型的路径或名称。
        """
        # 加载预处理工具和模型
        self.processor = AutoImageProcessor.from_pretrained(pretrained_model_name)
        self.model = AutoModel.from_pretrained(pretrained_model_name, device_map="auto")
        self.model.eval()  # 设置为评估模式

    def infer_batch_features(self, image_inputs: List[Union[str, Image.Image]]) -> torch.Tensor:
        """
        对给定的一批图像进行推理,返回提取的特征。

        参数:
            image_inputs (List[Union[str, Image.Image]]): 包含图像的本地路径、URL 或已加载的 PIL 图像列表。

        返回:
            torch.Tensor: 模型输出的 pooled 特征,形状为 [batch_size, hidden_size]。
        """
        images = []
        for image_input in image_inputs:
            if isinstance(image_input, str):
                image = load_image(image_input)
            else:
                image = image_input  # 假设已经是 PIL.Image.Image
            images.append(image)

        # 预处理所有图像并移至模型设备
        inputs = self.processor(images=images, return_tensors="pt").to(self.model.device)

        # 推理
        with torch.inference_mode():
            outputs = self.model(**inputs)

        # 返回 pooled 输出
        return outputs.pooler_output

# 示例用法
if __name__ == "__main__":
    model_path = "G:/code/Project_FM_Distill/RTdetrv2_FM_Distill/dinov3-vits16-pretrain-lvd1689m"
    extractor = DINOv3FeatureExtractor(model_path)

    urls = [
        "http://images.cocodataset.org/val2017/000000039769.jpg",
        "http://images.cocodataset.org/val2017/000000039769.jpg"
    ]
    features = extractor.infer_batch_features(urls)
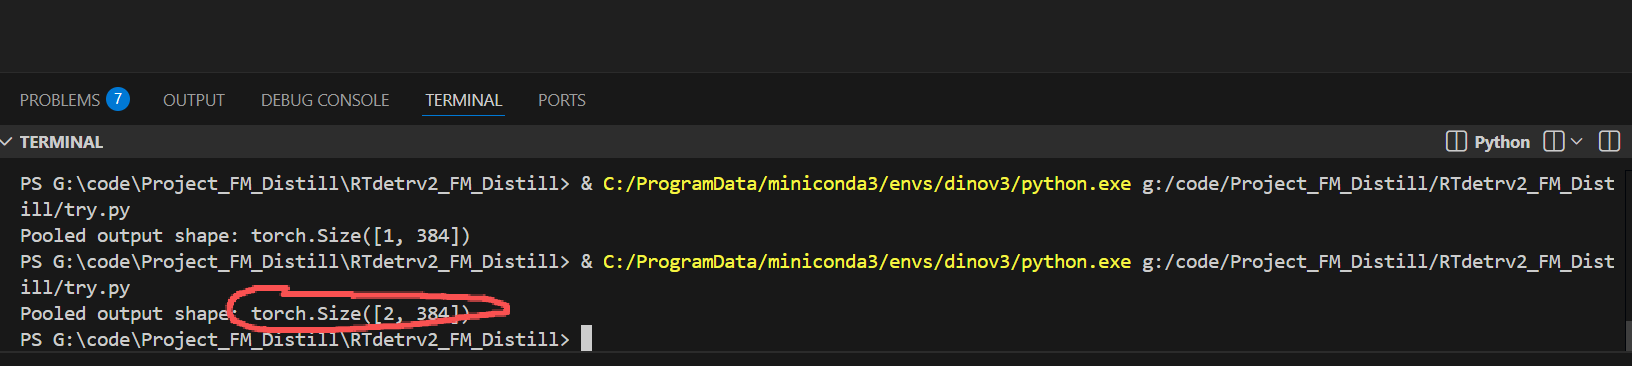
    print("Pooled output shape:", features.shape)
"""
后面不多说了,主要是给一个demo作为参考。
我放了一个完整包,包含权重文件:https://download.csdn.net/download/weixin_38252409/92493650
你也可以快速在魔塔社区下载:https://www.modelscope.cn/models/facebook/dinov3-vits16-pretrain-lvd1689m/files