二、RLHF
1. RLHF 基础概念
RLHF (Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)是一种通过人类偏好反馈来优化大语言模型的技术框架。其核心目标是让模型输出更安全 (safe)、有帮助 (helpful)且符合人类价值观。
典型应用模型:ChatGPT、LLaMA-3、Qwen2、DeepSeek-R1 等在对齐(alignment)阶段广泛使用。
主要模块及流程(三阶段,面试必背)
-
SFT (Supervised Fine-Tuning,有监督微调)
使用指令-回答对 数据集对预训练模型进行微调,让模型学会遵循指令 。
涉及模块:
- 数据加载器
- LoRA / PEFT 适配器
- Trainer 优化器
-
Reward Model(RM,奖励模型)
基于偏好数据集 训练一个分类或回归模型,学习给人类偏好的回答打分。
涉及模块:
- SequenceClassification 头
- 偏好损失函数(通常基于 Bradley-Terry 模型)
-
PPO (Proximal Policy Optimization,近端策略优化)
以 RM 作为奖励信号,通过强化学习迭代优化策略模型(即语言模型本身)。
涉及模块:
- 策略模型(Actor)
- 参考模型(用于 KL 惩罚)
- 价值函数(Critic)
- 在线采样器
整体流程 :
SFT 提供初始基线 → RM 捕捉人类偏好 → PPO 闭环迭代优化
常结合 Qwen / DeepSeek 的 MoE 架构,进一步提升多语言、长上下文对齐效果。
2. RLHF 和 DPO 的区别
RLHF vs DPO(Direct Preference Optimization)
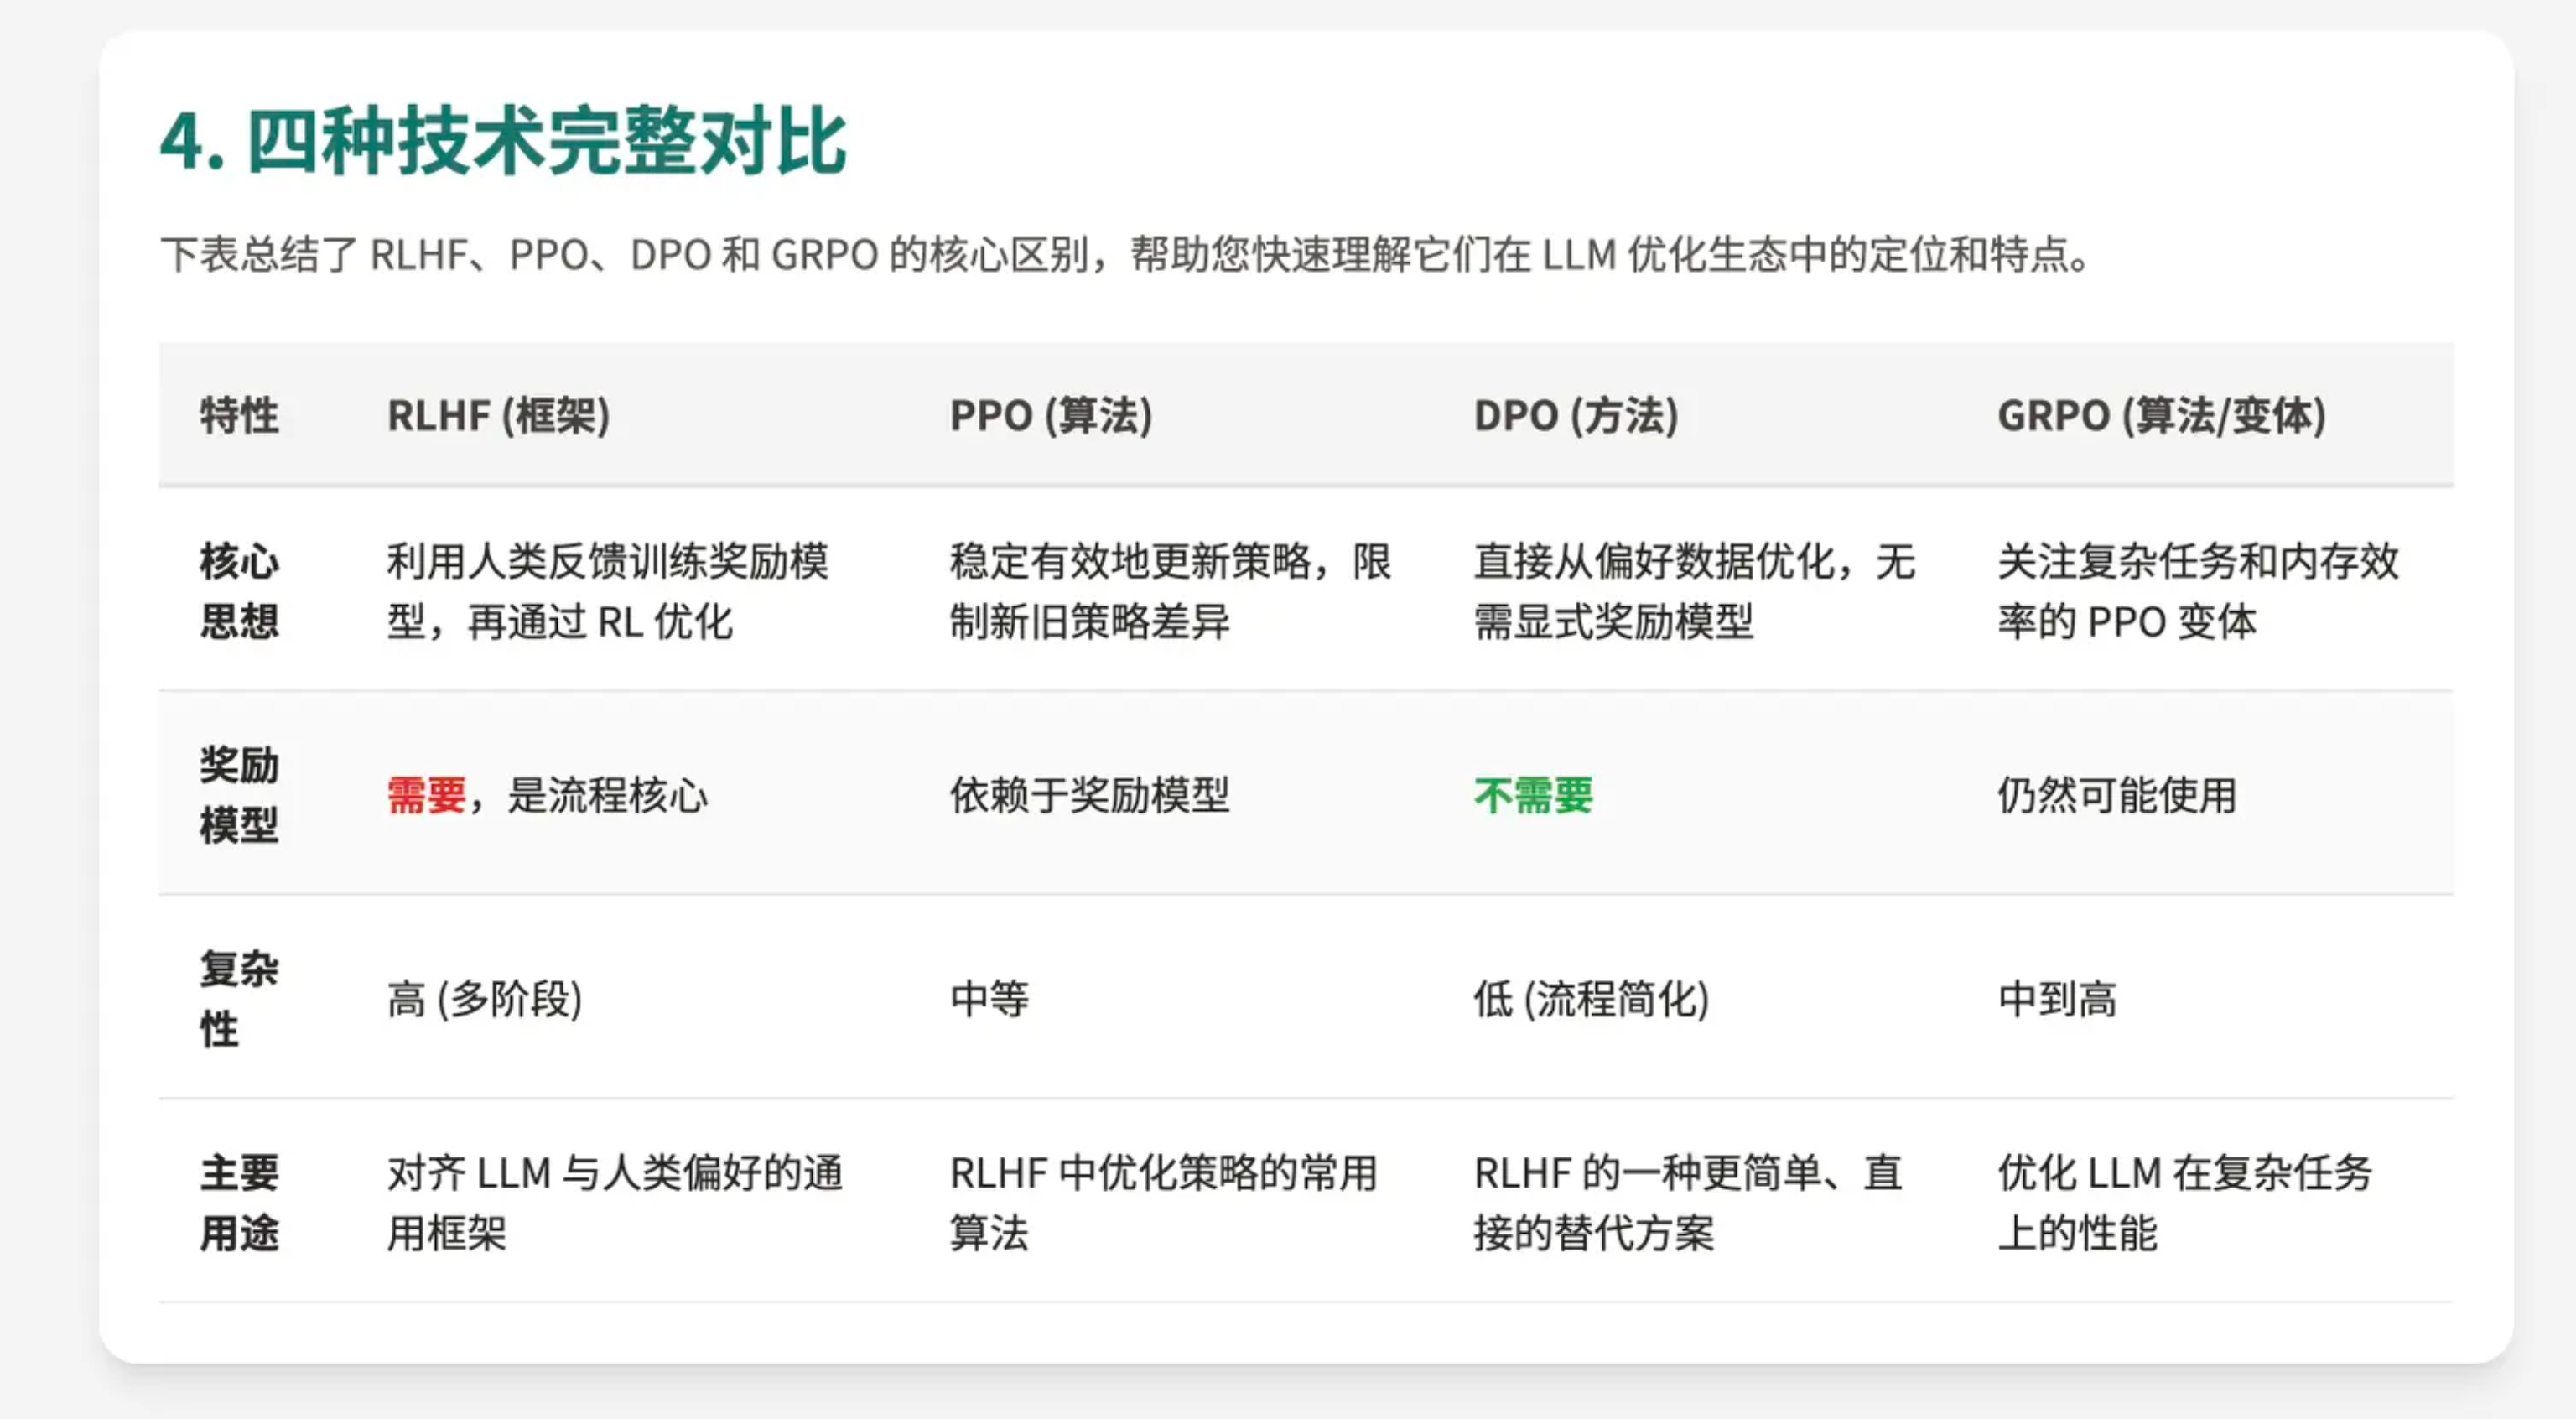
相似点 :
两者都利用偏好数据集来进行模型对齐,弥补纯 SFT 的局限性。
主要差异:
| 方面 | RLHF(带 PPO) | DPO |
|---|---|---|
| 训练方式 | 在线采样(生成新响应) | 离线优化 |
| 是否需要 RM | 需要独立的奖励模型 | 不需要 RM |
| 是否需要 PPO | 需要 PPO 进行强化学习 | 直接用偏好对计算损失 |
| 计算成本 | 较高、不稳定 | 更稳定、训练更快 |
| 探索能力 | 强(能探索新响应) | 较弱(依赖已有数据) |
| 典型代表 | DeepSeek-R1 | Qwen2.5(常用 DPO 变体如 SimPO) |
| 优缺点总结 | 上限高,但易模式崩溃(可加 KL 惩罚缓解) | 简单高效,但对数据质量敏感 |
简单一句话总结 :
DPO 是一种"更直接"的对齐方法,它跳过了奖励模型这一中间步骤,直接根据人类偏好数据优化语言模型。
与其他 RL 方法对比
- PPO vs REINFORCE:PPO 引入 clipping 机制,梯度更稳定,避免大更新导致训练崩溃。
- RLHF vs RLAIF (RL from AI Feedback):
RLHF 使用真人反馈,质量高但成本高;
RLAIF 使用强模型(如 GPT-4)合成反馈,成本低但可能引入偏差。
参考:https://deepseek.csdn.net/68425033965a29319f2524fd.html
3. RLHF 数据集类型
- 偏好数据集(Preference Dataset):每条数据包含 prompt + chosen(更好回答)+ rejected(较差回答)
- 纯 Prompt 数据集:仅包含 prompt,用于 PPO 在线采样生成新回答
- SFT 数据集:指令-回答对,用于初始监督微调
4. 代码实现(基于 Hugging Face TRL 库)
常用于 Qwen / DeepSeek 模型,面试代码题高频出现。
奖励模型(RM)训练代码
python
from trl import RewardTrainer, RewardConfig
from transformers import AutoModelForSequenceClassification

reward_model = AutoModelForSequenceClassification.from_pretrained(
    "Qwen/Qwen2-7B",
    num_labels=1
)

trainer = RewardTrainer(
    model=reward_model,
    args=RewardConfig(output_dir="./rm"),
    train_dataset=preference_dataset,  # 格式:{prompt, chosen, rejected}
    tokenizer=tokenizer
)

trainer.train()
PPO 训练代码
python
from trl import PPOTrainer, PPOConfig
from transformers import AutoModelForCausalLM

ppo_model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen2-7B")

ppo_trainer = PPOTrainer(
    model=ppo_model,                    # 需要优化的模型
    ref_model=sft_model,                # SFT 后的模型,用于 KL 惩罚
    reward_model=reward_model,          # 已训练好的奖励模型
    tokenizer=tokenizer,
    dataset=prompt_only_dataset,        # 只含 prompt 的数据集
    config=PPOConfig(batch_size=64, ppo_epochs=4)
)

ppo_trainer.train()
优化建议:
结合 LoRA / QLoRA 大幅降低显存占用
面试可能考点:手写 PPO 损失函数、数据加载逻辑等
5. RLHF 相关面试高频 Q&A(点对点)
Q: RLHF 为什么分为三个阶段?
A: SFT 打基础(学会指令跟随);RM 学习人类偏好(打分);PPO 迭代优化(探索更高奖励响应)。三者缺一不可,避免直接 RL 的低效。
Q: 为什么奖励模型(RM)不直接用来生成文本?
A: RM 是分类/回归模型,只负责打分,没有自回归生成能力;强行用于生成容易导致分布偏移和模型崩坏。
Q: PPO 为什么使用纯 prompt 数据集?
A: 需要在线采样生成全新响应以实现探索;如果带固定回答,会导致过拟合,失去强化学习的效果。
Q: DPO 相比 RLHF 的优势是什么?
A: DPO 无需训练 RM 和 PPO,训练更稳定、速度更快;RLHF 探索能力更强,但计算成本高。Qwen2 系列倾向使用 DPO 简化流程。
Q: PPO 中 KL 散度起什么作用?
A: 防止策略模型偏离参考模型(通常是 SFT 模型)太远,缓解模式崩溃问题。
代码体现:loss = -clipped_surrogate + value_loss + entropy - beta * kl_div
Q: DeepSeek-R1 是如何使用 RLHF 的?
A: 在 MoE 架构下使用 PPO 优化多语言偏好;数据集合成 + 人工标注结合,重点对齐长程推理能力。
参考文章: