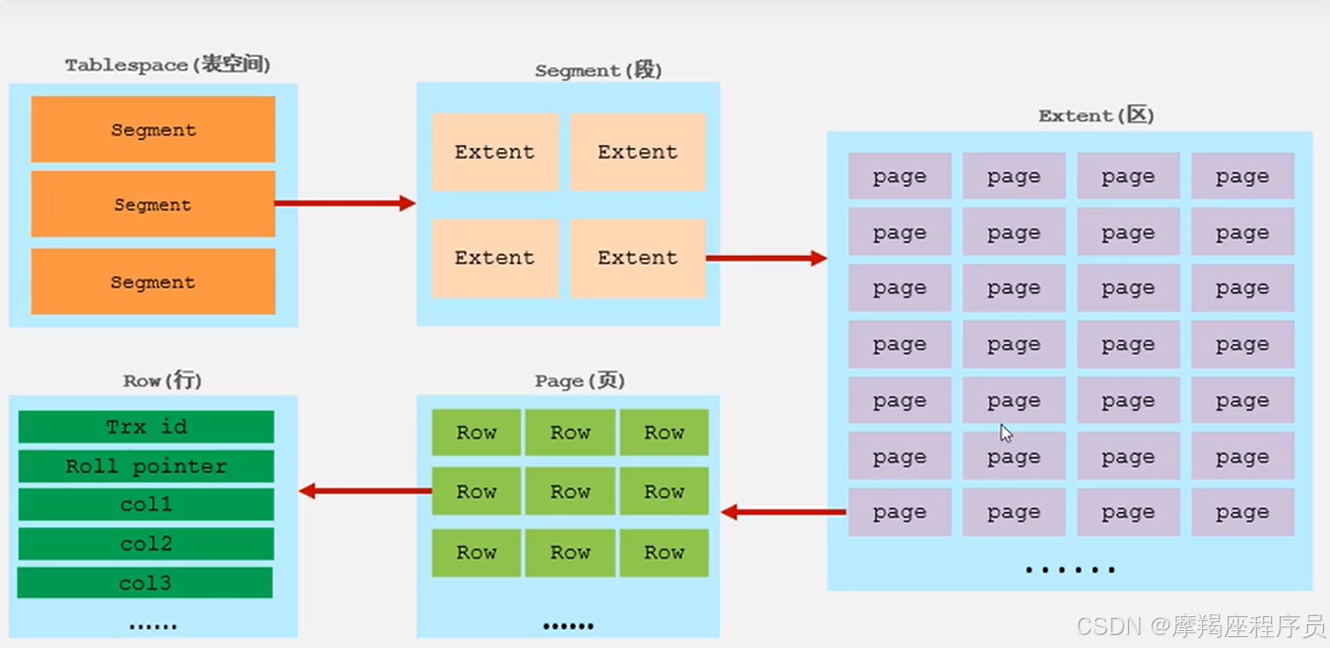
表空间(tablespace)--->段(segment)--->区(extent)--->页(page)--->行(row)
段:分为数据段(leaf node segment)、索引段(Non-leaf node segment)、回滚段(rollback segment),InnoDB是索引组织表,数据段就是B+树的叶子节点,索引段即为B+树的非叶子节点。段用来管理多个区(extent)。
区:表空间的单元结构,每个区的大小为1M。默认情况下,InnoDB存储引擎页大小为16K,即一个区中一共有64个连续的页。
页:是InnoDB存储引擎磁盘管理的最小单元,每个页的大小默认为16KB。为了保证页的连续性,InnoDB存储引擎每次从磁盘申请4-5个区。
MySQL5.5版本开始,默认使用InnoDB存储引擎,它擅长事务处理,具有崩溃恢复特性,在日常开发中使用非常广泛。
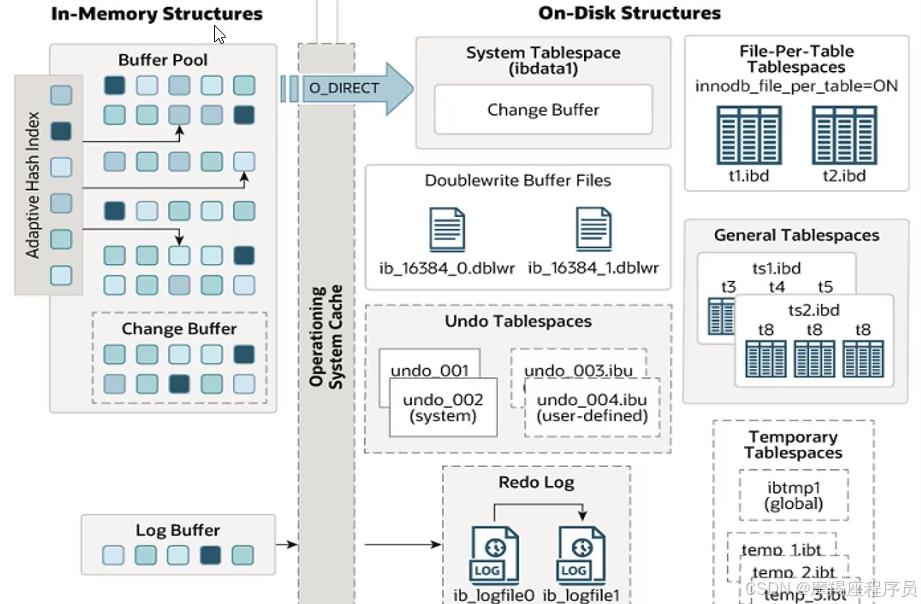
上图是InnoDB架构图,左侧为内存结构,右侧为磁盘结构
内存架构:
Buffer Pool:缓冲池是主内存中的一个区域,里面可以缓存磁盘上经常操作的真实数据,在执行增删改查操作时,先操作缓冲池中的数据(若缓冲池没有数据,则从磁盘加载并缓存),然后再以一定频率刷新到磁盘,从而减少磁盘IO,加快处理速度。
缓冲池以Page页为单位,底层采用链表数据结构管理Page。根据状态,将Page分为三种类型:
free page:空闲page,未被使用
clean page:被使用page,数据没有被修改过。
dirty page:脏页,被使用page,数据被修改过,也中数据与磁盘的数据产生了不一致。
Change Buffer:更改缓冲区(针对于非唯一二级索引页),在执行DML语句时,如果这些数据Page没有在Buffer Pool中,不会直接操作磁盘,而会将数据变更存在更改缓冲区Change Buffer中,在未来数据被读取时,再将数据合并恢复到Buffer Pool中,再将合并后的数据刷新到磁盘中。
Adpative Hash Index:自适应hash索引,用于优化对Buffer Pool数据的查询。InnoDB存储引擎会监控对表上各索引页的查询,如果观察到hash索引可以提升速度,则建立hash索引,称之为自适应hash索引。
自适应哈希索引,无需人工干预,是系统根据情况自动完成。参数adaptive_hash_index
Log Buffer:日志缓冲区,用来保存要写入到磁盘中的log日志数据(redo log、undo log),默认大小为16MB,日志缓冲区的日志会定期刷新到磁盘中。如果需要更新、插入或删除许多行的事务,增加日志缓冲区的大小可以节省磁盘I/0.
参数:
innodb_log_buffer_size: 缓冲区大小
innodb_flush_log_at_trx_commit: 日志刷新到磁盘的时机
磁盘结构
System Tablespace:系统表空间是更改缓冲区的存储区域。如果表是再系统表空间而不是每个表文件或通用表空间中创建的,它页可能包含表和索引数据。
参数:innodb_data_file_path
File-Per-Table Tablespaces: 每个表的文件表空间包含单个InnoDB表的数据和索引,并存储再文件系统上的单个数据文件中。
参数:innodb_file_per_table
事务原理:
事务是一组操作的集合,它是一个不可分割的工作单位,事务会把所有的操作作为一个整体一起向系统提交或撤销操作请求,即这些操作要么同时成功,要么同时失败。
特性:
原子性(atomicity):事务是不可分割的最下操作单元,要么全部成功,要么全部失败
一致性(consistency):事务完成时,必须使所有的数据都保持一致状态。
隔离性(isolation):数据库系统提供的隔离机制,保证事务在不受外部并发操作影响的独立环境下运行。
持久性(durability):事务一旦提交或回滚,它对数据库中的数据的改变就是永久的。
事务的原子性、一致性、持久性,由redo log 和 undo log来保障;
事务的隔离性由锁机制和MVCC来保障。
redo log:重做日志,记录的是事务提交时数据页的物理修改,是用来实现事务的持久性。
该日志文件由两部分组成:重做日志缓冲(redo log buffer)以及重做日志文件(redo log file),前者是在内存中,后者在磁盘中。当事务提交之后会把所有修改信息都存到该日志文件中,用于在刷新脏页到磁盘,发生错误时,进行数据恢复使用。
undo log
回滚日志,用于记录数据被修改前的信息,作用包含两个:提供回滚和MVCC(多版本并发控制)。
undo log 和redo log 记录物理日志不一样,它是逻辑日志。可以认为当delete一条记录时,undo log中会记录一条对应的insert记录,反之亦然,当update一条记录时,它记录一条对应相反的update记录。当执行rollback时,就可以从undo log中的逻辑记录读取到响应的内容并进行回滚。
undo log销毁:undo log在事务执行时产生,事务提交时,并不会立即删除undo log,因为这些日志可能还用于MVCC.
undo log存储:undo log采用段的方式进行管理和记录,存放在前面介绍的rollback segment回滚段中,内容包含1024个undo log segment。