YOLO深度学习(计算机视觉)—毕设笔记(yolo训练效率加快)

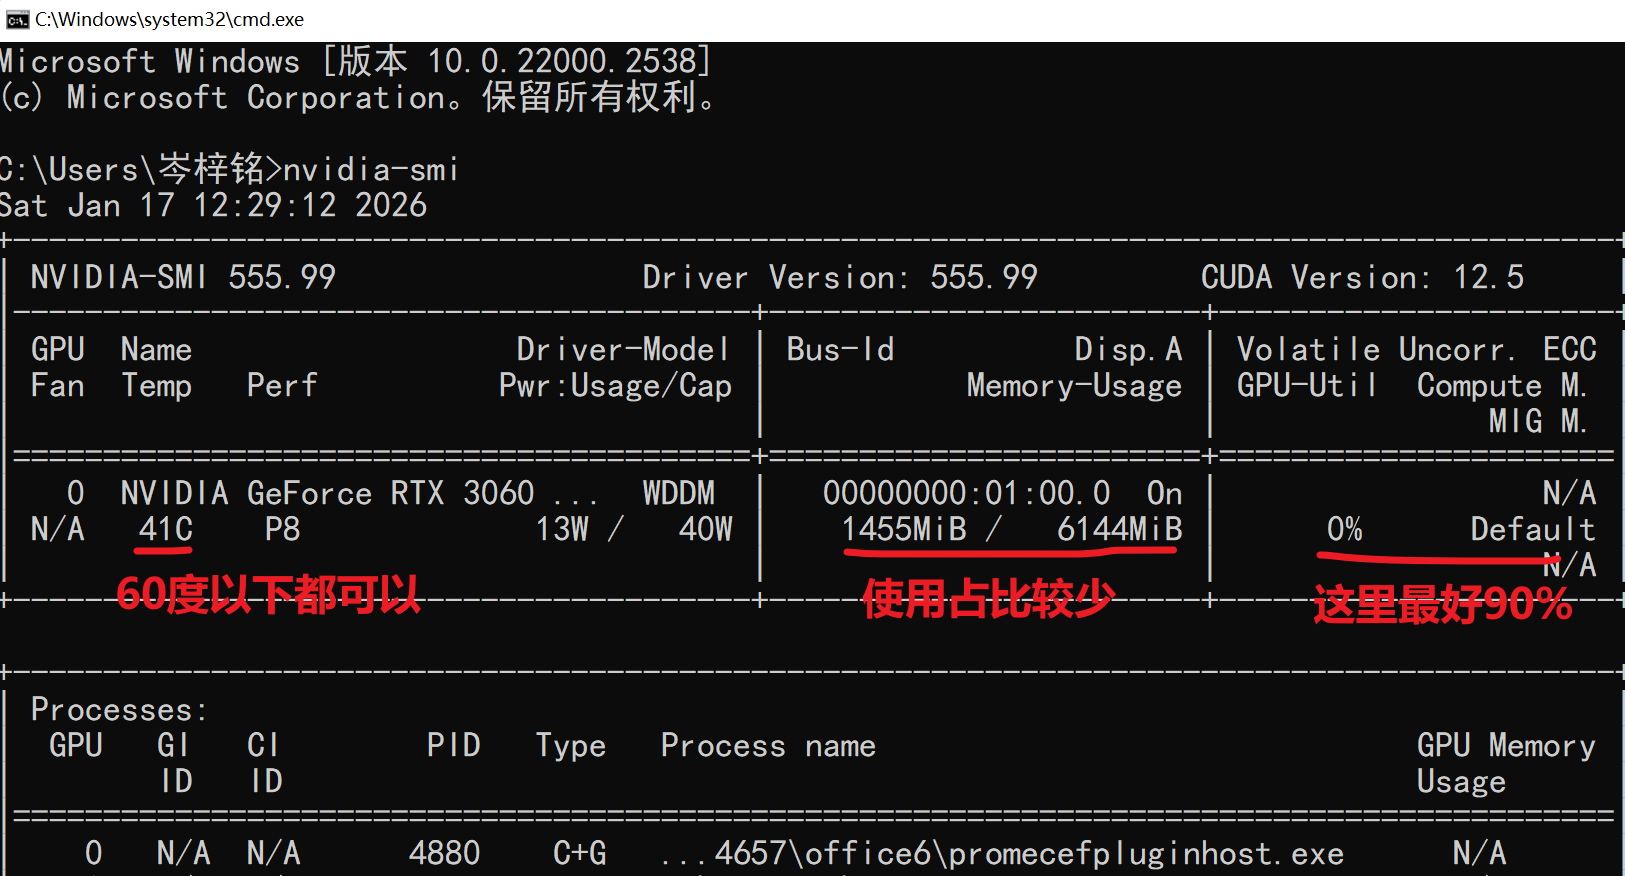
今天在网上看到一篇教学分享,一个博主说很多人有个错误的观念:虽然可以使用GPU跑模型,但是大家都认为自己电脑只有一个显卡,然后参数workers>0的时候就会报错,所以默认都设置workers=0就不会报错。

但实际这样并没有最大程度利用我们的GPU,我们输入命令【nvidia-smi】可以看到我们的显卡信息就可以看到我们是并没有充分利用的
解决方法就是:

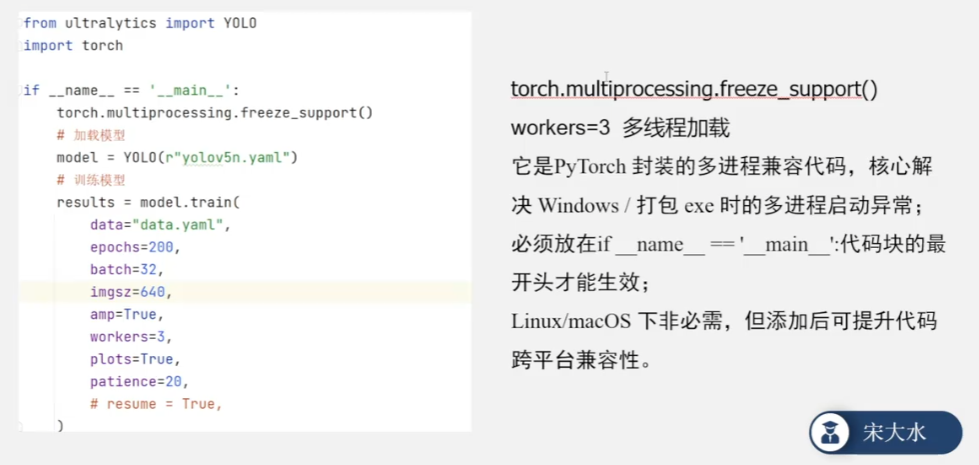
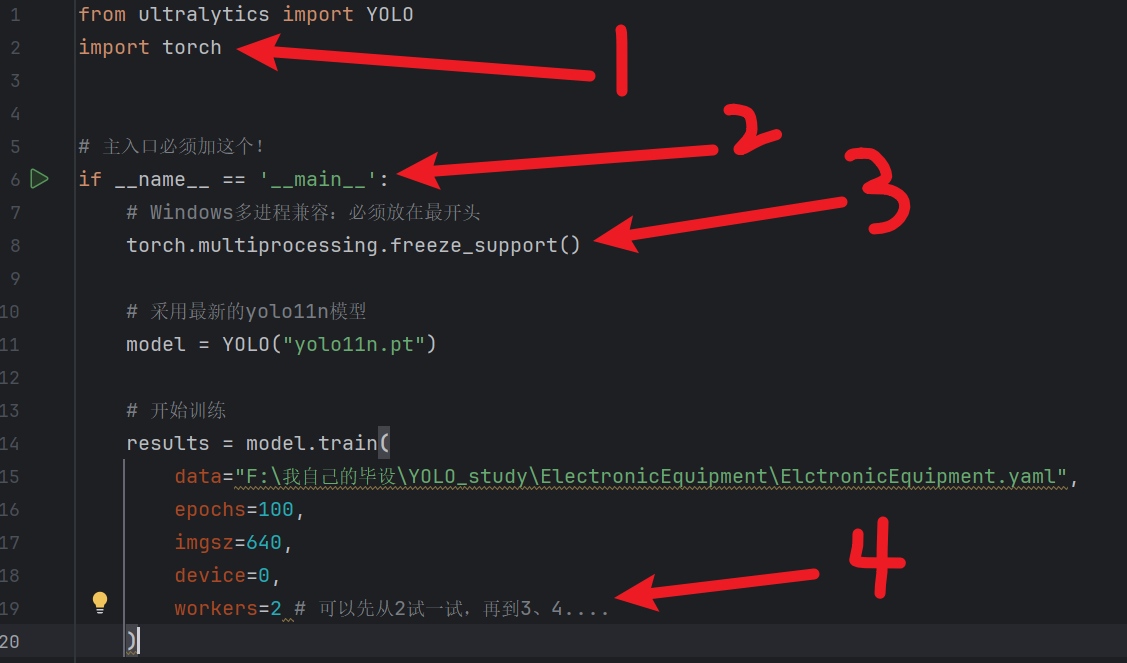
  • 把训练代码放到 if __name__ == '__main__': 代码块里
    • Windows 下开启 workers>0 必须满足用【if __name__ == '__main__':】包裹训练逻辑
  • 在块的最开头加 torch.multiprocessing.freeze_support()
例子

速度将会直线飞升!!!!!!!!
相关推荐
风之九子1 分钟前
在上游一天两版的项目上做二次开发:9 天 65 次提交的 fork 手记 (dsh-our-free-model)
人工智能·ai·github
goehou1 分钟前
LoRA 微调实战 - 显存、标签掩码与合并部署的踩坑记录(附清单)
深度学习·lora·大模型·模型微调
米小虾3 分钟前
工作流还是自主 Agent:怎么选、怎么混
人工智能·agent
坤坤子吖7 分钟前
Linux 线程同步与互斥——条件变量与线程同步
linux·开发语言·c++·笔记·学习
FII工业富联科技服务11 分钟前
AI+制造还是制造+AI?从2026工博会看工业AI落地的典型问题与解法
人工智能·制造
wangfpp14 分钟前
本地大模型微调与 GGUF 部署全指南
人工智能·agent
Smoothcloud润云15 分钟前
GPU算力平台跑知识库问答,模型回答总跑偏?先排查检索链路
人工智能·python·深度学习·gpu算力·gpu
乐橙开放平台17 分钟前
不用换摄像头,如何用乐橙把海康、大华、宇视统一到一个界面
笔记·物联网·自动化·音视频·智能家居
mklpo14718 分钟前
python3:如何按照实际执行需求导入模块,而不是启动时统一导入?(Python3.15)。2026-10-20
开发语言·人工智能·python