Hive简介
http://hive.apache.org/
Apache Hive数据仓库软件方便了使用SQL读取、写入和管理驻留在分布式存储中的大型数据集。结构可
以投影到已经存储的数据上。提供命令行工具和JDBC驱动程序将用户连接到Hive。
由Facebook开源用于解决海量结构化日志的数据统计工具。Hive是基于Hadoop的一个数据仓库工具, 可以将结构化的数据文件映射为一张表,并提供类SQL查询功能。
Hive产生的原因:**非java编程者通过SQL语句对hdfs的数据做mapreduce操作。
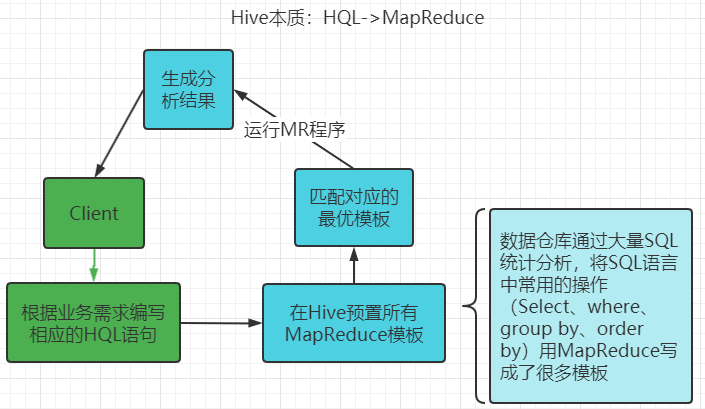
**Hive本质:将HQL转化成MapReduce程序
- Hive处理的数据存储在HDFS
- Hive分析数据底层的实现是MapReduce
- 执行程序运行在Yarn上
Hive和关系型数据库区别
|-----------------|--------------|-----------------------|
| 对比项 | Hive | 关系型数据库 |
| 查询语句 | HQL | SQL |
| 数据存储 | HDFS | Local FS or RawDevice |
| 执行器 | MapReducer | Executor |
| 数据insert | 支持批量导入和单条插入 | 支持批量导入和单条插入 |
| 数据Update和delete | 支持追加,不支持删除 | 行级别更新和删除 |
| 数据规模 | 大 | 小 |
| 执行延迟 | 高 | 低 |
| 分区 | 支持 | 支持 |
| 索引 | v0.8后支持 | 支持 |
| 数据加载模式 | 读时模式(快) | 写时模式(慢) age int |
| 扩展性 | 高 | 低 |
| 应用场景 | 海量数据查询 | 实时查询 |
Hive 的优缺点
优点
-
操作接口采用类SQL语法,提供快速开发的能力(简单、容易上手)。
-
避免了去写MapReduce,减少开发人员的学习成本。
-
Hive的执行延迟比较高,因此Hive常用于数据分析,对实时性要求不高的场合。
-
Hive优势在于处理大数据,对于处理小数据没有优势,因为Hive的执行延迟比较高。
-
Hive支持用户自定义函数,用户可以根据自己的需求来实现自己的函数。
缺点
1. Hive的HQL表达能力有限
A.迭代式算法无法表达
B.数据挖掘方面不擅长,由于MapReduce数据处理流程的限制,效率更高的算法却无法实现。
2. Hive的效率比较低
A.Hive自动生成的MapReduce作业,通常情况下不够智能化
B.Hive调优比较困难,粒度较粗
Hive架构
• Hive的架构
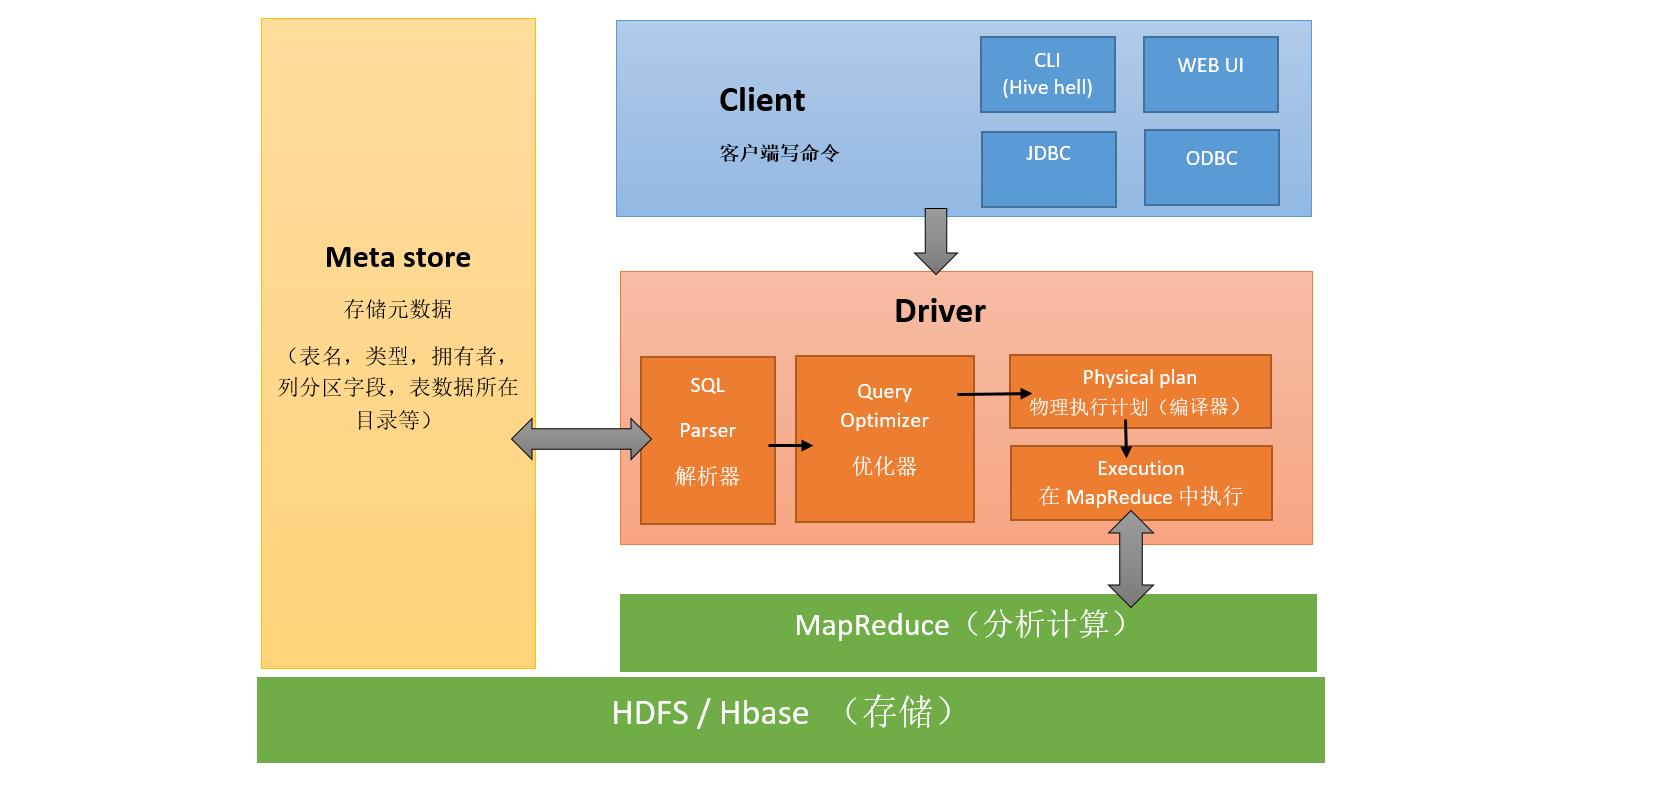
(1)用户接口主要有三个: CLI,JDBC/ODBC和 WebUI。其中最常用的是CLI ,Cli启动的时候,会同时启动一个Hive副本。 Client是Hive的客户端,用户连接至Hive Server。在启动 Client模式的时候,需要指出Hive Server所在节点,并且在该节点启动Hive Server。 WUI是通过浏览器访问Hive。
(2) Hive将元数据存储在数据库中,如mysql、derby(hive自带的内存数据库)。 Hive中的元数据包括表的名字,表的列和分区及其属性,表的属性(是否为外部表等),表的数据所在目录等。
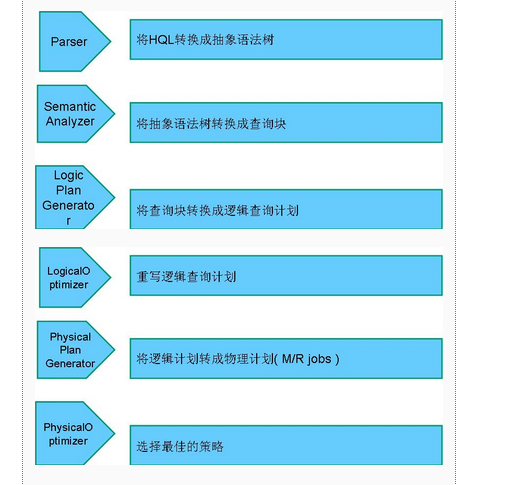
(3)解释器(SQL Parser )、编译器(Compiler )、优化器(Optimizer)完成HQL查询语句从词法分析、语法分析、编译、优化以及查询计划的生成。生成的查询计划存储在HDFS中,并在随后有执行器( Executor)调用MapReduce执行。
解释器:将HQL字符串转换为抽象语法树AST,通过使用第三方工作完成,比较antlr;对AST进行语法分析,比如表是否存在、字段是否存在、 HQL语义是否存在错误等。
编译器:将AST编译生成逻辑执行计划。
优化器:对逻辑执行计划进行优化。
执行器:把优化后的逻辑执行计划转换成可以运行的物理计划。对于Hive来说就是MR/Spark。
(4) Hive的数据存储在HDFS中,大部分的查询、计算由MapReduce完成(包含*的查询,比如select * from tbl不会生成MapRedcue任务)。
比如:select id,name from psn;
• Operator(操作符)
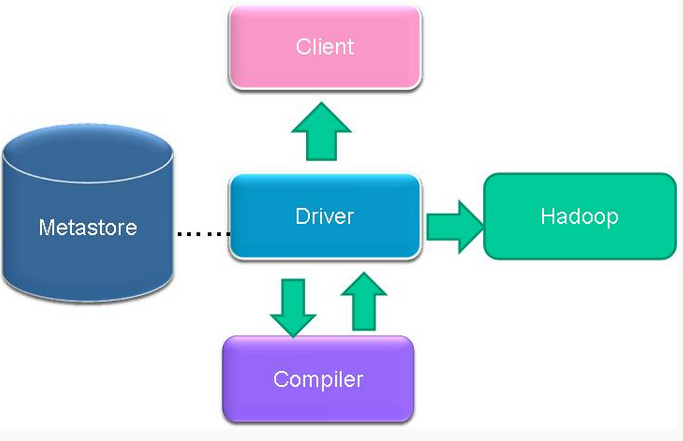
编译器将一个Hive SQL转换为操作符
操作符是Hive的最小的处理单元
每个操作符代表HDFS的一个操作或者一道MapReduce作业
Operator都是hive定义的一个处理过程
Operator都定义有:
java
protected List <Operator<? extends Serializable >> childOperators;
protected List <Operator<? extends Serializable >> parentOperators;
protected boolean done; // 初始化值为false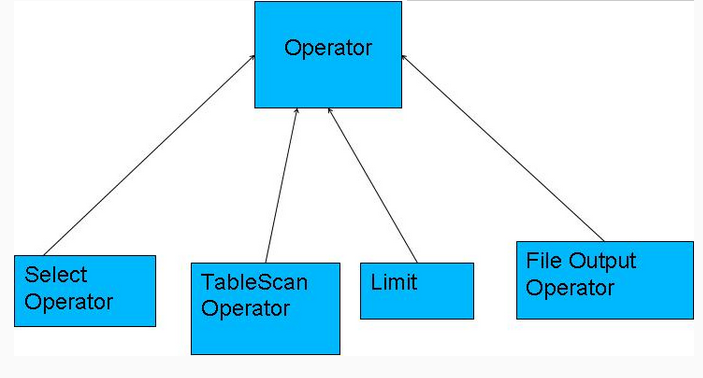
ANTLR词法语法分析工具解析hql